本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
机器人闭着眼,能把一杯水端起来,不洒吗?前两集,机器人算好了角度、稳住了电机。可它得先看清世界。这一集,讲传感器。
相机:看颜色和形状
最常见的传感器,是相机。它拍下颜色和形状,认出哪个是杯子。相机便宜、成熟,很多机器人都装。它是机器人最主要的眼睛。一款深度相机上的彩色相机,有一千两百万像素。细节很丰富,颜色很清楚。可光靠颜色,有个大问题。照片是平的。它说不清,杯子离手到底有多远。认得出,却够不着。光有颜色,还差远近!
深度:每个像素一个距离
于是有了深度相机。它给每个像素,都配一个距离。就像给照片,补上第三个数。同一台设备上,深度这一路是一百万像素。每个点,都告诉你它有多远。有意思的是,深度这一路,往往比彩色那一路粗。看清轮廓够用,不用那么细。怎么测距?一种办法,像我们的两只眼睛。两个镜头看同一处,比一比错开多少,算出远近。另一种,发一束光出去,量它跑一个来回要多久。远的回来慢,近的回来快。有了远近,机器人才算得出。手往哪伸、张多大、什么时候合拢。但深度也有软肋。太近、太远、遇上反光,都会测不准,留下一片空洞。原来深度相机,把平平的照片,变出了远近!
力与触觉:碰到之后
看得到,不等于碰得好。手一旦碰上杯子,就得靠另一类传感器:力。六轴力传感器,测得出:往哪个方向被推、被拧。前后、左右、上下,加上三个方向的扭。一款力控机械臂,每个关节里都埋了一个力矩传感器。轻轻一碰,它就察觉。有了力,机器人才知道抓得牢不牢。太用力会捏碎,太松会掉。力,就是那把分寸。更细的,是触觉。有一种触觉传感器,在软胶垫后面,藏了个小相机。胶垫被压出的花纹,相机看得一清二楚。物体滑没滑、纹理粗不粗,全摸得出来。比如抓着的东西开始往下滑,触觉能很早发现。手就赶紧,再收紧一点。
本体感觉:知道自己在哪
还有一类,最容易被忘:本体感觉。机器人对自己的感知——每个关节,转到哪了。前两集,算角度、纠正角度,靠的就是它。关节自己的编码器,不看外面,也知道姿势。原来机器人不只用眼睛,还会摸、会感觉轻重,还知道自己在哪!真干活时,这些感官要一起用。眼睛找到杯子,深度给出远近,力管住轻重。本体感觉,随时报告自己在哪。记住一句话:一种传感器,只看世界的一个侧面。合起来,才拼出完整的一幕。打开这一集的页面。同一个抓杯子的场景,你能在几种传感器视图之间切换。切到深度图,杯子会凸出来。切到力传感器,一碰上,那根力的条就跳起来。再切到触觉,看杯子表面的纹路,怎么印在胶垫上。同一时刻,每种传感器看到的都不一样。传感器都不完美。相机怕黑、深度怕反光、力传感器有噪声。所以既要校准,又要互相印证。回顾一下,三个要点。一,相机看颜色形状,但分不清远近。二,深度给每个像素一个距离;力和触觉,管接触和轻重。三,还有本体感觉,机器人知道自己在哪。所以闭着眼端水,太难了——机器人得又看、又测量、又摸!这么多传感器、这么多次试错,在真机上练,太慢了。到哪里练?下一集见!
证据与出处
每个关节 · 一款力控机械臂在每个关节都内置力矩传感器,用来估计外部接触力、感知碰撞 [O] · Franka Robotics · Franka Research 3 产品页
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
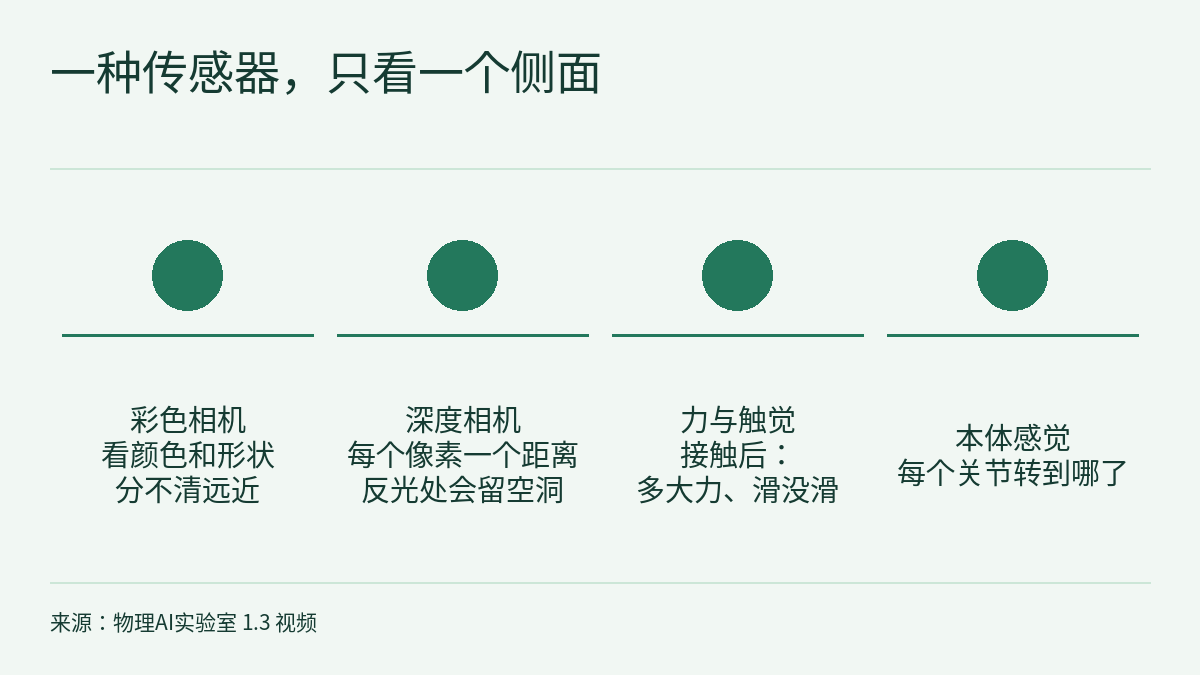
第 1.3 集的视频用“闭着眼能不能端起一杯水”讲了四类传感器:彩色相机认得出杯子,却说不清远近;深度相机给每个像素一个距离;力与触觉管碰到之后的轻重和打滑;本体感觉让机器人知道自己每个关节转到了哪。片中引了三条证据:一款深度相机(Microsoft Azure Kinect DK)的彩色相机是 1200 万像素、深度相机约 100 万像素;一款力控机械臂(Franka Research 3)每个关节都内置力矩传感器。本篇是这一集的图文课与练习,不重复文字稿,而是回到两份厂商文档,把“1200 万”和“100 万”换成各个工作模式下的实际图像尺寸,用一只假想的杯子手算它在图像里占多少像素、落不落在深度量程内、误差上限有多大,再讲清“关节力矩估计接触力”说到哪一步为止,最后手算一次夹住杯子需要多大的力。贯穿全文的规则:一个数字只属于给出它的那台设备、那个模式和那组条件。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 1.2:PID 与控制频率,手算三项输出,再把频率换成周期结尾说:要纠错,先得测得准。本课接着回答机器人靠什么测。物理AI实验室 1.1:坐标系与运动学,手算一条两连杆手臂怎样够到杯子讲过把相机读数换到底座坐标系;物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统讲过“看”既看外面也看自己。1.1 用到的 7 个自由度和 1.2 用到的 1 kHz 也出自 Franka Research 3 产品页,本课只用同一页面上关于力矩传感器的那几句。
公开小测的 5 道题附完整解析;登录后可完成三项练习:在虚构约束下给三个距离各选一个深度模式,并用数字回应“像素越多越好”;从一份虚构的抓杯日志里预测打滑从何时开始,判断深度、编码器和触觉三路读数各能说明什么,再定一个新的夹紧力;审一份把两家厂商参数拼在一起的虚构传感器方案。每项都附分步解法、常见错误与 20 分评分标准。
一、三条证据,各自说了什么
两条来自 Microsoft 的硬件规格页。Azure Kinect DK hardware specifications 页面(标注最后更新于 2021-03-18)写道:
Azure Kinect DK includes an OV12A10 12MP CMOS sensor rolling shutter sensor.
Azure Kinect DK integrates a Microsoft designed 1-Megapixel Time-of-Flight (ToF) depth camera using the image sensor presented at ISSCC 2018 .
一条来自 Franka Robotics 的产品页。Franka Research 3 页面写道:
The torque sensors integrated at each joint finely estimate external contact forces, and the fast control loop enables prompt reaction to collisions.
读这三句话要注意三点:
- 都是厂商自述。按课程的分级都属 O 级,是 Microsoft 和 Franka Robotics 对自家产品的描述,本站没有独立测量。
- 说的是传感器,不是每一帧图像。“12MP”描述的是彩色图像传感器,“1-Megapixel”描述的是深度相机。同一页面还列出了各个工作模式的分辨率,实际拿到的图像有多大,取决于选了哪个模式,第二节会逐个换算。
- 两家公司、两台设备。视频说“一款深度相机”“一款力控机械臂”,它们不是同一台机器人上的部件。两份文档里的分辨率、帧率和控制频率各属各的设备,不能拼成一台机器人的参数,也不能拿来比较谁更快。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- Azure Kinect DK 的传感器像素、工作模式、量程、误差和出厂校准都来自 Microsoft 的规格页,Franka Research 3 的关节力矩传感器、FCI 的测量项和现场校准都来自 Franka Robotics 的产品页,均属 O 级厂商自述,本站没有独立测量。Microsoft 页面标注最后更新于 2021-03-18;本课抓取时,该地址跳转到 Microsoft Learn 的 previous-versions(旧版本)目录下的同名页面。
- 第二节的像素数是本课对所列分辨率做的乘法;“杯子约占多少像素”是把视场角平均分给像素的粗算,反映的是假设等角映射时的平均每度像素;规格页没有给出镜头模型,换成针孔模型数字会不同(见第二节)。它还忽略了两台相机的相对位置,不是实测。
- 第三节的 0.40 m、1.20 m、3.00 m 和 10 mm 的任务要求、第四节的 0.35 kg、0.45 kg、μ = 0.5 和 3.6 N,都是练习用的假设,不是视频实验页或任何真实系统的参数。第四节的摩擦模型只考虑两指静摩擦托住重量,忽略了杯子的形状、加速度和手指的柔顺性。
- 67 皮秒是按视频里“光跑一个来回”的简化说法做的算术,不是 Azure Kinect DK 的测距原理或时间分辨率。
- 视频提到的软胶垫触觉传感器和六轴力传感器,本课没有引用一手材料,只沿用视频的描述;关于“反光留下空洞”,规格页也没有给出对应数字。
- 实验页上的读数是模拟值。第五节的记录表是教学建议,本文没有核对实验页的实现。
- 第六节的三个距离、30 FPS 与 15 像素的要求、队友的说法、抓杯日志的全部读数、每指 4.0 N、0.50 kg、1.5 倍余量、每指 10 N 的承受上限、μ = 0.3、团队 V 及其方案原文,都是练习用的虚构;算出的约 65、26、12 像素,约 2.6 m、约 0.408 kg、约 3.6 s、约 7.36 N、约 12.26 N 等只在这些假设和本课的等角约定下成立。日志里触觉标记与模型预测一致是编题时的设定,不是任何传感器的表现。三档判定和改写建议是教学建议,不是 Microsoft 或 Franka Robotics 的结论;纸面计算不是硬件安全验证。