
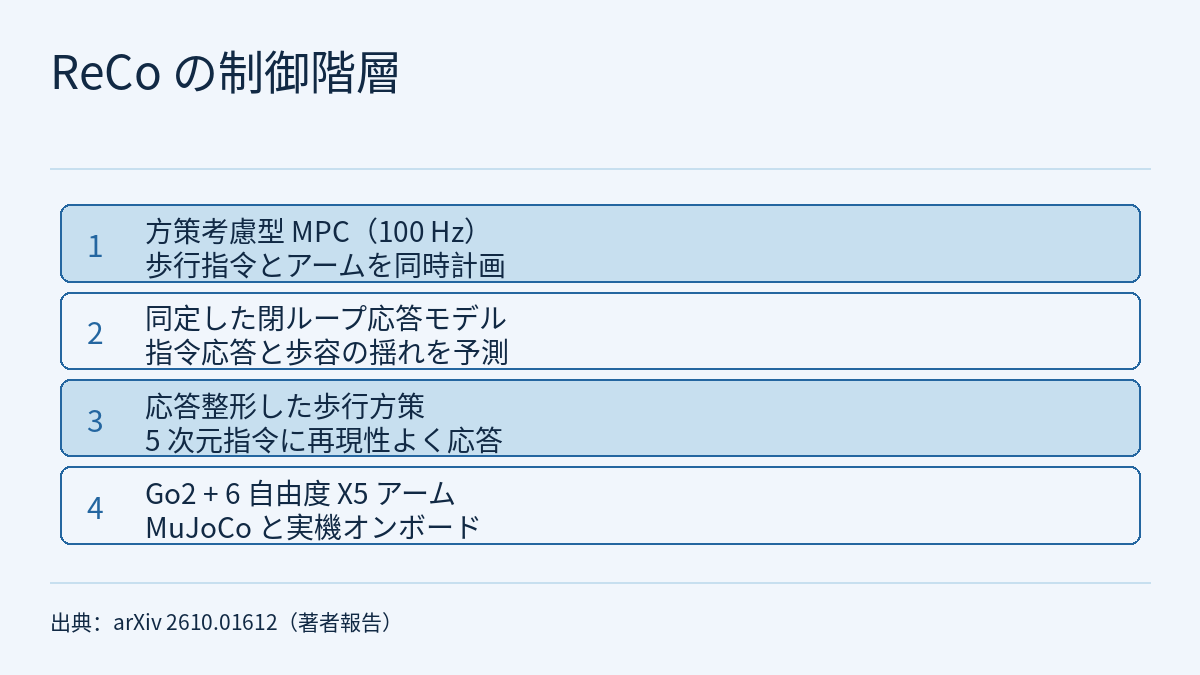
アームを載せた四脚ロボットが歩きながら操作するとき、一歩ごとの並進、ピッチの変化、歩容による揺れはすべて手先に伝わります。歩行を RL 方策に、胴体とアームの協調を MPC に任せる分担はよく使われますが、MPC が補償できるのは予測できる胴体の動きだけです。一方、学習した方策は同じ指令に対しても、歩容の位相、接地状態、負荷によって応答が変わります。シンガポール国立大学のチームによるプレプリント ReCo(arXiv 2610.01612、2026-10-01)は、このインターフェースの問題を逆側から扱います。まず方策を「予測可能に応答する」よう学習させ、次にその閉ループ応答モデルを同定して MPC に渡します。著者らは、100 回のシミュレーション実行からなるベンチマークで、位置と姿勢の RMSE がそれぞれの指標で最良のベースラインより 28.7% と 27.4% 低いと報告しています。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
問題はインターフェース:MPC は予測できる胴体の動きしか補償できない
論文は関連研究を 3 種類に分けています。純粋なモデルベース手法は正確な接触・動力学モデルに依存し、不整地ではその維持が困難です。学習型の全身制御はタスク精度と安定性を 1 つの報酬の中で両立させるため、地形、負荷、外乱が変わると再調整が必要になることがあります。RL に歩行を、MPC に胴体とアームの協調を任せるモジュール型の構成では、難しさが両者のインターフェースに移ります。MPC から見ると胴体は閉ループのサブシステムであり、その指令応答は歩容の位相、接地条件、負荷によって変わります。指令した速度や姿勢がただちに実現されると仮定すると、こうした相互作用を無視することになります。著者らはさらに、平均速度のモデルが正確でも、手先に伝わる周期的な高さと姿勢の揺れは捉えられないと指摘しています。
論文の中心的な主張は、歩行方策は頑健であるだけでなく、それに指令を出すプランナーから予測可能であるべきだ、というものです。著者らの根拠は、一定の遅れはフィードフォワードで補償できるが、変動する遅れは補償できないという点にあります。そのため、有用な予測区間にわたって低次のモデルで予測できる応答を目指しています。これは著者らの設計上の論証であり、独立に検証された結論ではありません。
手法:応答整形、閉ループ応答モデル、方策考慮型 MPC
応答整形
歩行方策は PPO で学習し、Walk These Ways の歩容条件付き指令インターフェースを使います。指令は 5 次元で、平面速度(x、y)、ヨーレート、胴体の高さ、ピッチから成り、ロールの指令はありません。「応答整形」とは、通常の歩行報酬に加える次の 4 種類の学習項を指します。
- 参照追従:各指令チャネルが臨界減衰の 2 次参照生成器(帯域幅とレート上限を設定可能)を駆動し、方策の応答がこの目標過渡応答に一致するよう報酬を与えます。比較の前に、学習中に位相と速度のビンごとの移動平均で推定した歩容周期成分を差し引きます。外乱を受けている間とその後の一定時間はこの報酬を無効にし、回復を優先させます。
- 位相の再現性:波形の振幅そのものではなく、再現可能な波形からのずれにペナルティを課します。
- 定常ゲイン:応答が落ち着いた後の指令に対する偏りを抑えます。
- ドメイン間の一貫性:環境のグループに同じ指令列と歩容位相を与えます。各グループには公称環境が 1 つあり、残りは質量、負荷、摩擦、アクチュエータ強度をランダム化します。ランダム化したインスタンスの応答を公称環境の応答に近づけます。
学習は段階的に進めます。まず歩行を確立し、その後、参照追従、一貫性ペナルティ、より広いランダム化、より強い外乱の順に加えます。
閉ループ応答モデル
3 つの速度チャネルは、それぞれ応答ゲイン k と時定数 τ を持つ 1 次モデルで表します。著者らは、学習時の 2 次参照は目標とする過渡応答を定めるだけで、実際の閉ループの次数を決めるものではないと強調しています。1 次にしたのは、予測区間での最適化をコンパクトに保つためです。高さ、ピッチ、ロールには遅れに加えて、速度に依存する歩容周期の調和項を足します。高調波は 1 ストライドと半ストライドに対応する 2 つです。このモデルは、アームが生む力やモーメントを明示的にはモデル化しません。パラメータは凍結した方策ごとにオフラインで同定します。ステップ、ランプ、チャープの指令でランダム化した各ドメインにわたって応答を励起し、多段の開ループ予測誤差を有界非線形最小二乗法でフィッティングします。同定用のデータは、後の予測実験や追従実験とは分けられています。
方策考慮型 MPC
MPC の状態は 16 次元(胴体状態 9、歩容位相、アームの 6 関節位置)、入力は 11 次元(歩行指令 5 と関節速度 6)です。コストには手先の位置・姿勢・速度の誤差に加えて、胴体姿勢、指令と応答のずれ、アーム姿勢に関する項が含まれ、関節の可動範囲、指令の範囲、一部の自己干渉距離はソフトペナルティで扱います。ソルバーは OCS2 の multiple-shooting SQP で、各更新は前回の解からウォームスタートします。論文の設定は、MPC が 100 Hz で動作し、予測区間 1.0 s、shooting ノード 67 個(間隔約 15 ms)、更新ごとに SQP 反復 3 回、RK2 積分、3 スレッドです。リファレンスマネージャーは MPC の更新レートより速く計画をサンプリングし、更新の間は歩行指令を保持します。フィードバックの遅れは、計測した状態を 1 サンプリング間隔だけ先へ伝播させてから最適化することで補償します。
ここでの 100 Hz は MPC の更新レートであり、歩行方策やモーターの周波数ではありません。提供された本文には方策の制御周波数も書かれていません。講座のフィジカルAIラボ 0.3:見る・考える・動く――3 つの周波数をそれぞれのシステムに戻すで扱ったのがまさにこの原則で、周波数はそれを報告したシステムにだけ属します。ReCo はその具体例です。計画層が予測しているのは「モーターが何をしたか」ではなく、「方策とロボットからなる閉ループが指令にどう応答するか」です。
シミュレーション・ベンチマーク:著者報告の追従結果
ベンチマークは MuJoCo(積分ステップ 2.5 ms)で行い、ロボットは 6 自由度の X5 アームを載せた Unitree Go2 です。地形は決定論的な 16 × 16 m の起伏のある高さフィールドで、標高は −0.10〜0.10 m、RMS 高さは 0.0438 m です。ワールド座標系の手先姿勢軌道 50 本はランダムに描いた経路から生成され、一部の目標は胴体を固定した状態ではアームの作業空間の外にあるため、歩行して届かせる必要があります。各軌道を公称条件と外乱条件(胴体の重心にワールド +X 方向へ 80 N を 0.1 s、8 N·s の力積)で 1 回ずつ実行し、制御器ごとに計 100 回となります。学習型の制御器はすべて Isaac Gym で学習し、MuJoCo で評価しています。ReCo の歩行方策は RTX 4090 1 枚で約 10 時間、GPU メモリ約 12 GB で収束します。講座のフィジカルAIラボ 0.4:仮想の世界で一万回練習――シミュレーションの 3 つの数字に実験条件を戻すでは Isaac Gym を紹介しましたが、そこでの学習時間とはタスク、報酬、ハードウェアがいずれも異なるため、直接比較はできません。
| 制御器 | パラダイム | 位置 RMSE (m) | 姿勢 RMSE (°) | 平均進捗 (%) | 成功 | 転倒 |
|---|---|---|---|---|---|---|
| Ma et al. | RL+MPC | 0.199 ± 0.114 | 32.7 ± 14.6 | 82.6 | 31/100 | 8/100 |
| Pure MPC | モデルベース | 0.189 ± 0.038 | 46.8 ± 14.2 | 80.5 | 19/100 | 12/100 |
| UMI on Legs | 学習 | 0.883 ± 0.832 | 81.1 ± 34.3 | 12.9 | 12/100 | 80/100 |
| RoboDuet+PP | 学習 | 0.679 ± 0.603 | 79.9 ± 29.0 | 65.7 | 42/100 | 9/100 |
| Visual WBC+PP | 学習 | 1.454 ± 1.101 | 68.2 ± 30.1 | 25.0 | 23/100 | 38/100 |
| ReCo | RL+MPC | 0.135 ± 0.091 | 23.8 ± 13.7 | 94.0 | 75/100 | 3/100 |
28.7% と 27.4% は、それぞれ位置 RMSE で最良の Pure MPC と、姿勢 RMSE で最良の Ma et al. を基準に計算した値で、同じベースラインに対する値ではありません。著者らは、100 回の実行に対する対応のある Wilcoxon 符号順位検定で、両指標ともすべてのベースラインに対して ReCo が優位だと報告しています(Holm 補正後 p < 0.001)。ReCo の成功は 75/100(公称 39/50、外乱 36/50)で、平均進捗は次点の制御器より 11.4 ポイント高く、平均胴体速度は 0.205 m/s です。これは Ma et al. の 0.217 m/s と同程度で、Pure MPC の 0.158 m/s を上回ります。外乱下では ReCo の平均位置 RMSE が 0.1326 m から 0.1371 m へ 3.4% 増え、Ma et al. は 6.4% 増えました。著者らは、これが 1 つの方向、1 つの持続時間、1 つの印加タイミングしか対象にしていないと述べています。
この表を読む際の注意点は 3 つあります。第一に、早期に失敗した実行の RMSE は記録された部分だけを対象にしているため、転倒数や進捗と合わせて読む必要があります。第二に、成功の定義は具体的です。最終進捗 97% 以上で、転倒、数値エラー、早期終了がないこと、終点の位置誤差 0.15 m 以内かつ姿勢誤差 40° 以内を少なくとも 0.5 s 連続して保つこと、さらにサンプルの少なくとも 40% が両方の許容範囲に収まることが求められます。第三に、ベースラインはすべて著者らが実装または再学習したものです。Ma et al. は同じ OCS2 基盤、予測区間、アームモデルの上で再実装され、学習型の 3 つのベースラインは公開実装から Go2–X5 向けに、学習予算をそろえて再学習されています。RoboDuet と Visual WBC は外部から胴体速度を与える必要があるため、著者らは純追従(PP)トラッカーを組み合わせました。著者ら自身も、RoboDuet+PP と Visual WBC+PP の比較では同時計画の効果と下位の制御器の違いを切り分けられていないと述べています。UMI on Legs は学習分布内の軌道では位置 0.035 m、姿勢 4.7° の RMSE を達成しますが、このベンチマークでは 80/100 回転倒しました。著者らはこれを、デモ由来の動作から独立に生成された軌道へ汎化することの難しさと解釈しています。
アブレーション:整形と同定はそれぞれ何に効き、何を犠牲にするか
著者らは 2 × 2 のアブレーションを行っています。同定を行わない場合、MPC は指令が即座に正確に実行されると仮定します。
| 応答整形 / モデル同定 | なし / なし | なし / あり | あり / なし | あり / あり(ReCo) |
|---|---|---|---|---|
| 位置 RMSE (m) | 0.257 | 0.232 | 0.166 | 0.135 |
| 姿勢 RMSE (°) | 21.7 | 24.3 | 21.5 | 23.8 |
| 手先ジャーク (m/s³) | 252.1 | 250.1 | 261.0 | 249.7 |
| 胴体ジャーク (m/s³) | 145.6 | 140.3 | 155.4 | 149.9 |
| 脚トルク RMS (N·m) | 6.41 | 6.40 | 6.46 | 6.30 |
整形だけで位置 RMSE は 0.257 m から 0.166 m に下がります(35.4%)。整形した方策にさらに同定を加えると 0.135 m になり(18.7%)、同じ同定を整形していない方策に使った場合の減少は 9.7% にとどまります。本サイトの解釈では、方策が予測可能であるほど応答モデルが役立ちます。ただし、同定によって姿勢 RMSE は悪化します。整形なしの方策では 21.7° から 24.3° へ、整形した方策では 21.5° から 23.8° へ上がりました。著者らは、チャネルごとの応答モデルが姿勢の動力学や並進と回転の連成を省いていることが原因かもしれないと推測しています。4 つの構成はいずれも、表 II の最良ベースラインより平均姿勢誤差が低くなっています。また、ReCo の胴体ジャークは 4 つの中で最小ではありません。
予測実験は「予測可能性」をより直接に確かめます。同定に使っていない 36 本の指令軌道で、整形なしと整形ありの方策それぞれに同じ構造のモデルを当てはめ、計測した状態から記録済みの指令で開ループに伝播させ、前後・左右・ヨーの速度誤差を 0.25、0.50、1.00 s で評価しました。整形により正規化予測 MSE は 0.105 から 0.042 に下がり(59.6%)、3 つの予測区間すべてで改善しています。条件をそろえた 12 通りの設定で、アームが周期的な 6 関節運動をしているとき、前後速度の残差 RMS は 0.0345 から 0.0139 m/s に下がりました。アームの動きによる残差の増加は、整形した方策で 0.0040 m/s、整形なしの方策で 0.0210 m/s です。一方、高さはドメイン間一貫性の項に含まれているにもかかわらず、その残差には同様の改善が見られませんでした。
歩容周期成分は単独でも評価されています。36 本の軌道、0.10、0.25、0.34 s の予測区間で、高さの RMSE は 6.49 mm から 3.58 mm に下がり(44.8%)、位相を意図的にずらすと予測は悪化しました。閉ループでこの成分を加えると、位置 RMSE は 5.5%、姿勢 RMSE は 6.9%、1.5〜8 Hz のトロット励起帯域における鉛直方向の追従誤差 RMS は 6.5% 下がります。
実機:オンボードで実行、証拠の強さが異なる 2 種類の実験
実機プラットフォームは Unitree Go2、ARX X5 6 自由度アーム、Jetson Orin NX オンボードコンピュータの組み合わせです。制御スタックは ROS 2 Foxy をベースにすべて機体上で動作し、並行プログラムを含むソフトウェア全体の使用率は平均で CPU 75%、RAM 43% です。
- モーションキャプチャ実験:状態推定のドリフトを排除するため、モーションキャプチャが胴体状態のフィードバックと手先の真値を提供し、8 本の軌道で評価しました。平均の位置・姿勢 RMSE は 0.0760 m と 9.93° で、整形した方策は整形なしの方策に比べてそれぞれ 29.1% と 7.4% 低くなっています。
- タスクのデモ:物品の整理、キャビネットの扉開け、ピック・アンド・プレースの手先軌道を VR 遠隔操作で事前に記録し、タスクごとに 3 回実行しました。平均の位置・姿勢 RMSE は 0.153 m と 24.9° です。これらの手先姿勢はオンボードのオドメトリとアームの順運動学から再構成されたもので、著者らはオドメトリのドリフトを独立に測っていないと明記しています。したがって、この数値は推定したワールド座標系での追従を表すものです。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者報告 [R] です。本記事が依拠した本文にはコードやデータの公開についての記載が見当たらず、本サイトもいずれの結果も再現していません。
- 主な比較は 1 つのシミュレーション・ベンチマーク(高さフィールド 1 種、軌道 50 本、外乱 1 種類)に基づきます。ベースラインはすべて著者らが再実装または再学習したもので、うち 2 つは著者らが追加した PP トラッカーにも依存しています。
- モデル同定は位置精度を改善しますが、姿勢誤差を増やします。整形は高さの再現性を改善しませんでした。著者らは、アームと胴体の連成動力学のモデル化、高さ応答の整形、知覚を用いた歩行への拡張を今後の課題に挙げています。
- 応答モデルは凍結した方策ごとに同定するため、方策を再学習したらモデルもフィッティングし直す必要があります。
- 実機のタスクデモは各 3 回だけで、手先誤差はドリフトを独立に測らずにオドメトリから再構成したものです。外部の真値があるのはモーションキャプチャ実験だけです。


