
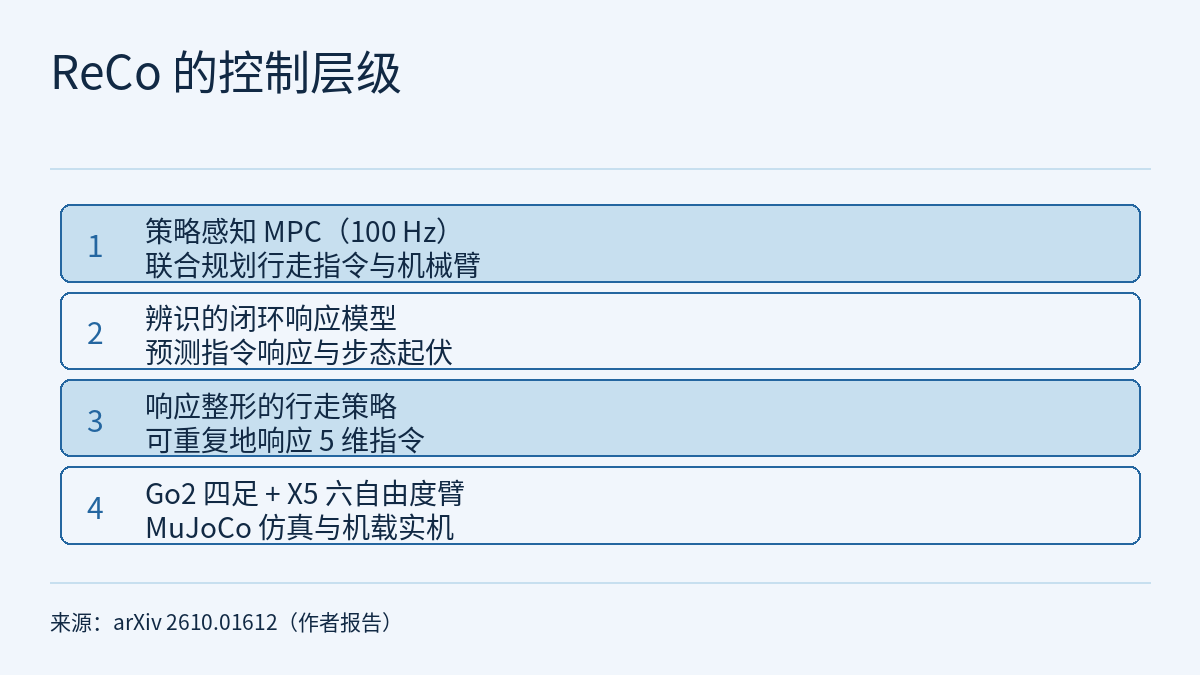
四足机器人背着机械臂边走边操作时,每一步的平移、俯仰和步态起伏都会传到末端。用 RL 策略负责行走、用 MPC 协调底座和机械臂,是一种常见的分工;但 MPC 只能补偿它预测得到的底座运动,而学出来的策略对同一条指令的响应会随步态相位、接触和负载变化。新加坡国立大学团队的预印本 ReCo(arXiv 2610.01612,2026-10-01)把这个接口问题反过来处理:先训练策略“响应得可预测”,再辨识它的闭环响应模型交给 MPC。作者报告,在 100 次仿真运行的基准上,位置和姿态 RMSE 分别比各自最佳基线低 28.7% 和 27.4%。以下数字均为作者报告 [R],本站未复现。
问题出在接口:MPC 只能补偿它能预测的底座运动
论文把相关工作分成三类:纯模型方法依赖准确的接触与动力学模型,在不平地形上难以维持;学习式全身控制把任务精度和稳定性放在同一个奖励里权衡,换地形、负载或扰动时可能要重调;模块化方案让 RL 管行走、MPC 管底座与机械臂的协调,难点则落在两者的接口上。对 MPC 来说,底座是一个闭环子系统,它对指令的响应随步态相位、接触条件和负载而变;假设“指令的速度或姿态立即实现”会忽略这些相互作用。作者还指出,即使平均速度模型准确,也会漏掉传到末端的周期性高度与姿态起伏。
论文的核心主张是:行走策略不仅要鲁棒,还要能被指挥它的规划器预测。作者的理由是,恒定的延迟可以用前馈补偿,变化的延迟则不能;因此他们追求的是一个低阶模型能在有用时域内预测的响应。这是作者的设计论证,不是独立验证的结论。
方法:响应整形、闭环响应模型、策略感知 MPC
响应整形
行走策略用 PPO 训练,沿用 Walk These Ways 的步态条件指令接口。指令是 5 维的:平面速度(x、y)、偏航角速度、机身高度和俯仰;没有横滚指令。“响应整形”指在常规行走奖励之外加入的四类训练项:
- 参考跟踪:每个指令通道驱动一个临界阻尼的二阶参考生成器(带宽和速率上限可设),奖励策略的响应贴合这条目标暂态。比较前先减去训练中按相位和速度分箱、用滑动均值估计的步态周期分量。外部扰动期间及其后一段时间,这项奖励被关闭,让恢复优先。
- 相位可重复:惩罚偏离可重复波形的部分,而不是惩罚波形幅度本身。
- 稳态增益:抑制响应稳定后对指令的偏差。
- 跨域一致:一组环境接收相同的指令序列和步态相位,组内有一个名义环境,其余实例随机化质量、负载、摩擦和执行器强度;随机化实例的响应被要求接近名义环境。
训练分阶段:先学会行走,再依次加入参考跟踪、一致性惩罚、更大的随机化范围和更强的扰动。
闭环响应模型
三个速度通道各用一个一阶模型描述:响应增益 k 和时间常数 τ。作者特别说明,训练用的二阶参考只规定目标暂态,并不决定实际闭环的阶数;用一阶是为了让时域优化保持紧凑。高度、俯仰和横滚在滞后之外,再加一个随速度变化的步态周期谐波项,取步幅和半步幅两个谐波。模型不显式建模机械臂造成的力和力矩。参数针对每个冻结的策略离线辨识:用阶跃、斜坡和扫频指令在随机化的各个域上激励,以有界非线性最小二乘拟合多步开环预测误差;辨识数据与后文的预测和跟踪实验分开。
策略感知 MPC
MPC 的状态是 16 维(9 维底座状态、步态相位、6 个机械臂关节位置),输入是 11 维(5 维行走指令加 6 个关节速度)。代价包括末端位置、姿态和速度误差,以及底座姿态、指令与响应差异和机械臂姿态等项;关节限位、指令限位和部分自碰撞距离以软惩罚处理。求解器是 OCS2 的 multiple-shooting SQP,每次更新从上一次的解热启动。论文给出的配置是:MPC 以 100 Hz 运行,时域 1.0 s,67 个 shooting 节点、间隔约 15 ms,每次更新做 3 次 SQP 迭代,RK2 积分,3 个线程。参考管理器以高于 MPC 更新率的频率对计划采样,在两次更新之间保持行走指令;反馈延迟的补偿方式是先把测得状态前推一个采样间隔再优化。
这里的 100 Hz 是 MPC 的更新率,不是行走策略或电机的频率,所给正文也没有写出策略的控制频率。课程物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统讲的正是这条规则:一个频率只属于给出它的那个系统。ReCo 是一个具体例子:规划层预测的不是“电机做了什么”,而是“策略加机器人这个闭环会怎样响应指令”。
仿真基准:作者报告的跟踪结果
基准在 MuJoCo 中进行(积分步长 2.5 ms),机器人是 Unitree Go2 加六自由度 X5 机械臂。地形是确定性的 16 × 16 m 起伏高度场,高程在 −0.10 到 0.10 m 之间,RMS 高度 0.0438 m。50 条世界坐标系下的末端位姿轨迹由随机绘制的路径生成,部分目标在底座不动时超出机械臂工作空间,必须靠行走才够得到。每条轨迹分别在名义条件和推扰条件下各跑一次(在底座质心沿世界 +X 方向施加 80 N、持续 0.1 s,即 8 N·s 冲量),每个控制器共 100 次运行。所有学习式控制器在 Isaac Gym 中训练、在 MuJoCo 中评测;ReCo 的行走策略在一块 RTX 4090 上约 10 小时收敛,显存占用约 12 GB。课程物理AI实验室 0.4:在虚拟世界练一万遍,给三个仿真数字补上实验条件介绍过 Isaac Gym;那里的训练耗时与这里的任务、奖励和硬件都不同,不能直接比较。
| 控制器 | 范式 | 位置 RMSE (m) | 姿态 RMSE (°) | 平均进度 (%) | 成功 | 跌倒 |
|---|---|---|---|---|---|---|
| Ma et al. | RL+MPC | 0.199 ± 0.114 | 32.7 ± 14.6 | 82.6 | 31/100 | 8/100 |
| Pure MPC | 模型方法 | 0.189 ± 0.038 | 46.8 ± 14.2 | 80.5 | 19/100 | 12/100 |
| UMI on Legs | 学习 | 0.883 ± 0.832 | 81.1 ± 34.3 | 12.9 | 12/100 | 80/100 |
| RoboDuet+PP | 学习 | 0.679 ± 0.603 | 79.9 ± 29.0 | 65.7 | 42/100 | 9/100 |
| Visual WBC+PP | 学习 | 1.454 ± 1.101 | 68.2 ± 30.1 | 25.0 | 23/100 | 38/100 |
| ReCo | RL+MPC | 0.135 ± 0.091 | 23.8 ± 13.7 | 94.0 | 75/100 | 3/100 |
28.7% 和 27.4% 分别是相对位置 RMSE 最佳的 Pure MPC 和姿态 RMSE 最佳的 Ma et al. 计算的,不是相对同一个基线。作者报告,100 次运行上的配对 Wilcoxon 符号秩检验在两项指标上都支持 ReCo 优于每个基线(Holm 校正后 p < 0.001)。ReCo 的成功为 75/100(名义 39/50、推扰 36/50),平均进度比次优控制器高 11.4 个百分点,平均底座速度 0.205 m/s,与 Ma et al. 的 0.217 m/s 相近、高于 Pure MPC 的 0.158 m/s。推扰下 ReCo 的平均位置 RMSE 从 0.1326 m 升到 0.1371 m(3.4%),Ma et al. 升高 6.4%;作者说明这只覆盖一个方向、一种持续时间和一种施加时机。
读这张表要注意三点。第一,RMSE 对提前失败的运行只统计已记录的部分,要和跌倒数、进度一起看。第二,成功的定义很具体:最终进度至少 97%,没有跌倒、数值故障或提前终止,终点位置和姿态误差分别在 0.15 m 和 40° 以内并连续保持至少 0.5 s,且至少 40% 的采样同时满足两项容差。第三,基线都由作者实现或重训:Ma et al. 是在同一 OCS2 框架、时域和机械臂模型上重新实现的,三个学习式基线按公开实现为 Go2–X5 重训并匹配训练预算;RoboDuet 和 Visual WBC 需要外部给出底座速度,作者为它们配了一个纯跟踪(PP)控制器。作者自己也说明,RoboDuet+PP 和 Visual WBC+PP 这两组比较没有把“联合规划”与底层控制器的差异分离开。UMI on Legs 在其训练分布内的轨迹上位置和姿态 RMSE 为 0.035 m 和 4.7°,在本基准上却 80/100 跌倒,作者把这解释为从示教动作泛化到独立生成轨迹的困难。
消融:整形和辨识各起什么作用,代价在哪里
作者做了 2 × 2 消融。不做辨识时,MPC 假设指令立即、准确地执行。
| 响应整形 / 模型辨识 | 否 / 否 | 否 / 是 | 是 / 否 | 是 / 是(ReCo) |
|---|---|---|---|---|
| 位置 RMSE (m) | 0.257 | 0.232 | 0.166 | 0.135 |
| 姿态 RMSE (°) | 21.7 | 24.3 | 21.5 | 23.8 |
| 末端 jerk (m/s³) | 252.1 | 250.1 | 261.0 | 249.7 |
| 底座 jerk (m/s³) | 145.6 | 140.3 | 155.4 | 149.9 |
| 腿部力矩 RMS (N·m) | 6.41 | 6.40 | 6.46 | 6.30 |
只做整形,位置 RMSE 从 0.257 m 降到 0.166 m(35.4%)。在整形过的策略上再做辨识,误差降到 0.135 m(18.7%);同样的辨识用在未整形策略上只降 9.7%。本站的解读是:策略越可预测,响应模型越有用。但辨识让姿态 RMSE 变差:未整形策略从 21.7° 升到 24.3°,整形策略从 21.5° 升到 23.8°。作者推测原因可能是按通道建模的响应模型忽略了姿态动力学以及平移与旋转的耦合。四种配置的平均姿态误差都低于表 II 中的最佳基线。ReCo 的底座 jerk 也不是四者中最低的。
预测实验更直接地检验“可预测”。在 36 条未参与辨识的指令轨迹上,分别为未整形和整形策略拟合相同结构的模型,从测量状态出发、按记录的指令开环前推,评估前向、侧向和偏航速度在 0.25、0.50、1.00 s 的误差。整形把归一化预测 MSE 从 0.105 降到 0.042(59.6%),三个时域都有改善。在 12 组匹配条件下,机械臂做周期性六关节运动时,前向速度残差 RMS 从 0.0345 降到 0.0139 m/s;机械臂运动带来的残差增量,整形策略为 0.0040 m/s,未整形策略为 0.0210 m/s。高度残差则没有同样的改善,尽管高度也在跨域一致项里。
步态周期分量单独评估:在 36 条轨迹、0.10、0.25、0.34 s 时域上,高度 RMSE 从 6.49 mm 降到 3.58 mm(44.8%);故意错开相位会让预测变差。闭环中加入这一分量,位置 RMSE 降 5.5%,姿态 RMSE 降 6.9%,1.5–8 Hz 小跑激励频段内的竖直跟踪误差 RMS 降 6.5%。
实机:机载运行,两类实验的证据强度不同
实机平台是 Unitree Go2、ARX X5 六自由度机械臂和 Jetson Orin NX 机载计算机,控制栈基于 ROS 2 Foxy,全部在机上运行;整套软件(含并发程序)平均占用 75% CPU 和 43% 内存。
- 动作捕捉实验:为了排除状态估计漂移,由动作捕捉提供底座状态反馈和末端真值,共 8 条轨迹。平均位置和姿态 RMSE 为 0.0760 m 和 9.93°;整形策略相对未整形策略分别降低 29.1% 和 7.4%。
- 任务演示:整理物品、开柜门、取放三项任务的末端轨迹事先用 VR 遥操作录好,每项跑 3 次,平均位置和姿态 RMSE 为 0.153 m 和 24.9°。这些末端位姿由机载里程计和机械臂正运动学重建,作者明确说明没有独立测量里程计漂移,所以这组数字描述的是在估计的世界坐标系中的跟踪。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R];本站依据的正文中没有看到代码或数据发布的说明,也未复现任何结果。
- 主要对比在一个仿真基准上(单一高度场、50 条轨迹、一种推扰);所有基线由作者重新实现或重训,其中两个还依赖作者添加的 PP 控制器。
- 模型辨识改善了位置精度,但让姿态误差变大;整形没有改善高度的可重复性。作者把建模机械臂–底座耦合动力学、整形高度响应和扩展到感知式行走列为未来工作。
- 响应模型要为每个冻结的策略重新辨识;策略重训后,模型需要重新拟合。
- 实机任务演示每项只有 3 次,末端误差基于里程计重建,不含独立的漂移测量;只有动作捕捉实验提供了外部真值。


