
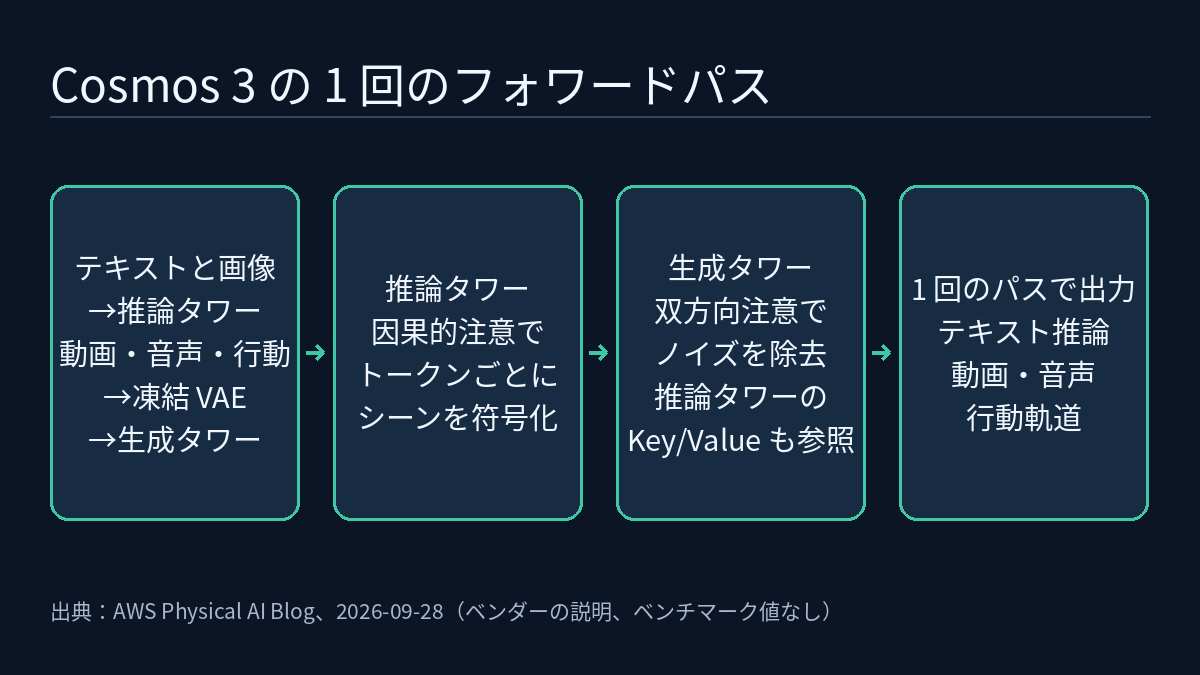
NVIDIA が 2026 年 5 月に公開した Cosmos 3 は、それまで別々だった Cosmos Predict、Cosmos Transfer、Cosmos Reason の 3 モデルを 1 つに統合し、1 回の推論呼び出しでシーンの推論、将来の映像、ロボットの行動をまとめて返します。AWS Physical AI Blog の 2026-09-28 の記事(証拠レベル [O]、ベンダーの一次情報)は、その 2 タワー構成を解説し、データ整備からエッジ展開までの AWS リファレンスアーキテクチャとインスタンス選定を示しています。エンジニアリングチームにとって最も役立つのは、インスタンス選定に付いた検証条件です。完全な Nano と Super のチェックポイントは現時点で BF16 でテストされていること、H100 上の 8 GPU の SFT が NVIDIA のテスト済み構成であること、H200 のマルチノードのポストトレーニングはその H100 のレシピと比較してベンチマークすべきこと、B200 では性能を論じる前にシャーディングまたは複製の配置を検証すべきことが書かれています。
3 つのモデルから 1 つのモデルへ
記事によれば、従来の Cosmos では 3 つの独立したモデルを組み合わせる必要があり、それぞれに推論呼び出し、モデル読み込みのオーバーヘッド、サービング基盤がありました。従来のフィジカルAIのパイプラインも専用モデルを直列につなぎます。視覚言語モデルがシーンをテキストで記述し、そのテキストで動画生成モデルを条件付け、生成されたフレームを方策ネットワークに渡してモーター指令を出力します。記事は、受け渡しのたびに文脈が失われ、レイテンシが増えると主張しています。例として挙げられているのは倉庫でのピッキングです。VLM が荷物を「コンベア上の変形した段ボール箱」と記述すると、表面の曲率や隣の物体との距離はその一文の中で失われます。Cosmos 3 は、形状の知覚、把持の安定性の推論、軌道の生成、指令の出力を 1 回のフォワードパスで行い、途中でテキストというボトルネックを経由しないと説明されています。NVIDIA はこれをフィジカルAI向けの初の完全オープンな omni モデルと呼んでいます。
記事が挙げる機能は、視覚言語理解(テキスト、画像、動画、音声)、世界モデル(将来の状態を動画として生成)、世界行動モデル(関節角やグリッパー位置など実行可能な軌道を出力)、順動力学(行動を条件として将来の観測を予測)、逆動力学(デモンストレーションから行動を推定)、方策モデル(観測とタスクプロンプトから行動列を予測)です。3 つのバリアントは次のとおりです。
| バリアント | パラメータ数 | 記事が示す典型的な用途 |
|---|---|---|
| Cosmos 3 Super | 64B(32B Reasoner + 32B Generator) | 最高忠実度のシミュレーション、研究、オフライン生成 |
| Cosmos 3 Nano | 16B(8B Reasoner + 8B Generator) | 本番推論、コストと品質のバランス |
| Cosmos 3 Edge | 4B | ロボット上でのオンデバイス推論、低レイテンシの制御ループ |
2 つのタワー:推論タワーと生成タワー
Cosmos 3 は Mixture-of-Transformers(MoT)を採用し、自己回帰による推論と拡散ベースの生成を、共同学習される 1 つのモデルにまとめています。記事が説明するデータの流れは次のとおりです。
- 入力は 2 系統に分かれます。テキストと ViT で符号化した画像パッチは自己回帰のサブシーケンスとして推論タワーへ、動画・音声・行動は凍結された VAE エンコーダで潜在表現に圧縮されて拡散タワーへ送られます。3D マルチモーダル RoPE(MRoPE)がすべてのトークンを共通の物理的な時間軸にそろえ、FPS 変調で異なるフレームレートに対応します。
- 推論タワーは、視覚トークンと言語トークンを因果的自己注意で左から右へ処理し(ViT は DeepStack による多層集約を使用)、シーン推論を符号化した密な表現を出力します。
- 生成タワーは双方向注意でトークン全体を処理し、反復的なノイズ除去によって潜在表現を動画、同期した音声、行動軌道へと復元します。
- デュアルストリームの結合注意:拡散トークンは両タワーの Key/Value を連結したものに注意を向けるため、生成される各ピクセル、音声サンプル、行動座標はすべて推論結果を条件とします。自己回帰トークンは因果的で自己完結したままです。
- 1 回のフォワードパスで、テキスト推論、動画、音声、行動軌道(関節角、グリッパー指令、6-DoF 経路)を同時に出力します。
本サイトの講座第 0.1 回で扱った「見る・考える・動く」のループに当てはめると、この設計は「考える」と「動く」の間のモデル間の受け渡しをなくすものです。ただし記事が説明しているのは構造だけで、複数モデルのパイプラインと比べたレイテンシや成功率の数値は示されていません。「受け渡しで情報が失われる」というのは著者の論証であり、測定結果ではありません。
AWS 上の 4 段階と 2 つのサービング方式
リファレンスアーキテクチャはライフサイクル全体をカバーしています。
- データ整備:生の動画、LiDAR、カメラのデータを Amazon S3 に集め、AWS Batch 上の Cosmos Curator でフィルタリング、重複除去、品質スコアリングを行います。Cosmos Dataset Search は Amazon EKS 上に Milvus ベクトル DB と Cosmos-embed NIM とともにデプロイし、セマンティック検索に使います。
- ポストトレーニング:Amazon SageMaker HyperPod でドメイン SFT を行います。行動のポストトレーニングでは、行動ヘッドを特定のロボットの関節構成、グリッパーのマッピング、6-DoF のエンドエフェクタ経路に合わせます。記事は、モデルに組み込まれた順動力学を使って実機展開前に閉ループテストができるとしています。
- 本番推論:Amazon EKS と Cosmos NIM、または Amazon SageMaker JumpStart。
- エッジ:Cosmos 3 Edge(4B)を AWS IoT Greengrass 経由で NVIDIA Jetson に展開し、OTA でモデルを更新します。エッジのセンサーデータは S3 に戻り、再学習に使われます。
2 つのサービング方式の違いは明確です。EKS と NIM の組み合わせは、制御ループやリアルタイムのシーン理解など低レイテンシのワークロード向けです。Karpenter が必要に応じて GPU ノードを用意し、ノードは複数のアベイラビリティーゾーンに配置され、新しい NIM イメージはヘルスチェックを通過してからトラフィックを受けます。GPU 使用率、キューの深さ、リクエストごとのレイテンシは CloudWatch と Prometheus に送られ、水平スケーリングに使われます。Kubernetes をすでに運用していて、バッチ処理や GPU のビンパッキングを自分で制御したいチームに向いています。JumpStart はマネージドな方式です。記事によれば、2026 年 8 月時点で Edge、Nano、Super の 3 バリアントすべてが利用できます。リアルタイムエンドポイントが対話的なリクエストを、非同期エンドポイントが時間のかかる世界生成ジョブをクライアント側のタイムアウトなしで処理し、HyperPod で作成して SageMaker Model Registry に登録したチェックポイントを同じ種類のエンドポイントにデプロイできます。
セキュリティについて記事が明記しているのは次の点です。すべての S3 バケットを SSE-KMS で暗号化する。S3/ECR 用の VPC エンドポイントを設定し、パブリックインターネットを経由しない。HyperPod クラスターと EKS ノードグループはプライベートサブネットに置く。IAM ロールはデータ整備、学習、推論、エッジの段階ごとに分ける。エッジデバイスはデバイス証明書で認証し、証明書を定期的にローテーションし、OTA では署名済みのモデルアーティファクトだけを受け付ける。顧客データや安全上重要なデータには PrivateLink を使い、モデルアーティファクトの昇格ごとに CloudTrail のログを有効にする。
インスタンス選定:記事自身が付けている条件
記事は、完全な Nano と Super のチェックポイントは現時点で BF16 でテストされていると明記しています。Cosmos3 Generator NIM には別途 FP8 のプロファイルがあり、メモリと並列化の要件が異なります。
| ワークロード | 推奨インスタンス | 記事の説明 |
|---|---|---|
| Nano の単一 GPU 推論 | g7e.2xlarge または p5.4xlarge | RTX PRO 6000 96 GB または H100 80 GB を 1 基。完全なチェックポイントは BF16、FP8 は対応する NIM プロファイルで使用可能 |
| Nano のスループット重視推論またはポストトレーニング | p5.48xlarge | H100 を 8 基。NVIDIA がテストした 8 GPU の SFT 構成と一致 |
| Super のフルモデル推論 | p5e.48xlarge または p5.48xlarge | TP8 を前提にせず、ランタイムが推奨する HSDP、CFG、Ulysses の配置を使う。H200 はメモリに余裕がある |
| マルチノードのポストトレーニング | p5en.48xlarge | H200 を 8 基と EFAv3。NCCL の集団通信に適するが、NVIDIA がテストした H100 のレシピと比較してベンチマークすること |
| Blackwell での推論または学習 | p6-b200.48xlarge | B200 を 8 基、GPU メモリ合計 1,432 GiB。性能を論じる前にランタイムのシャーディングまたは複製の配置を検証すること |
表中の条件は、それぞれ書き方が異なります。記事が NVIDIA のテスト済みと明示しているのは H100 上の 8 GPU の SFT 構成です。H200 のマルチノードのポストトレーニングはその H100 のレシピと比較してベンチマークすべきとされ、B200 では性能を論じる前にランタイムのシャーディングまたは複製の配置を検証すべきとされています。FP8 は対応する NIM プロファイルで使用できますが、そのテスト範囲は記事に書かれていません。BF16 のテストを誰が行ったのか、ほかの構成がテストされたかどうかも記事は説明していません。エッジについては、本サイトの「フロンティア・レーダー特集|エッジとリアルタイム性」が、オンデバイスのロボット制御に向けた Cosmos 3 Edge のポストトレーニングに関する NVIDIA のチュートリアルと、その他のレイテンシのデータをまとめています。HyperPod での VLA ポストトレーニングの知見は「フロンティア・レーダー特集|学習と自己改善」を参照してください。
制約と注意点
- これは AWS のベンダーブログ([O])で、モデルの能力に関する記述は NVIDIA の説明にもとづきます。記事には品質、レイテンシ、成功率のベンチマーク値が一切なく、本記事が依拠する資料にも独立した評価はありません。「初の完全オープンな omni モデル」は NVIDIA 自身の主張です。
- 記事の構造解説の小見出しに誤りがあります。第 1 項は入力の分岐を説明していますが、第 2 項と同じ「Autoregressive Tower (Reasoning)」という見出しになっています。本記事では内容から第 1 項を入力処理と解釈しました。
- Edge については合計 4B というパラメータ数だけが示され、Nano や Super のように Reasoner と Generator の内訳は示されていません。
- 「展開前に順動力学で方策を閉ループ検証する」というのは、モデル自身の予測の中での検証です。それが実機評価の代わりになるかどうかは、記事では論じられていません。
- 記事末尾の GitHub リポジトリやサンプルコードへのリンクは、本記事が依拠する資料に含まれていないため引用していません。GPU の値下げ幅や Spot による節約率などコストに関する記述も収録していません。価格は AWS の公式料金ページで確認してください。
リンク
- AWS Physical AI Blog:NVIDIA Cosmos 3 on AWS: Omnimodal World Models for Physical AI(2026-09-28)
- フィジカルAIラボ 0.1:フィジカルAIとは何か、会話するAIから手を動かすAIへ(「見る・考える・動く」のループ)
- フィジカルAIラボ講座の概要(L3 の計画に「Cosmos による世界モデルのデータ生成」の回があります)
- フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか
- フロンティア・レーダー特集|学習と自己改善:VLA ポストトレーニングの 3 つの段階とオンライン RL の task collapse


