
プレプリント Phoenix(arXiv 2611.24938、2026-11-18、著者は中国科学院自動化研究所、Anyverse Dynamics、清華大学、シンガポール国立大学、復旦大学)は、世界行動モデル(WAM)がどのような視覚表現を予測すべきかを扱った研究です。WAM は未来の観測とロボットの動作を同時に予測します。著者は、動画の再構成のために学習した潜在表現は外観の情報を保つものの、操作に必要な空間関係や物体の状態変化を明示的には重視していないと述べています。Phoenix はまず幾何と時空間の意味を 1 つのエンコーダに蒸留し、その特徴を生成用の場面潜在表現に圧縮して、Wan VAE の外観潜在表現や動作チャンクと一緒に予測します。本記事では論文の構造、表現のアブレーション、6 つのベンチマークの主な結果、データ効率の実験を順に整理し、評価のサンプリングの範囲に収まる差がどれかを示します。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
表現の 3 段階:蒸留エンコーダ、CS-VAE、同時予測
Phoenix Encoder は ViT-L/16 の生徒ネットワークで、VGGT-Ω に含まれる DINOv3 バックボーンから初期化し、凍結した 2 つの教師から学びます。幾何の経路では VGGT-Ω のフレームごとの中間特徴とビュー間の中間特徴に合わせ、さらに信頼度で重み付けした対数深度の損失で教師が生成した深度に合わせるので、正解の深度ラベルは要りません。時空間の意味の経路では V-JEPA 2.1-L がクリップ全体を見て、生徒は全フレームに同じ空間マスクをかけた入力だけを受け取り、予測器がその出力を教師の特徴空間に写します。2 つの教師からの更新は交互に行い、方策の学習と運用には最終的にバックボーンの EMA 重みだけを残します。入力 256 × 256 では、各フレームの特徴は 16 × 16 × 1024 です。
CS-VAE(causal-semantic VAE)は、空間のパッチ格子を保ったまま、これらのフレームごとの特徴をチャンネル方向と時間方向に圧縮します。9 フレームの特徴が 3 つの潜在時間ステップになり、各ステップは 48 チャンネルです。最初の潜在表現 z0 はフレーム 0 だけに依存し、以降の潜在表現はそれぞれ自分の時間ステップで終わる因果的な窓を集約します。目的関数は特徴再構成の MSE とコサイン損失に、事後分布を標準ガウス分布に近づける KL 項を加えたものです。CS-VAE の学習中、Phoenix Encoder は凍結されています。
同時予測:48 チャンネルの場面潜在表現と 48 チャンネルの Wan VAE 外観潜在表現をチャンネル方向に連結し、96 チャンネルの視覚表現にします。Wan2.2-TI2V-5B から初期化した動画拡散 Transformer と、ランダムに初期化した動作拡散 Transformer を、各層で非対称マスク付きの結合アテンションでつなぎます。現在フレームの視覚トークンは互いにだけ注意を向け、未来の視覚トークンはすべての視覚トークンに注意を向けますが動作は見ません。動作トークンはすべての視覚トークンと動作トークンに注意を向けます。動作の経路はさらに T5 の指示文埋め込み、ロボットの状態、アームごとに割り当てた soft prompt トークンにクロスアテンションします。学習は flow matching で、損失は 0.5 × 外観項 + 0.5 × 特徴項 + 動作項です。各動作チャンクは連続する 32 制御ステップにわたり、推論では 10 ステップのデノイズを使います。
フィジカルAIラボ 3.2 では世界モデルを x̂[t+1] = W(x[0:t], c[t]) と書き、Cosmos は未来の動画を予測しました。Phoenix は別の設計で、予測対象に外観潜在表現のほか、視覚基盤モデルから蒸留した場面の特徴が加わり、動作と同じデノイズ過程で生成されます。上のアテンションマスクに従うと、未来フレームの予測は動作トークンを読まず、動作の生成は視覚トークンを読めます。
39,306 時間のデータと 3 段階の学習
著者は 54,413 時間のデータをフィルタリングして 39,306 時間を残しました。時間の割合では、ロボットのデモが 31.09%、一人称視点動画が 63.58%、UMI データが 5.33% です。学習は 3 段階で、(a) フィルタリング後の全データで Phoenix Encoder を蒸留し、(b) 同じデータで CS-VAE を学習し、(c) ロボットのデモだけで WAM を事前学習します。機体をまたぐ学習では、ロボットの状態と動作を共通の 80 次元インターフェースに写し、アーム ID ごとに 8 個の学習可能な soft prompt トークンを選びます。WAM の事前学習では Phoenix Encoder、CS-VAE、動画 VAE を凍結し、動画と動作のエキスパート、状態の射影、soft prompt だけを更新します。グローバルバッチサイズは 4,480 で、各データ規模で 1 エポック学習します。その後、ベンチマークごとに対象タスクのデモで個別に事後学習し、既定は 25k ステップです。
本サイトで以前紹介した SWAM も数万時間の動画とデモで WAM を事前学習しましたが、変えていたのはキャプション、動作ラベル、データの混合比でした。Phoenix のアブレーションはデータを固定して視覚表現そのものを変えており、2 つの論文が答えている問いは異なります。
表現のアブレーション:エンコーダを変える、圧縮方法を変える
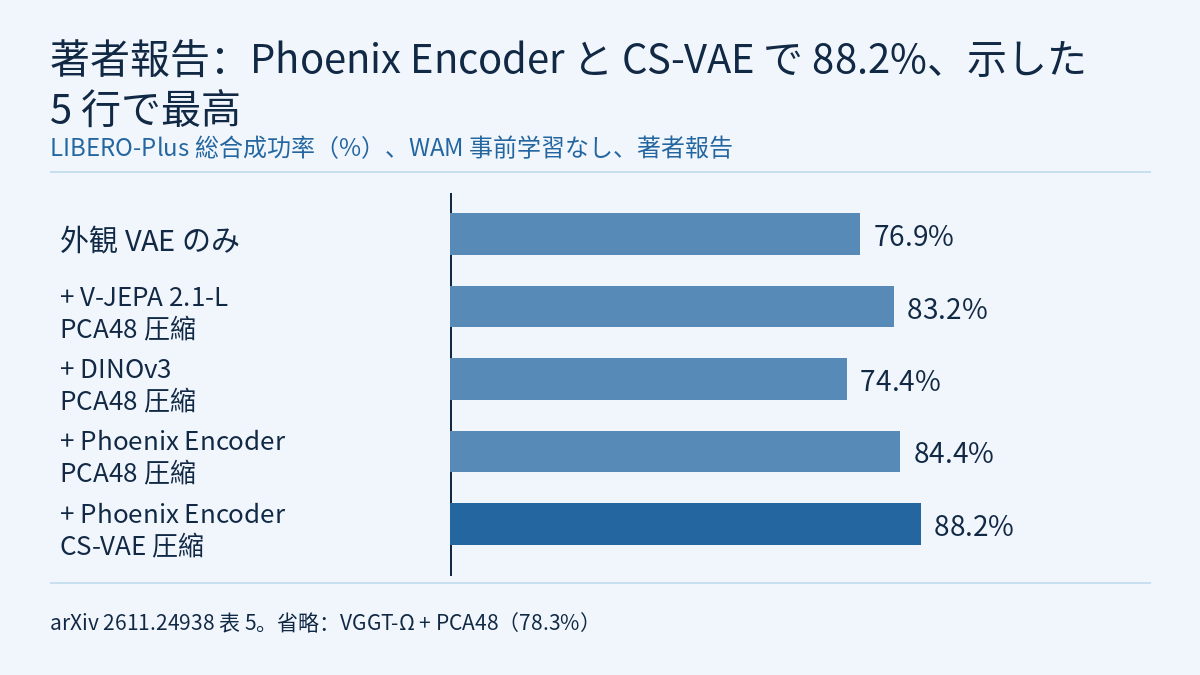
論文の表 5 は LIBERO-Plus で視覚表現を比べています。どの設定も外観 VAE の経路を残し、WAM の事前学習はせずにそのまま事後学習します。最初の 5 行は圧縮を PCA48 に固定してエンコーダだけを変え、最後の行は Phoenix Encoder を固定して PCA48 を CS-VAE に置き換えています。
| 外観の経路に加えるエンコーダ | 圧縮 | Robot 初期化の摂動 | 総合成功率 |
|---|---|---|---|
| なし(外観 VAE のみ) | — | 69.0% | 76.9% |
| VGGT-Ω | PCA48 | 60.4% | 78.3% |
| V-JEPA 2.1-L | PCA48 | 72.3% | 83.2% |
| DINOv3 | PCA48 | 66.2% | 74.4% |
| Phoenix Encoder | PCA48 | 70.2% | 84.4% |
| Phoenix Encoder | CS-VAE | 90.2% | 88.2% |
圧縮が同じ条件では、Phoenix Encoder は 84.4% で、最も強い代替エンコーダ V-JEPA 2.1-L の 83.2% と、初期化元の DINOv3 の 74.4% を上回ります。表からは、DINOv3 の特徴を加えただけの設定(74.4%)が外観 VAE のみ(76.9%)より低いことも読み取れます。Phoenix Encoder を固定して PCA48 を CS-VAE に置き換えると、総合成功率は 84.4% から 88.2% に上がり、7 種類の摂動のうち 6 種類で改善します。上がり幅が最も大きいのはロボットの初期化の摂動で、70.2% から 90.2% です。完全な構成は VAE のみより 11.3 ポイント高くなっています。
著者は凍結した特徴のプロービングも行っています(表 4、ScanNet++ のサブセット、全エンコーダで同じプローブヘッドと学習スケジュール)。Phoenix Encoder の平均順位は 1.80 で、カメラの動きから未来の特徴を直接予測する項目では Global R@1 が 34.42% で 1 位、残り 4 項目では 2 位です。DINOv2-L の平均順位は 2.60 です。
6 つのベンチマークの主な結果
完全なモデルは WAM の事前学習を経たうえで、ベンチマークごとに個別に事後学習しています。下の表は論文の表 1〜3 と付録の表 S1、S2 の一部です。評価規模は付録のベンチマーク説明によります。
| ベンチマーク | 設定と評価規模 | Phoenix | 論文の表にある比較対象の一部 |
|---|---|---|---|
| LIBERO-Plus | 7 種類の摂動、評価インスタンス 10,030 件 | 94.8% | InternW0-Δ 92.8%、π0.5 85.7% |
| RoboTwin 2.0 C2R | 双腕 50 タスク、クリーンなデモで学習しランダム化シーンで評価、計 5,000 エピソード | 72.4% | InternW0-Δ 71.9%、π0.5 46.0% |
| Bench2Dex | タスクと機体の組み合わせ 26 設定、アームとハンドの組み合わせ 12 種、方策ごとに 5,200 エピソード | 45.6% | GR00T N1.5 28.3%、π0.5 27.2% |
| RoboDojo-RealWorld | 実機 ARX X5、Piper、Piper X、18 タスク、方策ごとに 180 試行 | 30.0% | OpenWAM-α 24.4%、π0.5 12.8% |
| LIBERO-Pro | 4 種類の摂動設定、40 タスク、タスクごとに 50 エピソード | 66.5% | Continuous Reasoning 64.0% |
| RoboCasa-GR1 | 双腕と器用なハンドを持つ Fourier GR1、24 タスク、計 1,200 エピソード | 82.7% | CF-WAM 82.5% |
LIBERO-Plus の 7 種類の摂動のうち、Phoenix は 5 種類で首位です。カメラ視点(89.9%、InternW0-Δ は 90.6%)と背景(98.6%、Qwen-RobotManip-Context は 99.9%)では最高ではありません。RoboDojo-RealWorld の 3 つの構成での成功率は 33.3%、31.7%、25.0% で、Piper では OpenWAM-α の 36.7% が Phoenix を上回ります。RoboTwin のタスク別の表 S3 には GigaBrain-0.7 の 50 タスク平均 67.9% も載っており、Phoenix はそのうち 27 タスクで最高または同率最高です。
事前学習の規模、少数デモでの適応、動画予測
事前学習の規模(図 4、RoboTwin 2.0 C2R):比較対象は、著者のデータ規模のプロトコルで事前学習した VAE のみのベースライン Fast-WAM です。事前学習データを 25% から 100% に増やすと、Phoenix の成功率は 27.0 ポイント、ベースラインは 11.4 ポイント上がります。Phoenix はデータの 50% で 67.7% に達し、ベースラインは全データで 47.7% です。表 1 では Fast-WAM の RoboTwin 2.0 C2R の値は 1.9% です。論文は図 4 のベースラインを著者のプロトコルで事前学習したと説明していますが、表 1 のその行の学習設定は、本サイトが読んだ本文には書かれていません。データ規模を論じるときは 47.7% のベースラインを基準にします。
少数デモでの事後学習(図 5):全データで事前学習した同じチェックポイントから、デモの 25%、50%、75%、100% でそれぞれ事後学習します。100% ではタスクごとに 50 本のデモがあります。LIBERO-Plus では 25% で 91.1% となり、全データの 94.8% より 3.7 ポイント低く、50% では 94.0% です。RoboTwin 2.0 C2R では 25% で 58.6%、50% で 66.1% となり、どちらも全デモで事後学習した上記の Fast-WAM ベースライン(47.7%)を上回ります。
動画予測(表 6):ベンチマークごとに 200 の窓を評価し、各モデルは自身のロールアウトの観測から、32 動作ステップにわたる未来の 8 フレームを予測します。RoboTwin 2.0 C2R では、PSNR が Fast-WAM の 16.51 から WAM 事前学習なしの Phoenix の 21.19、完全な Phoenix の 26.30 へ上がり、LPIPS は 0.39 から 0.30、さらに 0.16 へ下がります。著者はこれを、操作の成功率の向上に相互作用のダイナミクスのより忠実な予測が伴っていると解釈しています。2 組の結果が並んで示されているだけで、両者の因果関係を実験で切り分けてはいません。
評価のサンプリングを超える差はどれか
以下は論文が示す評価規模から本サイトが行った見積もりで、論文の数値ではありません。エピソードを独立した試行とみなし、95% の Wald 区間を使います。RoboTwin 2.0 C2R は方策ごとに 5,000 エピソードで、成功率 72% 付近では、独立に評価した 2 つの差の 95% 半幅は約 1.8 ポイントです。Phoenix の InternW0-Δ に対する 0.5 ポイントの差はこの範囲に入ります。RoboCasa-GR1 は計 1,200 エピソードで差の半幅は約 3.0 ポイントとなり、82.7% と 82.5% の差もこの範囲内です。RoboDojo-RealWorld は方策ごとに 180 試行で、30.0% は約 54 回の成功にあたります。OpenWAM-α との差の半幅は約 9 ポイントで、5.6 ポイントの差はこれを超えません。LIBERO-Plus の 10,030 件では差の半幅は約 0.7 ポイントで、InternW0-Δ に対する 2.0 ポイントの差はこれを超えています。
表 5 のアブレーションも 10,030 件すべてを使っているとすれば(本サイトが読んだ本文には個別の記載がありません)、差の半幅は約 1.0 ポイントです。PCA48 を CS-VAE に置き換えたときの 3.8 ポイントははっきり超えており、Phoenix Encoder の V-JEPA 2.1-L に対する 1.2 ポイントはこの尺度をわずかに上回る程度です。これらの見積もりは評価エピソードのサンプリングだけを考えたもので、学習の乱数シードによるばらつきは含みません。本サイトが読んだ本文には、複数シードの結果や信頼区間の報告はありません。区間の手計算は フィジカルAIラボ 2.8 にあります。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。論文はコード、事前学習データ、モデルをプロジェクトページで公開しているとしていますが、本サイトはそれらを開いて確認していません。
- 「6 つのベンチマークで SOTA」は著者の表現です。ベンチマークごとに別のモデルを事後学習しており、1 つのモデルを 6 つすべてで評価したわけではありません。比較対象の数値を著者が再実行したのか、元の論文から引用したのかは、本サイトが読んだ本文には書かれていません。
- 表 5 の表現のアブレーションはどの設定でも WAM の事前学習をしていないため、示しているのは事後学習の条件での差です。完全なモデルの中で場面潜在表現がどれだけ寄与しているかは、論文では個別にアブレーションしていません。
- 実機の部分は RoboDojo-RealWorld の 3 つの構成で、タスクごとに 10 試行です。シミュレーションや実験室の実機での成功率は、ハードウェアの安全性の検証ではありません。
- 本サイトが入手した論文の全文は付録 D のエンコーダ構成の表で途切れており、それ以降の学習の詳細は確認していません。
リンク
- Phoenix: Learning Scene Structure Representations for Generalizable World-Action Models(arXiv 2611.24938)
- 論文の HTML 全文
- フィジカルAIラボ 3.2:世界モデル――Cosmos でデータをつくる。生成ごとの条件を書き出し、78.3% を人の評価に戻し、生成データの受け入れ基準を決める
- フィジカルAIラボ 2.8:再現できる評価――Wald 区間と Wilson 区間を手で計算し、1/√n から評価回数を決め、失敗ゼロのあとの失敗率の上限を求める
- フロンティア・レーダー|SWAM:47,000 時間の動画とデモを世界行動モデルにどう与えるか――キャプションの詳しさ、UMI の動作ラベル、データ混合比を一つずつ検証
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)


