
预印本 Phoenix(arXiv 2611.24938,2026-11-18,作者来自中国科学院自动化研究所、Anyverse Dynamics、清华大学、新加坡国立大学和复旦大学)研究世界动作模型(WAM)应该预测什么样的视觉表示。WAM 同时预测未来观测和机器人动作;作者认为,为视频重建训练的潜变量保留了外观信息,却没有专门强调操作所需的空间关系和物体状态变化。Phoenix 先把几何与时空语义蒸馏进一个编码器,再把它的特征压成可生成的场景潜变量,与 Wan VAE 的外观潜变量和动作块一起预测。本文按论文的结构、表征消融、六个基准的主结果和数据效率实验逐项整理,并标出哪些差距落在评测抽样范围内。以下数字均为作者报告 [R],本站未复现。
三步表征:蒸馏编码器、CS-VAE 与联合预测
Phoenix Encoder 是一个 ViT-L/16 学生网络,从 VGGT-Ω 里的 DINOv3 骨干初始化,同时向两个冻结的教师学习。几何一路对齐 VGGT-Ω 的逐帧与跨视角中间特征,另加一项按置信度加权的对数深度损失去匹配教师生成的深度,因此不需要真值深度标注。时空语义一路由 V-JEPA 2.1-L 看完整片段,学生只看到在各帧上一致施加空间掩码的输入,再由预测器把输出映射到教师的特征空间。两个教师的更新交替进行,最后只保留骨干的 EMA 权重用于策略训练和部署。在 256 × 256 的输入下,每帧特征是 16 × 16 × 1024。
CS-VAE(causal-semantic VAE)把这些逐帧特征沿通道和时间压缩,同时保留空间 patch 网格:9 帧特征压成 3 个潜变量时间步,每步 48 个通道。第一个潜变量 z0 只依赖第 0 帧,之后每个潜变量聚合以自己时间步结尾的一段因果窗口。训练目标是特征重建的 MSE 与余弦损失,加上把后验拉向标准高斯的 KL 项;训练 CS-VAE 时 Phoenix Encoder 冻结。
联合预测:48 通道的场景潜变量与 Wan VAE 的 48 通道外观潜变量按通道拼接,得到 96 通道的视觉表示。视频扩散 Transformer 从 Wan2.2-TI2V-5B 初始化,动作扩散 Transformer 随机初始化,两路在每一层通过非对称掩码的联合注意力耦合:当前帧视觉 token 只互相关注;未来视觉 token 关注全部视觉 token,但不看动作;动作 token 关注全部视觉和动作 token。动作一路还交叉注意 T5 指令嵌入、机器人状态和按机械臂索引的 soft prompt token。训练用 flow matching,损失为 0.5 × 外观项 + 0.5 × 特征项 + 动作项。每个动作块覆盖 32 个连续控制步,推理时用 10 步去噪。
物理AI实验室 3.2 把世界模型写成 x̂[t+1] = W(x[0:t], c[t]),Cosmos 预测的是未来视频。Phoenix 属于另一类设计:预测目标除了外观潜变量,还多了一份从视觉基础模型蒸馏来的场景特征,并且和动作在同一个去噪过程里生成。按上面的注意力掩码,未来画面的预测不读取动作 token,动作的生成可以读取视觉 token。
39,306 小时数据与三阶段训练
作者从 54,413 小时数据中过滤出 39,306 小时,按时长计,机器人示范占 31.09%,第一视角视频占 63.58%,UMI 数据占 5.33%。训练分三段:(a) 用全部过滤后的数据蒸馏 Phoenix Encoder;(b) 用同样的数据训练 CS-VAE;(c) 只用机器人示范做 WAM 预训练。跨本体训练时,机器人状态和动作映射到一个共享的 80 维接口,每个机械臂 ID 选择 8 个可学习的 soft prompt token。WAM 预训练冻结 Phoenix Encoder、CS-VAE 和视频 VAE,只更新视频与动作专家、状态投影和 soft prompt,全局 batch 为 4,480,每个数据规模训练一个 epoch。之后在每个基准上用目标任务的示范单独后训练,默认 25k 步。
本站介绍过的 SWAM 也用数万小时视频与示范预训练 WAM,它逐项改变的是标注、动作标签和数据配比。Phoenix 的消融固定了数据,改变的是视觉表示本身,两篇回答的是不同的问题。
表征消融:换编码器、换压缩方式
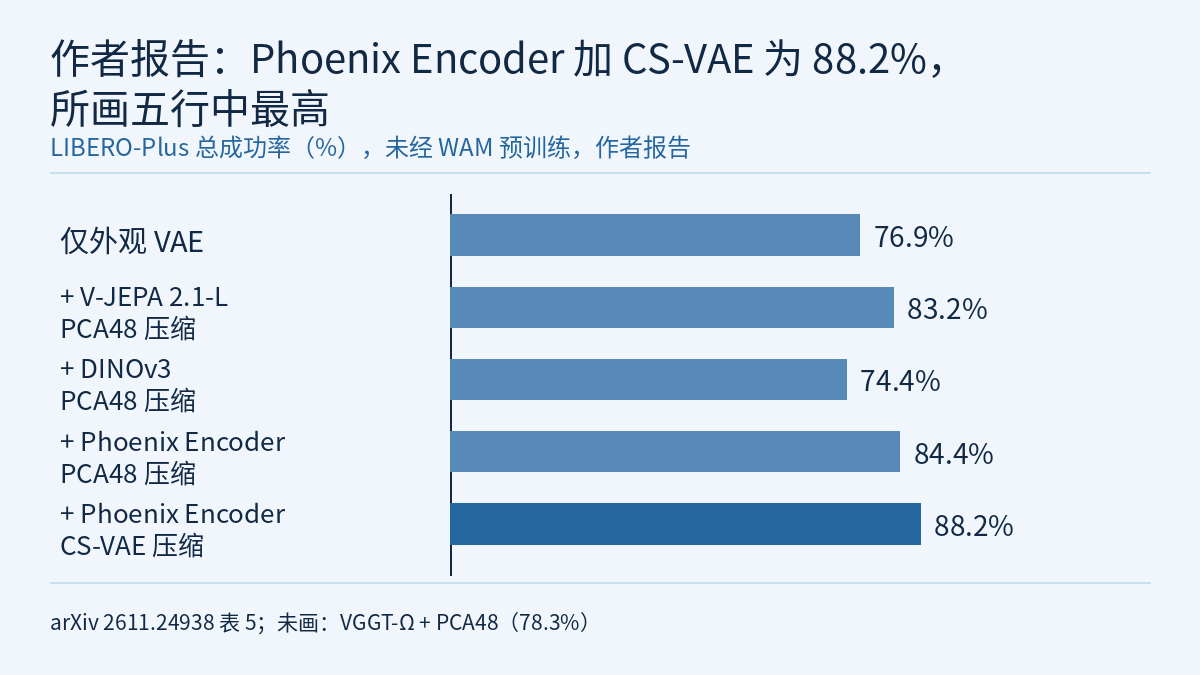
论文表 5 在 LIBERO-Plus 上比较视觉表示。所有设置都保留外观 VAE 分支,并且都不做 WAM 预训练,直接后训练。前五行把压缩方式固定为 PCA48,只换编码器;最后一行固定 Phoenix Encoder,把 PCA48 换成 CS-VAE。
| 外观分支之外加入的编码器 | 压缩 | Robot 初始化扰动 | 总成功率 |
|---|---|---|---|
| 无(仅外观 VAE) | — | 69.0% | 76.9% |
| VGGT-Ω | PCA48 | 60.4% | 78.3% |
| V-JEPA 2.1-L | PCA48 | 72.3% | 83.2% |
| DINOv3 | PCA48 | 66.2% | 74.4% |
| Phoenix Encoder | PCA48 | 70.2% | 84.4% |
| Phoenix Encoder | CS-VAE | 90.2% | 88.2% |
压缩方式相同时,Phoenix Encoder 为 84.4%,高于最强的替代编码器 V-JEPA 2.1-L 的 83.2%,也高于它的初始化来源 DINOv3 的 74.4%。从表中还能读到一点:单独加入 DINOv3 特征(74.4%)低于只用外观 VAE(76.9%)。编码器固定为 Phoenix Encoder 后,把 PCA48 换成 CS-VAE,总成功率从 84.4% 升到 88.2%,七类扰动中六类提高,升幅最大的是机器人初始化扰动,从 70.2% 到 90.2%。完整配置比只用 VAE 高 11.3 个百分点。
作者另用冻结特征做了探测(表 4,ScanNet++ 子集,各编码器用相同的探测头和训练日程)。Phoenix Encoder 的平均排名为 1.80,在给定相机运动直接预测未来特征一项上 Global R@1 为 34.42%,排第一,其余四项读出排第二;DINOv2-L 的平均排名为 2.60。
六个基准的主结果
完整模型经过 WAM 预训练,再在每个基准上单独后训练。下表是论文表 1–3 和附录表 S1、S2 的部分结果;评测规模取自论文附录的基准说明。
| 基准 | 设置与评测规模 | Phoenix | 论文表中的部分对照 |
|---|---|---|---|
| LIBERO-Plus | 7 类扰动,10,030 个评测实例 | 94.8% | InternW0-Δ 92.8%,π0.5 85.7% |
| RoboTwin 2.0 C2R | 50 个双臂任务,干净示范训练、随机场景评测,共 5,000 回合 | 72.4% | InternW0-Δ 71.9%,π0.5 46.0% |
| Bench2Dex | 26 个任务–本体设置,12 种臂–手组合,每个策略 5,200 回合 | 45.6% | GR00T N1.5 28.3%,π0.5 27.2% |
| RoboDojo-RealWorld | 真机 ARX X5、Piper、Piper X,18 个任务,每个策略 180 次 | 30.0% | OpenWAM-α 24.4%,π0.5 12.8% |
| LIBERO-Pro | 4 种扰动设置,40 个任务,每任务 50 回合 | 66.5% | Continuous Reasoning 64.0% |
| RoboCasa-GR1 | Fourier GR1 双臂灵巧手,24 个任务,共 1,200 回合 | 82.7% | CF-WAM 82.5% |
LIBERO-Plus 的七类扰动中,Phoenix 在五类领先,相机视角(89.9%,InternW0-Δ 为 90.6%)和背景(98.6%,Qwen-RobotManip-Context 为 99.9%)两类不是最高。RoboDojo-RealWorld 上三个配置的成功率分别为 33.3%、31.7% 和 25.0%;在 Piper 上 OpenWAM-α 的 36.7% 高于 Phoenix。RoboTwin 的逐任务表 S3 还列出 GigaBrain-0.7 的 50 任务均值 67.9%,Phoenix 在其中 27 个任务上最高或并列最高。
数据规模、少样本与视频预测
预训练规模(图 4,RoboTwin 2.0 C2R):对照是按作者的数据规模协议预训练的纯 VAE 基线 Fast-WAM。预训练数据从 25% 增加到 100%,Phoenix 的成功率升 27.0 个百分点,基线升 11.4 个百分点;Phoenix 只用 50% 数据时为 67.7%,基线用全部数据为 47.7%。表 1 里 Fast-WAM 在 RoboTwin 2.0 C2R 上的数字是 1.9%;论文说明图 4 的基线按作者的协议预训练,表 1 那一行的训练设置所读正文没有说明。讨论数据规模时应以 47.7% 这一基线为准。
少样本后训练(图 5):从同一个全量预训练检查点出发,分别用 25%、50%、75%、100% 的示范后训练,100% 时每个任务 50 条示范。LIBERO-Plus 上 25% 示范为 91.1%,比全量的 94.8% 低 3.7 个百分点,50% 时为 94.0%。RoboTwin 2.0 C2R 上 25% 示范为 58.6%,50% 时为 66.1%,都高于上面那个用全部示范后训练的 Fast-WAM 基线(47.7%)。
视频预测(表 6):每个基准评 200 个窗口,各模型从自己的 rollout 观测出发预测 8 个未来帧,覆盖 32 个动作步。RoboTwin 2.0 C2R 上,PSNR 从 Fast-WAM 的 16.51 到不做 WAM 预训练的 Phoenix 的 21.19,再到完整 Phoenix 的 26.30;LPIPS 从 0.39 到 0.30 再到 0.16。作者据此认为,操作成功率的提高伴随着更忠实的交互动态预测;这是并列出现的两组结果,论文没有用实验分离两者的因果关系。
哪些差距超出评测抽样
以下是本站按论文给出的评测规模做的估算,不是论文的数字。把回合当作独立试验并用 95% Wald 区间:RoboTwin 2.0 C2R 每个策略 5,000 回合,成功率在 72% 附近时,两个独立评测之差的 95% 半宽约 1.8 个百分点,Phoenix 对 InternW0-Δ 的 0.5 个百分点落在其中。RoboCasa-GR1 共 1,200 回合,差值半宽约 3.0 个百分点,82.7% 对 82.5% 也在其中。RoboDojo-RealWorld 每个策略 180 次,30.0% 约合 54 次成功,与 OpenWAM-α 之差的半宽约 9 个百分点,5.6 个百分点的领先没有超出这个范围。LIBERO-Plus 的 10,030 个实例下,差值半宽约 0.7 个百分点,对 InternW0-Δ 的 2.0 个百分点超出了它。
表 5 的消融若同样使用全部 10,030 个实例(所读正文没有单独说明),差值半宽约 1.0 个百分点:PCA48 换成 CS-VAE 的 3.8 个百分点明显超出,Phoenix Encoder 对 V-JEPA 2.1-L 的 1.2 个百分点只略高于这个尺度。这些估算只计入评测回合的抽样,不含训练随机种子的差异,而所读正文没有报告多种子结果或置信区间。区间的手算方法见 物理AI实验室 2.8。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。论文称代码、预训练数据和模型可在项目页获取;本站没有打开或核对这些发布。
- “六个基准 SOTA”是作者的表述。每个基准都单独后训练一个模型,不是同一个模型同时在六个基准上评测。所读正文没有说明各对照数字是作者重跑还是引自原论文。
- 表 5 的表征消融全部不做 WAM 预训练,说明的是后训练设置下的差别;完整模型里场景潜变量各自贡献多少,论文没有单独消融。
- 真机部分是 RoboDojo-RealWorld 的三个配置、每个任务 10 次。仿真和实验室真机的成功率都不是硬件安全验证。
- 本站读到的论文全文在附录 D 的编码器结构表处截断,其后的训练细节没有核对。
链接
- Phoenix: Learning Scene Structure Representations for Generalizable World-Action Models(arXiv 2611.24938)
- 论文 HTML 全文
- 物理AI实验室 3.2:世界模型,用 Cosmos 造数据,写清每种生成以什么为条件,把 78.3% 放回人类评审,再给生成数据定验收规则
- 物理AI实验室 2.8:可复现评测,手算 Wald 与 Wilson 区间,从 1/√n 定评测次数,再给零失败算出失败率上界
- 前沿雷达|SWAM:4.7 万小时视频与示范怎样喂给世界动作模型,作者逐项消融了标注细度、UMI 动作标签和数据配比
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)


