
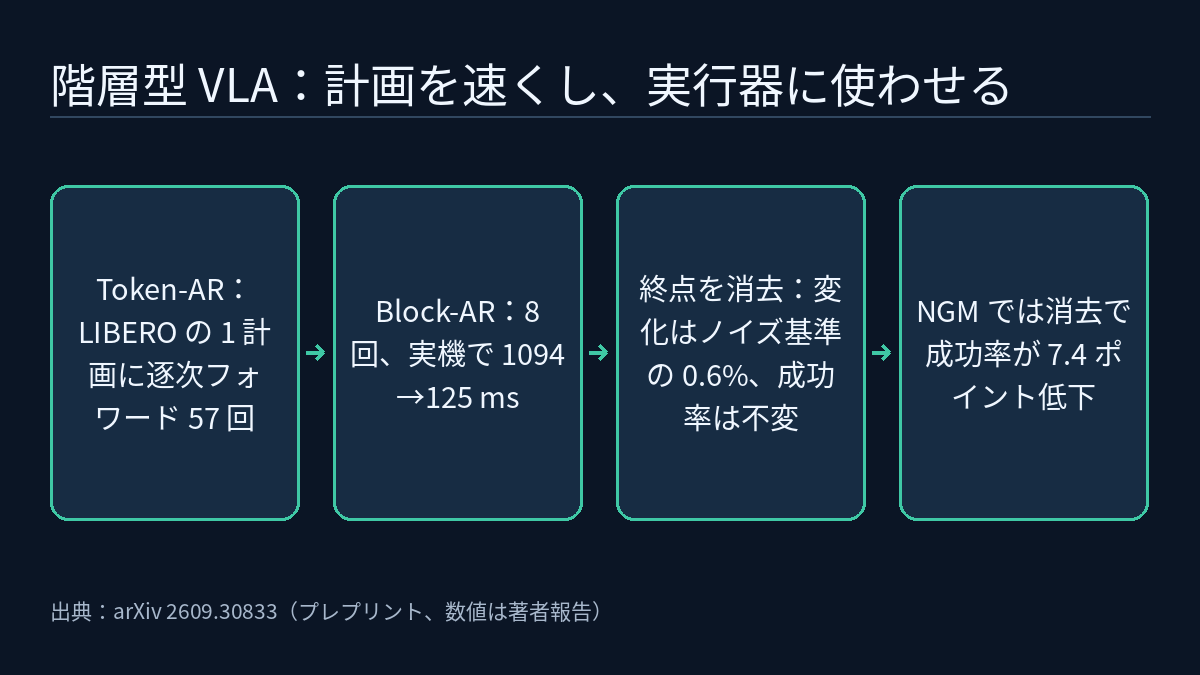
階層型の視覚-言語-行動(VLA)モデルでは、大きな視覚-言語プランナーがまず中間的な計画を書き、低レベルの行動エキスパートがそれを連続的な動作に変換します。南洋理工大学 MARS Lab のプレプリント Fast Plans, Faithful Actions(arXiv 2609.30833、2026-09-25、証拠レベル [R])は、この分業に意味があるのは二つの条件を満たすときだけだと指摘します。計画が十分に速く生成されること、そして実行器が実際に計画に従うことです。著者らは自分たちで構築したベースラインで両方とも満たされていないことを示し、測定方法と二つの改良を提案しています。階層型 VLA を開発するチームにとって最も参考になるのは介入テストです。エンドツーエンドの成功率が高くても、プランナーと実行器のインターフェースが機能している証拠にはなりません。
対象:π0.5 から改変したウェイポイント階層
著者らは π0.5 を階層構造に改変し、Waypoint Token-AR と呼んでいます。PaliGemma バックボーン(SigLIP エンコーダと Gemma-2B 言語モデル)がプランナーとなり、ロボットのコンフィギュレーション空間でウェイポイントを予測します。各ウェイポイントは目標コンフィギュレーション、グリッパー状態、実行時間(動作ステップ数)からなります。π0.5 から引き継いだ 300M パラメータの行動エキスパートは flow matching で学習され、現在の状態とウェイポイントをサフィックストークンとして受け取り、クロスアテンションで画像と言語のプレフィックスも参照できます。論文は、このベースラインが制御実験のために著者らが構築したもので、π0.5 本来のアーキテクチャではないと明記しています。ウェイポイントは AWE アルゴリズムでデモンストレーションからオフラインに抽出され、各セグメントの長さは行動エキスパートの予測ホライズン D = 32 ステップ以内に収められています。
速さ:トークン単位ではなくウェイポイント単位でデコードする
ベースラインはトークン単位の自己回帰デコード(Token-AR)で計画を生成します。LIBERO で 7 ウェイポイントの計画を作るには、逐次的なバックボーンのフォワードが 57 回(プレフィックスの prefill 1 回と値トークン 56 個)必要です。16 自由度の双腕ロボットではウェイポイントあたり 19 トークンとなり、最大 120 回に達します。論文によれば、実機では計画の生成に、その計画が指定する動作セグメントの実行より長い時間がかかり、両腕は稼働時間の 71% を待機に費やしていました。
著者らはこれを粒度の不一致とみています。実行器は計画をウェイポイント単位で消費するのに、プランナーはトークン単位で生成しているからです。Block-AR は各ウェイポイントを一つのブロックとして扱い、ブロック内は双方向、ブロック間は因果的なアテンションにします。入力はブロック単位でシフトされ、1 回のフォワードで 3 回の LM ヘッド呼び出しによりコンフィギュレーション、グリッパー、時間を読み出します。これにより最長の計画でもフォワードは 8 回(prefill 1 回とウェイポイント 7 個)で済み、ウェイポイントあたりのスロット数には依存しません。著者らが報告した計画コストは次のとおりです。計画レイテンシ、リクエストの往復時間、動作デューティ比は Rokae 双腕ロボットの 35 テレメトリーエピソードから、計画終了マーカーの指標はホールドアウトした 2,172 件の実機計画ウィンドウ(うち真の計画終了は 270 件)から得たものです。最大逐次フォワード回数はデコードの構造で決まる値で、測定値ではありません。
| 指標 | Token-AR | Block-AR |
|---|---|---|
| 計画あたりの最大逐次フォワード回数(LIBERO / ロボット) | 57 / 120 | 8 / 8 |
| 計画レイテンシ | 1094 ms | 125 ms |
| リクエストの往復時間(行動エキスパートを含む) | 1266 ms | 293 ms |
| 動作デューティ比 | 28.7% | 65.6% |
| 計画終了マーカーの再現率 / 適合率 | 0.00 / – | 0.61 / 0.85 |
計画レイテンシが 1/8.7 になった後、残るレイテンシの大半は行動エキスパート(セグメントあたり約 160 ms)によるものです。このホールドアウト・ウィンドウで、Token-AR は終了コード d = 0 を一度も出力しませんでした。また Block-AR は最初のウェイポイントの関節角誤差を 0.156 rad から 0.112 rad へと 28% 減らしています。代償は LIBERO に現れます。Block-AR に置き換えると 4 スイートの平均成功率は Token-AR より 0.85 ポイント低く、スイートごとの差は +0.6 から −1.4 ポイントの範囲でした。
忠実さ:実行器が計画を見ているかをどう測るか
論文は互いに補い合う二つの指標を定義しています。どちらも画像、言語、状態、flow ノイズを固定し、ウェイポイントだけを変えます。
- 感度 S:ウェイポイントの変更による動作の変化を、行動エキスパート自身のノイズを 1 回再サンプリングしたときの動作の変化で割った値(RMS で計算し、セグメント全体の中央値をとる)。
- 効用 U:テスト時に空間的な終点を消去した(目標コンフィギュレーションをそのセグメントの開始状態にした)とき、タスク成功率が何ポイント下がるか。U > 0 は消去が性能を損なうことを意味します。
LIBERO-Long の固定した 64 動作セグメントでは、サフィックストークン条件付けの Block-AR は、終点を消去しても動作の変化がノイズ基準の 0.6% にとどまり、閉ループですべての終点を消去しても成功率は下がりませんでした(U = 0.0)。行動エキスパートがあらゆる入力に鈍感なわけではありません。メインカメラの画像を差し替えると動作はノイズ基準の 281%、言語指示を差し替えると 158%、時間を 4 ステップ延ばしても 19% 変化します。著者らの説明では、行動エキスパートは画像と言語の K/V 表現も参照できるため、経験リスク最小化はウェイポイントを通じて動作を決めることを強制しません。
改良:正規化ゴール変調(NGM)と「変位積分ショートカット」
素直な改良は、ゴールに行動エキスパートの全層へ届く深い経路を与えることです。ところが制約なしに注入すると(naive goal injection)、逆方向に行き過ぎることを著者らは見出しました。なお、論文ではこの変種は Block-AR ではなく Token-AR に基づいており、上記の Block-AR + サフィックス条件付けに対する制御されたアブレーションではありません。行き過ぎる理由は次のとおりです。デモンストレーションでは相対ゴール q − s が、エキスパートが学習しようとしている動作の積分にほぼ等しいため、それを全層に与えるとラベルが条件に漏れ込みます。モデルは画像を見ずに変位を積分するだけで学習損失を下げられてしまいます。著者らはこれを変位積分ショートカットと呼んでいます。このとき終点感度は 348% に跳ね上がり、画像変化への応答はサフィックス基準の 27% まで落ち、LIBERO-Long の成功率は 15% に低下し、失敗はすべてタイムアウトでした。したがって感度が高いことは計画が正しく使われている証拠にはならず、計画を消去しないときの成功率や他の入力への応答とあわせて読む必要があります。
NGM は深い経路を残したうえで、次の仕組みをとります(最初の項目は深い経路そのものの構成、残る二つが制約です)。
- 入力と注入:変位 q − s を次元ごとにロバストなスケールで正規化し、学習可能なグリッパー埋め込みと連結して、出力射影をゼロ初期化した MLP に通します。得られた残差を全層の AdaRMS 条件に加えます。初期化時点ではモデルの挙動は元と同じです。
- 位相ゲート:経路はデノイズの粗い段階でだけ開きます(t ≥ 0.5 で全開、t ≤ 0.2 で閉じる)。最後の微調整は行動エキスパートが見ている画像に委ねます。
- ショートカット対策の学習:学習時に終点へガウスノイズ(正規化領域で σc = 0.7)を加え、確率 0.15 で学習可能な null 埋め込みに置き換えます。どちらの摂動もサフィックストークンと深い経路の両方に同時にかけます。そうしないと、摂動のないサフィックスがラベルをそのまま持ち込んでしまうためです。推論時にはノイズと dropout を切り、ゲートは残し、classifier-free guidance は使いません。
| システム(LIBERO-Long) | S 終点 | S 時間 | 画像応答の保持率 | 計画を消去しないときの成功率 | U(ポイント) |
|---|---|---|---|---|---|
| Block-AR + サフィックス条件付け | 0.6% | 19% | 100% | 91.0% | 0.0 |
| Token-AR + naive 注入 | 348% | 106% | 27% | 15% | +14 |
| Block-AR + NGM | 42.6% | 26.4% | 82% | 96.2% | +7.4 |
NGM では終点を消去すると成功率が 7.4 ポイント下がります。実行器が視覚への応答の大部分を保ったまま、計画に依存するようになったことを示しています。LIBERO の 4 スイート平均成功率は 95.85% から 98.45% に上がり、すべてのスイートで改善しました。参考として、論文は OpenPI の LIBERO 評価 README に記載された π0.5 の平均 96.85% を引用しています。この行は引用値であり、著者らが同じ学習条件で再実行した結果ではありません。
実機での結果と、本サイトの既存記事との関係
実機実験は三つの双腕タスクです。妨害物のある中でピーマンとバナナを二つの箱に入れる、二枚の皿の赤と緑のピーマンを入れ替える、色に合わせてブロックを棚に置く、の三つです。各手法を各タスク 20 回試行し、成否はオペレーターが判定しました。Token-AR 48/60、Block-AR 46/60、Block-AR + NGM 51/60 です。著者ら自身も成功率は「同程度」と表現しており、この試行数では数回の成功の差について結論は出せません。実機で確認できる改善は時間面のものです。成功率が同程度のまま、腕が動いている時間の割合が 2 倍以上になりました。
本サイトの「フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか」は、複数の資料のレイテンシ予算をミリ秒単位で整理しました。この論文はそこに階層型システムのプランナーのデコードという段階を加え、実機で直接観察できる動作デューティ比で測っています。「フロンティア・レーダー特集|シミュレーションと評価:VLA の評価に初期状態成功率以外で欠けているもの」は成功率以外の評価の観点を扱いました。本記事の介入テストはもう一つの観点を加えます。他の入力を固定して計画だけを変えてはじめて、計画が使われているかを確かめられるという点です。VLA の基本的な考え方は講座「フィジカルAIラボ 0.2:なぜ今なのか、データ・モデル・計算資源の 3 本の曲線」を参照してください。
制約と注意点
- これは arXiv のプレプリントです。上記の数値はすべて著者らの報告であり、本記事が依拠した資料には独立した再現も、コードリポジトリへのリンクもありません。
- Block-AR と NGM は、π0.5 から派生した一つの階層構造向けに設計・検証されたものです。Block-AR は形式が固定されたウェイポイントのトークン群を前提とし、NGM は π0.5 の行動エキスパートの AdaRMS 条件付けに依存します。他の VLA バックボーンへ移植できるかは未検証だと著者らは明記しています。
- 各モデルの変種は 1 回しか学習されておらず、学習ごとのばらつきは推定できません。LIBERO では、1 スイートの 1 ポイントは 500 エピソード中の 5 エピソードに相当します。
- 実機は 3 タスク、各手法・各タスク 20 回のみです。著者らも、これが成功率推定の精度と小さな差についての結論を制限すると述べています。
- シミュレーションでは計画全体を実行し終えてから再計画しますが、実機では最初のセグメントを実行した時点で新しい計画を要求します。デューティ比の数値はこの設定に依存します。
- 「時間が予測ホライズンに収まる」ことが保証するのは、要求された動作セグメントが行動エキスパートの出力長に収まること(実機 30 Hz で最大 1.07 s、LIBERO 20 Hz で最大 1.6 s)だけです。動作が衝突しないことや動力学的に実行可能であることは意味しません。
リンク
- arXiv 2609.30833:Fast Plans, Faithful Actions: Closing the Planning–Execution Gap in Hierarchical Vision-Language-Action Models(著者:Chuanliang Xie、Boyu Ma、Gen Li、Yizhou Liu、Houwang Chen、Xinyu Zhou、Jianfei Yang)
- 論文 HTML 全文


