机器人任务规划不只要求最后到达目标,还要求中间每一步都满足顺序、互斥、资源这类约束:一个计划最终把物体放对了位置,如果途中进入禁区、按错误顺序搬动易碎物体或跳过必需的检查步骤,仍然不可接受。来自圣母大学(University of Notre Dame)和西北大学(Northwestern University)的作者在预印本 SLoSa(arXiv 2610.28955,2026-10-20)里,把经典规划器和形式化验证器从推理环节挪进训练环节:先用它们构造“加上约束后原计划就失效”的训练题,再把验证器给出的分级结果当作 GRPO 奖励,微调 4B–14B 的 4-bit 量化模型。作者报告,这些紧凑规划器在 200 题 PDDL 测试集上的成功率达到 70.5–76.0%,以 INT4 在 Jetson AGX Orin 上本地运行时平均功率为 17.85–26.41 W。本文重点读一个容易被忽略的细节:验证器按固定顺序检查,只有计划能执行,才会判断它是否违反安全约束。以下数字均为作者报告 [R],本站未复现。
“安全”在这里指什么:形式化约束和固定的检查顺序
论文把任务写成 P = (S, A, s0, G, C):符号状态空间、动作集合、初始状态、目标和安全约束集合。每个动作对应一个高层技能(如 pick、move、place),有前置条件和效果;计划是一串动作。安全约束用 PDDL3 的轨迹约束表达,检查的是整条状态轨迹,而不只是终点。论文明确说,SLoSa 名字里的“安全意识”指符合这份形式化任务规格;“低功耗”是一个经验性的部署目标,不是假定成立的性质。
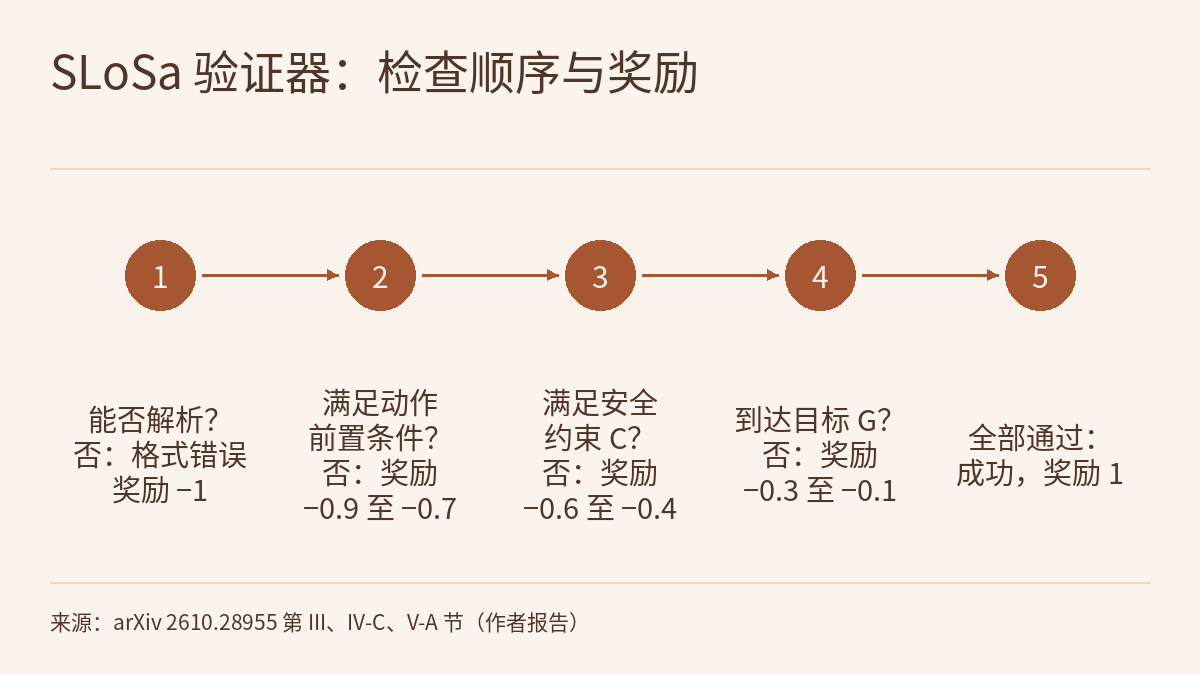
验证器对一个输出按固定顺序检查,第一项不通过的检查决定结果,因此每个输出恰好落入一类:
- 无法解析,或含未定义的动作、对象:格式错误。
- 能解析,但某个动作的前置条件不满足:前置条件违规。
- 得到完整、可执行的轨迹之后,才检查约束 C;违反 C:安全违规。
- 安全且可执行,但没有到达目标 G:目标失败。
- 以上都通过:成功。
这个顺序同时用于训练数据过滤、奖励设计和评测,也决定了结果表该怎么读。下文表格里“安全违规”一列的数字都很低(0–1.0%),但这不说明失败的计划大多是安全的:一个在第 3 步就违反前置条件的计划,根本不会走到安全检查。例如直接提示的 GPT-5.6 Sol 有 73.0% 的输出是前置条件违规,安全违规只有 0.5%;那 73.0% 的输出是否满足约束,这张表回答不了(这是本站按论文定义得出的读法)。更直接地衡量“约束是否改变了做法”的,是下一节的数据消融。
训练数据:只留下“约束改变了做法”的题目
数据来自四个借鉴机器人场景的 PDDL 领域:Blocksworld、Ferry、Grippers 和 Spanner,分别对应操作、运输、物体转移和工具使用。对每道基础题 P0,经典规划器先给出一个经验证可执行、能到达目标的基线计划 τ0;再按领域语义加入一条 PDDL3 约束,得到受约束的题 Pc。约束属于四种模式之一:
| 模式 | PDDL3 构造 | 机器人场景中的含义 |
|---|---|---|
| 顺序安全 | sometime-before | 某个事件必须先于另一个事件发生 |
| 中转安全 | sometime、sometime-before | 机器人必须经过一个安全的中间状态 |
| 资源限制 | always、not | 不安全、被预留或故障的资源不能使用 |
| 强制检查 | sometime | 机器人必须到达检查点或完成一次检查 |
论文给的例子是 Spanner 中“先拧紧 nut1 再拧紧 nut2”的顺序约束:(sometime-before (tightened nut2) (tightened nut1))。按相反顺序拧紧两颗螺母的计划仍能到达目标,但违反了这条轨迹约束。
规划器再解出 Pc 的替代计划 τc。一道题只有同时满足三个条件才保留:τ0 在原题上成功,τc 在受约束题上成功,τ0 在受约束题上被判为安全违规。也就是说,加入的约束必须让原来的做法失效,同时仍有一个经验证的替代做法;作者把这类样本称为 behavior-changing(改变行为的)。论文提醒,这个定义是相对所选的基线计划而言的,并不意味着形式化规格覆盖了所有真实世界的危险。难度只按验证计划的长度分为 Easy、Medium、Hard;每道题生成一个 PDDL 提示和一个结构化或叙述式的自然语言提示;20% 的题由教师模型 GPT-5.4-mini 额外生成候选计划,只有通过同一个验证器的才保留。
数据构成的作用有一组对照。作者在 Qwen3-4B 上只做 SFT,比较三种同样大小、只含正例的数据:U-SFT 用不带约束的计划,OC-SFT 用一半约束不影响原解、一半改变行为的混合数据,BC-SFT 只用改变行为的样本。“条件安全违规”指到达目标的输出中违反至少一条约束的比例。
| 数据 | 成功率(95% 置信区间) | 到达目标 | 条件安全违规 |
|---|---|---|---|
| U-SFT | 3.5% [1.7, 7.0] | 17.5% | 80.0% |
| OC-SFT | 53.0% [46.1, 59.8] | 56.0% | 5.4% |
| BC-SFT | 59.0% [52.1, 65.6] | 59.5% | 0.8% |
三行数字互相吻合(本站核算):17.5% × (1 − 0.800) = 3.5%,56.0% × (1 − 0.054) ≈ 53.0%,59.5% × (1 − 0.008) ≈ 59.0%。差别主要在条件安全违规:不带约束训练的模型,到达目标的计划里八成违反约束;只用改变行为样本训练时降到 0.8%。OC-SFT 与 BC-SFT 的成功率置信区间有重叠,两者成功率的差距在这组数据上并不确定;这项消融只在一个模型、只用 SFT 的条件下做。
奖励:验证器定区间,规划器距离只在区间内排序
GRPO 阶段对每个提示采样 K = 4 个候选计划,由验证器直接给分,不另训练奖励模型或 critic。格式错误固定得 −1,成功固定得 1;三类中间失败各有一个互不重叠的负区间,论文所用的值是:前置条件违规 [−0.9, −0.7],安全违规 [−0.6, −0.4],目标失败 [−0.3, −0.1]。作者解释了这个顺序:前置条件违规连完整轨迹都产生不了;在可执行的计划中,违反安全约束被视为比“安全但没到目标”更严重。
同一类失败之间,再用经典规划器算出的进度区分。取一个评估状态(前置条件违规取失败动作之前的状态;安全违规取首次检测到违规的状态,对整条轨迹才能判定的约束取终止状态;目标失败取终止状态),以它为新起点求最短计划长度 d_res,再与从原始初始状态出发的最短长度 d_init 比较:
ϕ_dist = (d_init − d_res) / (d_init + d_res + ε)
r = ℓ_c + (h_c − ℓ_c) · (ϕ_dist + 1) / 2
规划器在时限内解不出时取最低进度值。用一组假想数字算一次(本站示例,不是论文数据):一个安全违规的计划,d_init = 10,违规时的状态离目标还有 d_res = 4 步,忽略 ε,ϕ_dist = 6/14 ≈ 0.43,奖励 ≈ −0.6 + 0.2 × 0.71 ≈ −0.46。即便一个前置条件违规的计划进度满分(ϕ_dist = 1),它也只能得到 −0.7,仍低于任何安全违规。也就是说,进度项只能在验证器划定的区间内排序,不能把一类失败抬到更高的一类。成功计划不加计划长度项,因为目标是提高验证通过率,而不是优化计划代价。
物理AI实验室 1.7:强化学习用一局手算的回报说明过,塑形奖励写歪了会被钻空子。SLoSa 的分区间设计是对这个问题的一种结构化处理;所读正文没有单独检验它能否防止钻空子。另外两点训练细节:一组 4 个候选的奖励完全相同时,这一组没有相对偏好信号,被标为不活跃,排除在策略项和 KL 项之外;GRPO 按 Easy/Medium/Hard 的采样比例 6/3/1、1/6/3、1/3/6 分三段课程,分别训练 125、250、125 步。
结果:成功率的提高主要来自前置条件违规减少
三个骨干都是 4-bit 量化加载、用 LoRA(秩 32)适配的开源模型:Qwen3-4B、Llama-8B(Llama 3.1 8B Instruct)和 Qwen3-14B。评测用贪心解码,不输出中间思维链,Qwen3 的思考模式在训练和评测中都关闭。PT 指未经 SLoSa 后训练的原始模型。下表是 200 题 PDDL 测试集上的结果,五列互斥、合计 100%:
| 模型 | 阶段 | 成功 | 目标失败 | 安全违规 | 前置条件违规 | 格式错误 |
|---|---|---|---|---|---|---|
| GPT-5.6 Sol | 直接提示 | 26.5 | 0.0 | 0.5 | 73.0 | 0.0 |
| Claude Sonnet 5 | 直接提示 | 31.0 | 3.5 | 0.0 | 55.5 | 10.0 |
| Qwen3-4B | PT / SFT / GRPO | 0.0 / 59.0 / 70.5 | 1.5 / 1.5 / 1.5 | 0.0 / 0.5 / 0.5 | 0.0 / 36.5 / 25.0 | 98.5 / 2.5 / 2.5 |
| Llama-8B | PT / SFT / GRPO | 0.0 / 62.0 / 74.0 | 5.0 / 5.5 / 7.5 | 0.0 / 1.0 / 0.0 | 70.0 / 30.5 / 18.0 | 25.0 / 1.0 / 0.5 |
| Qwen3-14B | PT / SFT / GRPO | 0.0 / 67.0 / 76.0 | 0.5 / 2.5 / 1.5 | 0.0 / 0.0 / 0.0 | 0.0 / 30.5 / 22.0 | 99.5 / 0.0 / 0.5 |
从 PT 到 SFT 的跳变,主要是模型学会了任务专用的动作词汇和严格的输出格式:两个 Qwen3 模型 PT 阶段 98.5%、99.5% 的输出是格式错误。从 SFT 到 GRPO,三个模型的成功率提高 9.0–12.0 个百分点,同期前置条件违规减少 8.5–12.5 个百分点(本站按表计算),即 GRPO 的收益大多来自让计划能执行。作者据两个直接提示的大模型(26.5%、31.0%)称,模型规模本身替代不了面向安全的后训练;需要注意,这两个模型没有经过任务专用训练,所读正文也没有给出它们的提示词,它们的失败也主要是前置条件违规。
作者还把三个 Llama-8B 检查点接入 SafePilot:验证器拒绝的计划连同反馈交回模型修改,最多三轮,只接受通过全部检查的计划。在 200 题上,PT、SFT、GRPO 的最终成功率分别为 0.5%、68.0%、77.5%,比首轮分别提高 0.5、6.0、3.5 个百分点;平均轮数(含首轮)为 2.995、1.735、1.500,平均 token 数为 5,185.81、2,179.52、1,782.87。减去提升量,SFT 和 GRPO 的首轮成功率是 62.0% 和 74.0%,与上表 Llama-8B 的数字一致(本站核算)。这组结果说明的是:首轮质量越高,修复循环用的轮数和 token 越少。
同一套流程另外在两个家居基准的改编版上单独训练 Qwen3-4B:VirtualHome-Safe 的成功率 PT 0.0%、SFT 74.5%、GRPO 80.5%,ALFWorld-FO-Safe 为 0.0%、76.0%、85.0%。两者都是完全可观测、非交互的改编,模型要一次输出完整计划,中途没有环境反馈或重新规划;ALFWorld-FO-Safe 暴露完整的符号状态,不是标准的部分可观测、交互式 ALFWorld 协议。论文写明,这些例子评估的是高层符号层面的安全合规,不是物理碰撞安全。
部署:Jetson Orin 上功率低,但一个计划的中位时延约 16–22 秒
边缘测试在 NVIDIA RTX 4080(16GB)和 Jetson AGX Orin 开发套件(64GB)上进行,INT4 推理,批量 1、单个并发请求;每个模型在同样 100 个 PDDL 提示上跑三遍,之前先做 20 次预热。时延包含生成与解析,吞吐只算生成;每计划能耗把实测推理能耗(含请求间开销)除以计划数,不含模型加载、预热和验证的能耗。
| 硬件 | 模型 | P50(s) | P90(s) | token/s | 峰值内存(GB) | 平均功率(W) | 每计划能耗(J) |
|---|---|---|---|---|---|---|---|
| RTX 4080 | Qwen3-4B | 6.65 | 8.66 | 11.73 | 3.80 | 71.16 | 464.75 |
| RTX 4080 | Llama-8B | 6.01 | 7.77 | 13.19 | 5.91 | 88.14 | 516.70 |
| RTX 4080 | Qwen3-14B | 8.03 | 11.11 | 9.77 | 11.22 | 122.90 | 983.78 |
| Jetson Orin | Qwen3-4B | 18.28 | 23.53 | 4.30 | 3.89 | 17.85 | 316.33 |
| Jetson Orin | Llama-8B | 15.88 | 20.01 | 5.01 | 6.06 | 23.14 | 355.18 |
| Jetson Orin | Qwen3-14B | 22.00 | 30.04 | 3.55 | 11.50 | 26.41 | 581.14 |
摘要里的“17.85–26.41 W”是这张表 Jetson Orin 三行的平均功率。同一张表也给出了另一面:Orin 上的 P50 时延是 15.88–22.00 s,约为 RTX 4080 上同一模型的 2.6–2.7 倍;但因为功率低得多,每计划能耗反而低于 RTX 4080(Qwen3-4B 为 316.33 J 对 464.75 J)。这是一个任务级的高层规划器,一个计划的中位时延约 16–22 秒,与毫秒级的底层控制回路不在同一层;物理AI实验室 0.3:看-想-动讲过不同层各有各的频率。所读文本没有说明功率测的是整块开发板还是只计 GPU,也没有给出这些测量的离散程度。另一处要分清:图 4 在 41 个 10–50 块的 Blocksworld 实例上比较的是 Fast Downward、OPTIC(许多大实例到达 300 秒超时)与 GPT-5.6 Sol 的生成时间,并不是 SLoSa 的紧凑模型;正文只说 GPT-5.6 Sol 的生成时间“相对稳定”,没有给出它在这些实例上的有效计划比例。本站此前在前沿雷达|EdgeVLN和前沿雷达专题|边缘与实时性里讨论过 4 bit 推理的能耗与延迟,那些是另一类模型和硬件上的结果,不能与这里的数字直接比较。
真机演示用一台桌面 6 自由度机械臂和一台第三人称相机做 Blocksworld。每个任务由初始积木布局的图像、目标布局的图像和一段描述安全约束的自然语言给出;一个视觉-语言模型把它们转成 PDDL3 问题(所读正文没有点名是哪个模型),Qwen3-4B 的 SFT 或 GRPO 检查点生成计划,执行前经过 SafePilot 式的验证-修改循环,只有验证通过的计划才交给控制器,映射为预设的操作技能。每个规划器做 30 次:
| 指标(/30) | SFT | GRPO |
|---|---|---|
| 验证通过的计划 | 17 | 19 |
| 验证拒绝的计划(不执行) | 13 | 11 |
| 执行成功 | 13 | 14 |
| 底层失败 | 4 | 5 |
底层失败指验证通过的计划因执行精度不足导致叠放失败,或叠起来的积木超出机械臂可达的工作空间;论文说明这些失败来自操作精度,不是违反了编码的符号约束。两种检查点的执行成功只差 1 次(13 对 14),30 次的样本量不足以据此区分两者;物理AI实验室 1.8:评测练过怎样看这种小样本差距。这组实验说明验证器拦下了 11–13 个不合格的高层计划,没有让它们直接发给机器人;它不是硬件安全验证。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。所读文本没有给出代码、数据或模型权重的发布地址。
- 作者自己列出的局限:SLoSa 只做高层任务规划,安全监督来自符号动作模型和形式化验证结果,报告的安全表现只衡量对相应高层约束的合规;评测不覆盖感知错误、运动层失败和未建模的物理风险;Blocksworld 这类长程领域仍然困难;桌面机械臂评测只用了一个工作单元和固定的底层技能。
- “改变行为”的样本定义相对所选基线计划,不意味着形式化规格涵盖所有真实危险。真机流程中,视觉-语言模型生成的 PDDL3 问题若有误,验证器只能针对这份规格检查;所读正文没有单独报告这一步的准确率。
- 结果表中低的安全违规比例要连同检查顺序一起读:前置条件违规的计划不会进入安全检查。约束对行为的影响,更直接的证据是数据消融中的条件安全违规,而那项消融只在 Qwen3-4B、只用 SFT 的条件下做,OC-SFT 与 BC-SFT 的成功率置信区间有重叠。
- 两个直接提示的大模型没有经过任务专用训练,所读正文没有给出其提示设置;与紧凑模型的比较不是同等条件下的比较。
- 边缘测试是批量 1、单请求、100 个提示的条件;所读文本没有说明功率的测量范围和测量离散度。表注写作 “energy per accepted plan”,但定义是除以计划数,没有说明是否只计验证通过的计划。约 2.6–2.7 倍、9.0–12.0 和 8.5–12.5 个百分点、首轮 62.0% 与 74.0% 都是本站按论文表格做的算术。第三节的 d_init = 10、d_res = 4 是假想数字。
链接
- SLoSa: Small, Low-Power, and Safe Foundation Models for Robotic Task Planning(arXiv 2610.28955)
- 论文 HTML 全文
- 物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统
- 物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 前沿雷达|EdgeVLN:同为 4 bit,每步能耗因执行路径相差 36.8 倍
- 前沿雷达专题|边缘与实时性:VLA 与世界动作模型的延迟预算花在哪里
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)