预训练的机器人基础模型用离线遥操作示范适配目标任务后,部署时仍会走进示范没覆盖的状态:接触密集的交互、需要恢复的局面和对精度要求高的位形。来自复旦大学、Shanghai Innovation Institute、Logos Robotics Group 和萨里大学(University of Surrey)的作者在预印本 TIDE(Training In DEployment,arXiv 2610.29264,2026-10-21)里,把部署本身变成训练过程:机器人执行当前策略,操作员只在必要时接管,系统只在一个 50 步动作块的动作全部来自人或全部来自策略时,给它标上“人执行”或“策略执行”的来源标签,人和策略混合的块排除在外,学习器在同一次会话里在线更新,并在回合边界换上新检查点;整个过程不用学到的 critic、奖励模型或动作打分器。作者报告,在四项双臂真机任务上,TIDE 的任务进度和完整完成次数都高于预热策略和等量的追加离线示范,但与“固定策略采集、采完再训”的基线最终表现相当;它的区别在于新检查点在部署期间就能用上。以下数字均为作者报告 [R],本站未复现。
问题:离线后训练要等下一轮,在线 RL 要估价值
论文把现有做法分成两类,并分别指出代价。第一类是离线后训练:按“采集-训练-部署”的循环进行,部署中的经验要等下一轮离线训练才能用上,分布偏移下适应得慢。已有的人在回路方法又多把部署只当作专家动作标签的来源:人接管的片段当示范用,策略自己生成的片段被丢弃或当作无标签数据;而部署经验里大部分正是策略自己生成的。第二类是在线强化学习:它能同时利用接管和策略执行的数据,但通常依赖用稀疏的回合级成败信号训练的价值函数或 critic,作者认为这样的弱监督难以稳定地评估高维动作块,训练更复杂也更不稳定。
相关工作一节里,作者逐个说明了几种系统各自只闭合了回路的一部分(以下是作者的描述):RoboCopilot 的流程仍是按轮次的,部署的策略来自批量重训;RECAP 用优势条件化扩展全模型的人在回路改进,但仍通过分阶段的离线更新进行,并把完全并发的在线框架留作未来工作;RL Token 在冻结的预训练策略之上训练轻量的 actor-critic,不更新完整骨干;Hi-ORS 用基于结果的拒绝采样避开 critic,但仍依赖轨迹级的结果监督;ConRFT 保留 Q 函数,并用人工接管来门控在线微调。TIDE 选择的位置是:真机部署留在数据回路里,视频骨干、跨模态适配器和动作专家一起更新,监督按动作来源组织,而不是按学到的价值或轨迹级奖励标签。
论文把人在回路学习定位为针对协变量偏移和误差累积的做法:人可以在当前策略自己走到的状态上接管。物理AI实验室 1.6:模仿学习讲过误差怎样滚出示范覆盖的范围;物理AI实验室 1.7:强化学习讲过奖励写法和 critic 的训练目标。TIDE 绕开的正是后者:回合成功与否只决定这一回合能不能进入在线数据集,不作为奖励、模型条件或训练目标。本站专题前沿雷达专题|训练与自我改进把 VLA 后训练分成三个阶段,最后一段是从部署经验中学习;TIDE 是这一段里不用价值估计的一种做法。
同一次会话里的三部分:机器人端、推理与记录服务器、在线学习器
TIDE 改造的是一个预训练的世界-动作策略:视频生成骨干根据观测和语言指令产生一个紧凑的“世界先验”,流匹配(flow matching)动作专家对这个先验和机器人状态做交叉注意力,生成一个 50 步的动作块,骨干同时预测同一时间跨度内的未来视频帧。部署前,所有可训练模块先在目标任务的离线遥操作数据上预热。论文报告的策略有 3B 参数,在八块 H100 上训练。
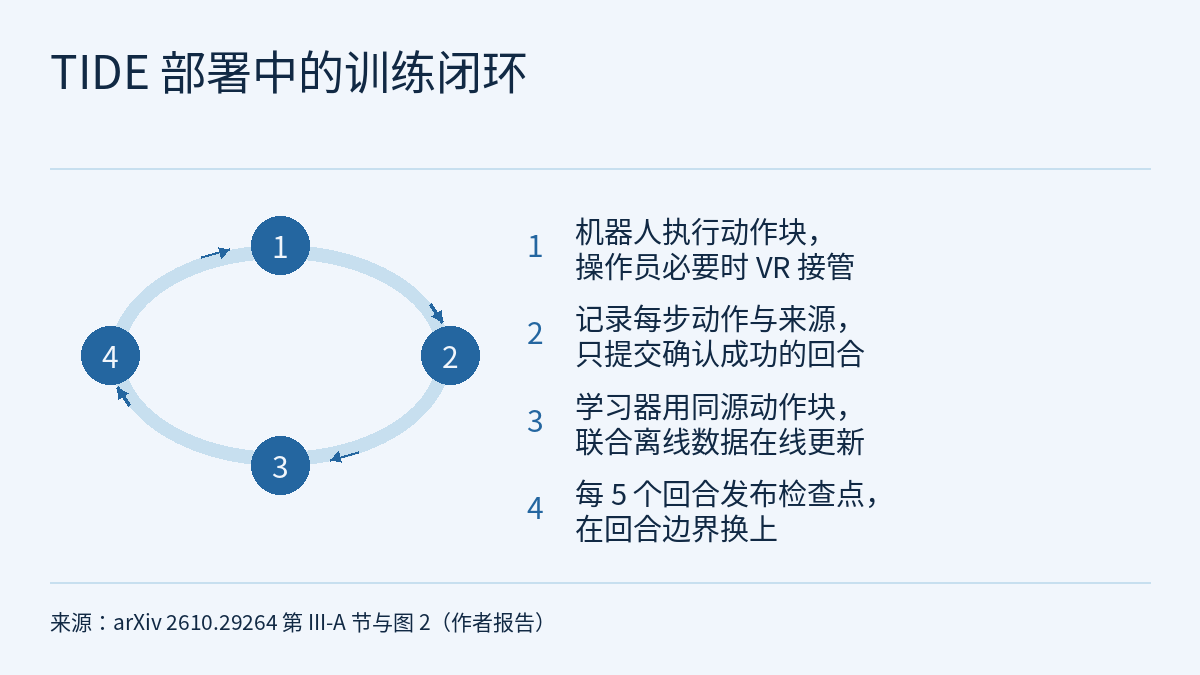
- 机器人端负责低延迟控制:每个控制步采集观测、向服务器请求动作块,除非操作员接管就执行策略动作。作者借鉴 RTC 采用异步实时分块:已确定的动作继续执行,后续动作在后台刷新,以减少推理造成的停顿、让相邻动作块之间衔接更平滑。接管时,操作员用 VR 增量控制围绕当前状态下达小幅运动,不必重置回合就能把控制权交还策略;每次交接都会清空排队中的策略动作块,避免执行过期动作。执行记录和接管标志异步上传,不占用控制的关键路径。物理AI实验室 2.3:微调 SmolVLA为另一个系统的异步推理算过动作队列的时间账,可以对照阅读。
- 推理与记录服务器集中运行 GPU 推理,并把在线回合写进共享数据集。回合结束时,由操作员人工确认任务是否完成;只有确认成功的回合才提交,失败、超时、中止或停止、完成前被重置、重新录制、过期和未恢复的回合都丢弃。服务器只在回合边界换用学习器产出的检查点,保证每个回合只由一代策略生成。
- 在线学习器在新提交的记录到达后,用在线数据和离线任务数据联合更新视频扩散骨干、跨模态适配器/Q-former、动作专家和来源嵌入;预训练的文本编码器和视频 VAE 保持冻结。每新提交一个控制帧,学习器分配 0.2 个优化步;每提交五个回合发布一个检查点,服务器预取新权重,在下一个回合边界换上。
论文给出的时间口径是:对每个任务,从开始在线人在回路执行到最后一个检查点可部署,连续墙钟时间不到一小时。这个区间包括异步的数据处理、训练、检查点处理、机器人执行、人工接管和回合重置,不包括初始准备和最终的自主评测。在这套设置上,每个在线优化步约 0.4 s。Bit Insertion 一项给了具体数据:共提交 41 个回合、38,839 个控制帧(30 Hz 下 21.6 分钟),其中人控 1,432 帧(3.69%),策略控 37,407 帧。
按论文给出的比率粗算(本站换算,论文没有报告实际的优化步数和检查点数):0.2 × 38,839 ≈ 7,768 个优化步,按每步约 0.4 s 约为 3,107 s,即约 52 分钟;41 个回合每五个发布一次,约发布 8 个检查点。若每个动作步对应一个 30 Hz 控制帧,一个 50 步动作块约覆盖 1.67 s(同为本站换算)。
来源标签:一个 50 步动作块要么全是人,要么全是策略
在线回合里人工接管和策略执行交替出现。TIDE 不把整段回合当成一条示范,而是在动作块一级打标签:每个控制步都记录发给机器人的动作,以及它出自操作员还是策略。一个动作块全部由人执行,标签为 0;全部由策略执行,标签为 1;人和策略的步混在一起,标签为 ∅。一个 50 步的目标动作区间只有在 50 个动作同源时才得到人或策略的标签;∅ 区间不参加来源条件化训练,交接点前后也没有额外的排除窗口。
论文反复强调两条边界。第一,来源标签只表示动作的执行来源,不是奖励、正确性标签或质量分数。第二,回合成功只用来决定这一回合能否进入在线训练集,不是模型条件、奖励、来源标签或训练目标。训练时,每个来源标签对应一个可学习的嵌入,加到视频骨干和动作专家的流时间嵌入上;目标函数是未来视频和动作两项流匹配损失之和。论文报告的所有在线自主回合和最终无接管评测,都把来源条件固定为人类模式(ℓ = 0)。
数据配比同样写明:离线遥操作数据一律当作人类来源(ℓ = 0)的动作块;学习器分别维护离线和在线两个缓冲区,在线样本与离线样本的权重为 5:1,即两者的抽取概率为 5/6 和 1/6。α = 5 是初步调参选出的,所有任务和变体都固定使用。在在线缓冲区内部,人执行和策略执行的动作块做了平衡,以免稀少的接管数据被大量自主执行的数据淹没。另有两种保持任务成立的数据扩增:任务在镜像下仍成立时,沿工作空间对称面镜像观测、状态和动作;按不同执行速率重采样动作块和对应的未来观测。扩增样本继承原动作块的来源标签。
由标签定义可以推出一点(本站推论,论文没有讨论):既然一个区间要 50 个连续动作同源才算“人执行”,一次短于 50 个控制步的接管就不会产生任何人类标签的区间,它所在的区间都会标为 ∅ 而被排除。Bit Insertion 中人控帧只占 3.69%,论文没有报告其中有多少落进了纯人类区间、有多少区间被标为 ∅。
评测:每组 20 次无接管、两个指标、三个对照
所有真机实验都在双臂 UR5e 平台上进行,夹爪为 Robotiq 2F85,配一台第三人称 RealSense D455 和两台腕部 RealSense D405。四项任务及其里程碑是:Bit Insertion(把螺丝刀批头插进批头座;拾取、插入),Towel Folding(把摊开的毛巾铺平并折成方块;铺平、第一折、第二折),Towel Hanging(把毛巾挂到衣架上;拿起衣架、放上毛巾、挂起衣架),Chain Packing(把金属链条装进盒子;放入链条、合上盖子、塞好盒舌)。策略输出 50 步、14 维、相对关节的双臂动作块:每个预测偏移加到当前关节状态上,再作为绝对关节目标交给控制器。选这种动作表示之前,作者在相同数据、初始化和训练预算下比较了八种只做离线训练的动作空间,相对关节动作在这项对照研究中最好。
每个“方法-任务”组合都从同一组预设初始状态出发,跑 20 次自主执行,全程无人接管。任务进度按里程碑归一化:每次执行完成的里程碑数除以该任务的里程碑总数,再对 20 次取平均;因超时、安全停止或任务失败结束的执行,只计已经稳定完成的里程碑。完整完成另记为 k/20,只有全部里程碑完成才算。之所以只用无接管评测衡量任务表现,是因为采集时人的接管可以把本会失败的回合补成功。
三个对照都从同一个任务专属的预热检查点出发:Warm 即预热策略本身;Offline 新采集与在线数据量相当的遥操作示范,并训练与 TIDE 相同的优化步数;Fixed Policy 在与 TIDE 时长相当的人在回路采集中保持预热策略不变,采完后再用相同的目标函数、缓冲区设置、过滤规则和总优化预算训练。论文对结果的文字描述是:
- 在里程碑归一化进度上,Fixed Policy 和 TIDE 在四项任务上都在数值上高于 Warm 和 Offline。
- TIDE 在 Bit Insertion 和 Towel Hanging 上的进度与 Fixed Policy 持平,在 Towel Folding 和 Chain Packing 上更高。
- 完整完成次数在 Bit Insertion 上持平;在两项毛巾任务上 TIDE 多 1 次,在 Chain Packing 上多 2 次(均为 20 次中)。
- 作者据此称,两者在这套评测下最终表现相当;TIDE 的区别在于更新后的检查点在部署会话中就能用上,而不是要等一轮单独的采集、训练和再部署。
所读正文没有列出图 6 中各方法的具体百分比。按每组 20 次计,多 1 次完整完成相当于 5 个百分点(本站换算)。物理AI实验室 1.8:评测练过怎样把这样的小差距拆成配对结果;本站前沿雷达|Beyond Binary Success介绍过在真机次数有限时,用序贯检验比较策略的统计方法。这些问法同样适用于 TIDE 与 Fixed Policy 之间 1–2 次的差别。
另外两组诊断都只在 Bit Insertion 上做。消融实验中,各变体从同一个预热检查点出发,使用相同的在线交互预算,用同一组初始状态各跑 20 次无接管评测:TIDE 的归一化进度为 80.0%,去掉来源条件化为 65.0%,只用人执行的在线动作块为 67.5%。作者称这项单任务消融同时支持显式的来源条件化和使用策略执行的动作块。接管比例按每个训练回合中处于人工接管的控制步占比计算:论文图 8(a) 中,最近五个提交回合的帧加权比例在早期部署阶段之后下降。作者明确说明,这条曲线只反映监督负担,不是自主性能的度量,单凭它也无法把学习效果与时间因素分开。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。所读文本给出了项目页地址,但没有说明代码或模型权重是否发布;本站没有打开项目页。
- 作者自己列出的局限:TIDE 需要人工监督;只保留人工确认成功的回合可能引入选择偏差;评测只覆盖一个双臂平台、四项任务和一个世界-动作骨干,没有测试长期保持和对在线训练日程的敏感性,也没有测量重复多次在线后训练会话之间的差异。跨平台和跨架构的泛化因此尚未验证。
- 与 Fixed Policy 相比,作者自己的结论是“表现相当”,不是“更好”;完整完成次数的差别只有 0–2 次(每组 20 次)。所读正文没有图 6 的具体数值,本文只转述论文的文字比较。
- 来源条件化的消融(80.0%、65.0%、67.5%)只在 Bit Insertion 一项任务上做。接管比例下降不是自主性能的度量。
- “不到一小时”是从在线执行开始到最后检查点可部署的墙钟时间,不包括初始准备、离线预热和最终评测,并且是在八块 H100 上训练一个 3B 策略的条件下。第二节的约 7,768 步、约 52 分钟、约 8 个检查点和约 1.67 s 是本站按论文比率做的换算;第三节关于短接管的说法是本站从标签定义推出的,论文没有报告相应数据。
- 论文中的人工接管是数据采集机制,所读文本没有把它作为安全评估;这些真机结果也不是硬件安全验证。
链接
- Training in Deployment: Human-in-the-loop Online Post-Training for Robot Manipulation(arXiv 2610.29264)
- 论文 HTML 全文
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- 物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账
- 前沿雷达专题|训练与自我改进:VLA 后训练的三个阶段与在线 RL 的 task collapse
- 前沿雷达|Beyond Binary Success:真机评测次数有限时,用序贯检验更早分出策略优劣
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)