本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
同样一只手臂,凭什么你说一句话,它就照着做?这一集,我们微调一个开源基础模型。让它听懂一句话,再去抓东西。它叫 SmolVLA。
语言指令到动作
上一集的 ACT,只会一个任务。你换句话,它听不懂。它没学过语言。为什么只会一个?它只照着那套示范学。没教过别的,就不会别的。我们想要的是这样。给它一句话,再加上画面。它就输出该做的动作。对机器人来说,这句话就是任务。它得先听懂,再动手。这种模型有个名字:视觉语言动作模型,简称 VLA。它把三样东西一起吃进去:画面、机器人状态,还有你那句指令。少一样,都抓不准。好处很直接。换个说法、换个目标,不用重训。它也能试着做。比如,一会儿说放进盒子,一会儿说放到左边。同一个模型,都能试着去做。效果好不好,要看训练数据里有没有类似的指令。但基础模型没见过你的手臂、你的桌子。所以还得微调一下。文档建议,先录五十段左右的示范。
SmolVLA 是什么
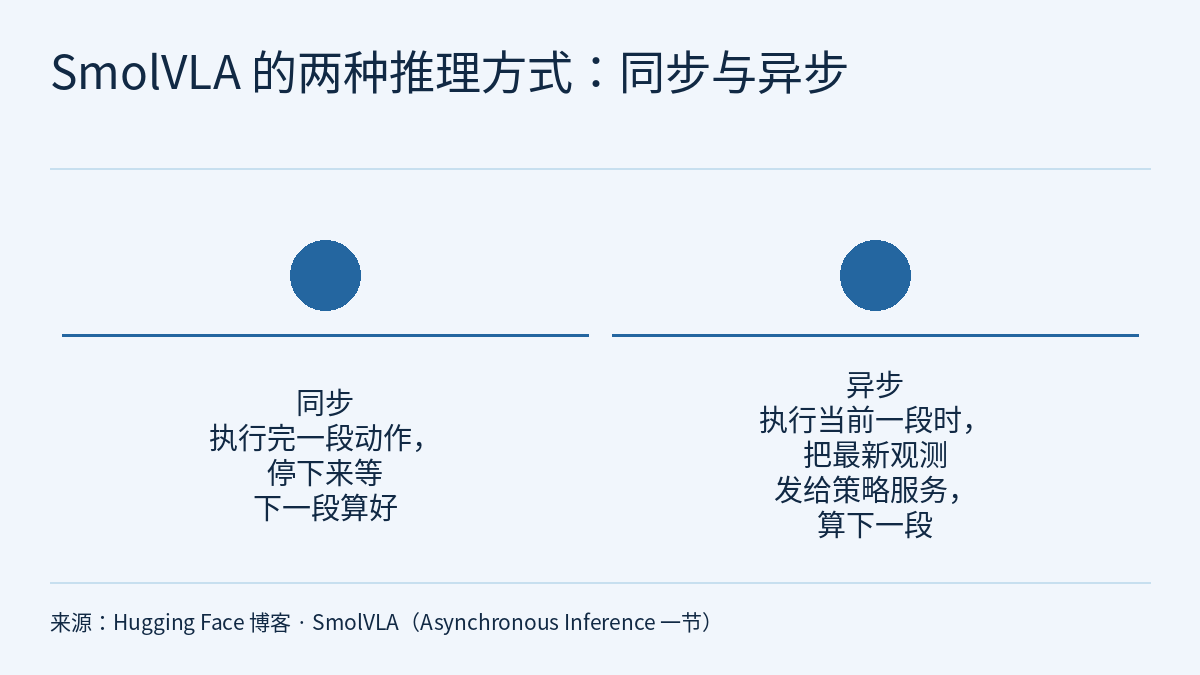
我们用的基础模型,是 SmolVLA 的开源基础版。来自 Hugging Face,可以直接下载。它站在一个看过海量图文的模型肩膀上。所以它本来就认得杯子、盒子。语言这块,它早通了。换句话说,认识世界的活,大模型替它干了。它只要专心学动作。个头不大。官方博客说,它是四亿五千万参数的紧凑模型。论文称,它个头很小。表现却能追上大十倍的模型。它怎么出动作?靠一个动作专家。把随机噪声,一步步修成顺滑动作。为什么用这套?因为它能一口气出一段,不用一个一个蹦。动作顺,机器人才不抖。一抖,就可能把东西碰翻、抓空。它还有个本事:动作和计算同时进行。一边执行动作,一边在后台算下一段。好处呢?团队称,响应快三成,单位时间完成的任务数还能翻倍。原来一句话就能指挥它,还是个能跑在小显卡上的小模型!
动手微调一次
打开本集 Notebook。装好 SmolVLA 所需的依赖。再确认显卡能用。这一步不能省。缺显卡,微调慢得没法用。手头没有,就租一块云上的。数据还是上一集那份 SO-101 抓放。同一份数据,换个更聪明的模型。省得重录一遍。换个模型继续用,就是想比一比。同样的数据,VLA 到底强在哪。训一训就知道。先看数据。每段示范都带一句任务描述。那就是要教它听懂的话。关键一步:从基础模型微调,不从零训练。基础模型见过很多操作。省数据,也省时间。微调时,基础模型的大部分本事保留。只在你的数据上,微微调整。这就像老师傅带新徒弟。底子都在,只要点拨你这份活。一行命令。告诉它基础模型在哪,数据在哪,算在显卡上。最关键的,就这三个。其余参数,先用默认值。第一次跑,显存可能不够。把批量大小往下调。慢一点,但能挤进小显卡。批量大小和训练多少步,先设小,做冒烟测试。跑通了,再按文档放大。正式微调要多久?文档说,要训练两万次迭代,单块 A100 上大概四小时。训练时照样盯损失。评测时,把模型放回真机,用同一句话让它做。评测也别只看一次。多试几种说法、几种摆位,才看得准。数字才不虚。
结果与边界
再说说结果。有个数字,很说明问题。它讲的是社区数据预训练。团队实验显示:预训练之后,SO-100 上成功率跳到七成八。预训练,就是先在一大堆操作上打底子。再学你的小任务。底子越厚,学得越快。这也是一条大趋势:大模型打底,小数据收尾。省钱又省力。所以顺序是:先预训练打底子,再用你的少量数据微调。团队称,边做边算还让它更抗干扰。你推它一下、挪动物体,它也能接着做。这在真机上很关键。所以,边执行边算,不只是快。它让机器人对突发情况,反应更跟得上。不过这种异步方式有代价。它要一个策略服务在后台跑,多搭一层。小项目可以先不用。还有一点没解决的。换个没见过的物体,它照样可能失手。还有个坑:话说得越离谱,它越可能乱来。指令要贴着它学过的说。说到底,它只是个学生。你教过的,它才答得好。语言带来灵活,但泛化还是靠数据。越多、越多样,越稳。回顾一下,三个要点:一,VLA 把画面和一句话,一起变成动作。二,SmolVLA 小,四亿五千万参数,能在小显卡上微调。三,边执行边算,响应速度更快。但换个没见过的物体,还得靠更多数据。所以一句话就能改任务,靠的是它见过的世界够大够杂!那要教它走路,得在虚拟世界里练无数遍,又怎么练?下一集见!
证据与出处
10 倍 · SmolVLA 论文称,尽管个头小,其表现可媲美参数量约大十倍的 VLA 模型 [R] · arXiv 2506.01844 · SmolVLA
快 30% · 异步推理让响应快约三成、单位时间完成任务数翻倍(SmolVLA 团队,真机实验) [O] · Hugging Face 博客 · SmolVLA
78.3% · 社区数据预训练后 SO-100 成功率达 78.3%,比不预训练高约 26.6 个百分点(SmolVLA 团队实验) [O] · Hugging Face 博客 · SmolVLA
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
第 2.3 集的视频把上一集的 ACT 换成 SmolVLA。SmolVLA 是一种视觉-语言-动作模型(VLA),把画面、机器人状态和一句语言指令一起变成动作。视频讲了三件事:VLA 把指令也当作输入;SmolVLA 紧凑(约 4.5 亿参数),从开源基座 smolvla_base 微调,而不是从零训练;异步推理边执行边算下一段,但换成没见过的物体,泛化仍要靠数据。片中的数字卡来自三份公开材料:Hugging Face 的 SmolVLA 博客、LeRobot 文档的 SmolVLA 页面,以及 SmolVLA 论文(arXiv 2506.01844)。本篇是这一集的图文课与练习,不重复文字稿,而是做三件视频只点到的事:看清那句指令在模型、数据和评测命令里分别是什么;把每个数字放回它自己的实验或文档条件;用一个虚构的动作队列算清,异步推理什么时候能不空等,什么时候仍会断档。贯穿全文的规则:一个数字只描述测出它的那个模型、平台和设置;评测时用的指令,要能对回录制时写进数据的那一句。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 2.2:用 LeRobot 训练 ACT,把数据集元数据对到模型输入,再逐项核对训练与评测命令结尾问:要让它听懂一句话再动手,又该怎么训?本课接着回答。lerobot-train 里 –dataset.repo_id、–policy.device、–output_dir 等参数的读法,以及步数、批量与样本数怎样分开记账,2.2 已经讲过;一个成功率要写清条件、配对和试验次数,物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账已经练过。本课不再重复,只讲 SmolVLA 新带来的部分:语言指令怎样进模型、从基座微调的数据配方与命令,以及异步推理。
公开小测的 5 道题附完整解析;登录后可完成三项练习:为一个虚构的“放进左盒或右盒”任务规划示范段数、写出指令字符串与微调命令;给公开材料里的八个数字建一张口径账,复算后判断四条说法;为一个虚构的异步动作队列算时间余量,再审三种部署说法。每项都附分步解法、常见错误与 20 分评分标准。
一、三份材料,各自说了什么
Hugging Face 博客和 LeRobot 文档是 SmolVLA 团队对自家模型的介绍,按本课程的分级属 O 级;论文是预印本,属 R 级,本课只读了它的摘要。三者给出的数字都是作者报告,本站没有复现其中任何一项。片中数字卡对应的原文如下,各自独立摘录。
博客:
Today, we introduce SmolVLA , a compact (450M), open-source Vision-Language-Action model for robotics that runs on consumer hardware.
Supports asynchronous inference for 30% faster response and 2× task throughput .
After pretraining on community-collected data, performance jumps to 78.3% , a +26.6% absolute improvement .
论文摘要:
Despite its compact size, SmolVLA achieves performance comparable to VLAs that are 10x larger.
文档(第一句说的是一个只有 25 段的类似数据集):
it was not enough leading to a bad performance
Training the model for 20k steps will roughly take ~4 hrs on a single A100 GPU.
同一批材料里还有几个相关数字。下表把它们和各自的条件放在一起,是本课对原文的整理,不是原文句子:
| 数字 | 出处与等级 | 度量的对象 | 页面写明的条件 | 本课读到的文本没有写明的 |
|---|---|---|---|---|
| 450M | 博客,O | SmolVLA 整个模型的参数量 | 紧凑、开源,可在消费级硬件上运行 | — |
| 约 100M | 博客,O | 动作专家(两个核心组件之一)的参数量 | 一个用 flow matching 训练的紧凑 Transformer | — |
| 10× | 论文摘要,R | 与约大 10 倍的 VLA 表现相当 | 在多个模拟与真实机器人基准上评测 | 摘要没有点名对比的模型和具体基准 |
| 约 30%(9.7 s 对 13.75 s) | 博客,O | 异步比同步平均完成一个任务快 | 真实世界任务;两种模式成功率相近(约 78%) | 这一段没写机型和试验次数;TL;DR 把它写成 response |
| 2×(19 对 9 个方块) | 博客,O | 固定时间内完成的数量 | fixed-time settings | 固定的时长 |
| 78.3%(不预训练为 51.7%) | 博客,O | SO100 上的成功率,比较有无社区数据预训练 | 页面称其为 Table 1 的结果 | 表格内容与试验次数 |
| 约 50 段(25 段不够) | 文档,O | 建议起步录制的示范段数 | 每种变化都要有足够的示范 | 不是成功率的保证 |
| 2 万步约 4 小时 | 文档,O | 用 smolvla_base 微调的时长 | 单块 A100;步数应按效果和用途调整 | 这一句没写批量(同页命令示例用 64) |
读这张表要注意三点:
- “30%”和“2×”是两种度量。结果段写的是异步完成任务约快 30%(9.7 s 对 13.75 s),以及固定时间内完成数翻倍(19 对 9 个方块)。前者是平均用时,后者是计数,页面没有给出固定时长,不能从一个数推出另一个。
- “+26.6%”是百分点。78.3 − 51.7 = 26.6,是绝对差;换成相对提升要另算。
- 两个“78%”不要合并。预训练对比的 78.3% 和同步/异步对比里“两种模式都约 78%”出自博客里两段不同的结果;本课读到的文本没有说明它们是否来自同一组试验,所以分开记录。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- SmolVLA 博客属 O 级,发布于 2025 年 6 月 3 日;LeRobot 文档 SmolVLA 页面属 O 级,读的是不带版本号的地址;两者都抓取于 2026-10-17。博客的命令用脚本路径,文档用 lerobot-train,命令名和参数可能随版本变化;本课没有绑定 LeRobot 版本。论文属 R 级预印本,本课只读了摘要。
- 450M、约 100M、10×、约 30%、2×、78.3%、约 50 段与 2 万步约 4 小时都是作者报告,本站没有复现。本课读到的博客文本没有包含表格内容,所以不知道这些结果的试验次数;同步/异步那一段也没有写明机型。
- 页面文本在提取时,命令的多处等号后和 ${HF_USER} 两侧带空格,–policy.type 被拆开;本课去掉了这些空格。文档“没有 GPU 时可以用 Notebook 训练”那一句被截断,本课没有补写。
- 以下是本课的推断或假设,原文没有这样写:把 70% 读作剩余队列占块长的比例;把每路相机的一张图算作一帧;拼接会改变实际执行的动作;新块一到就能用;“每种变化 10 段”可以作为规划参考。
- 团队 M 与 V、block_two_boxes、位置与目标盒、冒烟测试取值、块长、执行速率、延迟、服务器位置和练习里的报告都是虚构的;1.17 s、19.4%、80 段、87.5%、46.7% 等只在这些假设下成立,不是任何系统的性能。
- 本文没有运行片中 Notebook、训练或评测命令。评测命令和策略服务会驱动真实机械臂;硬件安全措施不在本课范围内,纸面计算和仿真结果都不是硬件安全验证。