複数のスキルを順につなぐとき、難しいのは個々のスキルよりも、そのあいだの遷移であることが少なくありません。前のスキルが終わった時点の状態が、次のスキルが学習中に見た開始状態とは限らないからです。プレプリント DexStitch(arXiv 2610.17789、2026-10-13)は、「遷移」も通常のスキルラベルの 1 つとして定義します。長いタスクを通した人間の動画(計約 240 本)の一部に人手でフレーム単位の注釈を付け、残りを分類器でスキルと遷移に切り分けたうえで、指ごとの接触推定を手がかりに人の手を多指ハンドのロボットに置き換えて、スキルラベル付きのロボットの観測と行動を得ます。遷移の教師信号はすべて人間の動画から得ており、遠隔操作で補ったのは単一スキルのデモ約 32 本だけです。著者の報告では、4 つの家事スキルで単一スキルの成功率は 80.0%、4 スキルの系列のなかでは 77.5%、分類器と人手による注釈のフレーム単位の一致率は 92.4% でした。この論文を読むときは、まず 77.5% が何を数えた値なのか、そしてそれが 1 つの固定した順序でしか測られていないことを押さえておく価値があります。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
問題:スキル間の遷移を誰が教えるのか
著者は長いタスクの操作を「基本スキル+それらをつなぐ遷移」と捉えます。スキルを順に実行できるようにするには両方に教師信号が必要ですが、ロボット上で遠隔操作と人手の注釈によって集めるのは高コストです。人間の動画は撮りやすい一方、ロボットの行動もスキルラベルもありません。論文は既存研究を 2 つの系統に分けています。1 つは人とロボットのあいだで共有の潜在スキル空間を学習するもので(XSkill、UniSkill)、スキルの構造は連続的な潜在変数を通じて伝わり、方策には次にどのスキルが来るかが知らされません。もう 1 つは人の動きをリターゲットし、人の身体をレンダリングしたロボットに置き換えるもので(Phantom、Masquerade、H2R、EgoEngine)、1 本のデモは 1 本の軌道として扱われ、スキルや遷移の境界は示されません。
DexStitch はその逆を選びます。ユーザーがあらかじめスキルの集合を決め、遷移もそのラベルの 1 つとし、一部の動画にフレーム単位で注釈を付けて、残りの動画を切り分ける分類器を学習させます。順序付きのスキルの組ごとにそれぞれ遷移が必要になるため、著者は遷移を 1 つずつ集めるのではなく、多くの遷移を含む、長いタスクを通した人間の動画を収録しています。
人間の動画からロボットのデータへ:接触に導かれたリターゲティングと 4 層の合成
変換は 3 段階で、フレームごとに行います。そのため、変換後の各フレームは元のフレームのスキルラベルをそのまま保ちます。
- 手の姿勢と接触:HaWoR がカメラ座標系で MANO の手モデルを当てはめ、手のキーポイントと手首の姿勢を求めます。HaCo が MANO の頂点ごとに接触確率を予測し、それを指ごとにまとめてヒステリシス付きのしきい値処理を行い、時間的に安定した指ごとの接触状態を得ます。接触している指については接触点を保持します。
- 接触を考慮したリターゲティング:まず DexPilot で手首から指先へのベクトルを合わせ、運動学的な初期値を得ます。人の手とロボットの手は形が違うため、指先だけを合わせても人が実際に触れた点に届くとは限りません。そこで第 2 段階では L-BFGS-B で関節角を最適化し、人の手の各接触点からロボットの指先表面上の最も近い点までの距離を最小化します(法線が人の接触点の法線とそろう表面点に限定)。2 次の正則化項で第 1 段階の解から離れすぎないようにします。腕については、カメラからベースへの変換を EasyHeC で一度だけ校正し、逆運動学を解きます。フレームごとの結果はメディアンフィルタと Savitzky–Golay フィルタで平滑化します。
- インペインティングと合成:SAM2 が人の手と腕、操作される物体という 2 組のマスクを追跡します。ProPainter で人の領域を修復し、物体のマスクは保護します。そのうえで、リターゲティングした構成と校正済みの姿勢でロボットをレンダリングします。
ロボットをそのまま画面に重ねると、本来は物体の後ろに回るはずの指が物体の手前に描かれてしまいます。著者の対処は 1 つの仮定に基づいています。手が物体を包むとき、親指は物体の手前にあり、ほかの指は後ろに回り込んで対向把持をつくる、というものです。そこで、親指以外の接触している指の 3 次元の接触点を画像に投影し、膨張させて連結した領域にします。この領域が物体のマスクと重なる部分では、物体をロボットより手前に描きます。各フレームは奥から手前へ 4 層で合成します。
- 修復した背景
- 物体に隠れるロボットの指
- 元のフレームから写した物体(修復後の画像は使わない。修復で変わるのはまさに手と物体が触れていた領域だから)
- 残りのロボットの画素
論文は、この処理が RGB 動画だけを使い、物体のメッシュ、深度、物理シミュレータを必要としないと述べています。変換の品質は定性的にしか比べていません(図 4:スポンジを持つ、スナックの箱を持ち上げる、マグカップをラックに掛ける)。著者の説明では、Masquerade の平行グリッパーは多指の把持を表現できず、グリッパーが物体の上に描かれます。接触に導かれた遮蔽処理を外すと、手が物体の手前に描かれ、把持が宙に浮いているように見えます。変換品質の定量的な指標は示されていません。
スキル分類器と「次のスキル」を条件にした方策
分類器:凍結した V-JEPA 2 の動画エンコーダに小さな MLP ヘッドを付けたもので、学習するパラメータは 296K だけです。エンコーダは 4 FPS でサンプリングし、2 フレームごとに 1 トークンを出すので、分類器は 2 Hz で動画を読みます。直近 8 トークン(4 秒分の文脈)の因果的な窓を見て、最新の時点のスキルを予測します。著者は、エンコーダを凍結しているからこそ、手元にある少数の注釈済みセッションから分類器を当てはめられるとしています。フレームごとの予測は時間方向のフィルタをかけ、順序付きのスキル区間の列にまとめます。
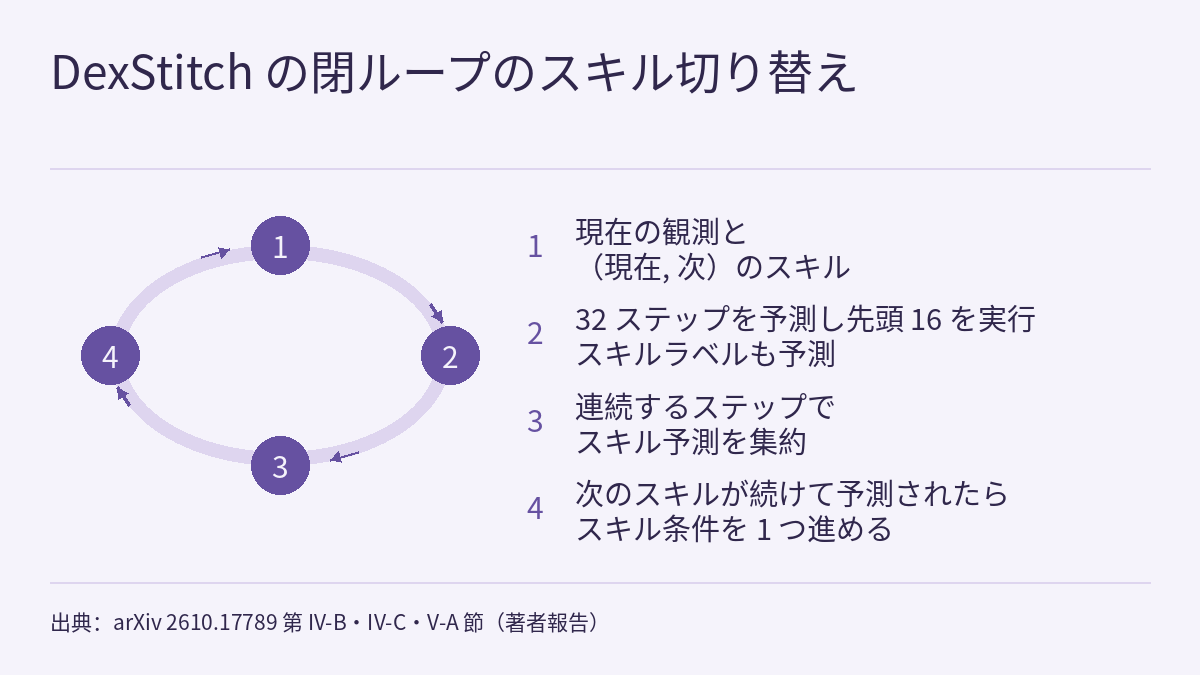
方策:1 つの共有の Diffusion Policy で、現在の観測、現在のスキル、次のスキルを条件として、行動のチャンクを出力し、同じ期間のスキルラベルもあわせて予測します。現在のスキルは何をするかを決め、次のスキルはその動作をどう終えて後に続けるかを方策に伝えます。推論時は、方策が連続する複数の時間ステップで次のスキルを予測し続けたときにだけ現在のスキルが完了したとみなし、条件を 1 つ進めます。複数ステップで集約するのは、単発の予測で早すぎる切り替えが起きないようにするためです。スキルの列はスクリプトで与えることも、同じ分類器で人間のプロンプト動画から取り出すこともできます。
実装の詳細:観測は 224×224 の RGB 画像と、33 次元の固有感覚とスキルの状態(手首の 3 次元位置と 6 次元の回転、手の関節角 12 個、現在と次のスキルの 6 + 6 次元の one-hot)です。実行時は、腕の 6 自由度を予測した手首姿勢から逆運動学で求め、手の 12 関節はそのまま指令し、合計 18 自由度になります。観測履歴は 2 ステップ、予測ホライズンは 32 で、そのうち先頭 16 の行動を実行し、20 Hz で動かします。推論では DDIM で 10 ステップのノイズ除去を行います。約 240 本の変換済みの人間のデモで 120k ステップ事前学習し、遠隔操作のデモ約 32 本(各スキル約 8 本、それぞれ単一スキルのみ)を混ぜて 70k ステップ微調整します。GPU は NVIDIA A100 1 基です。ハードウェアは RB5-850E のアームと xHand の多指ハンド、カメラは Intel RealSense D435i で、RGB だけを使います。
結果:77.5% は何を数えているか
4 つのスキルは、緑の箱のピック・アンド・プレース、赤の箱のピック・アンド・プレース、コップのタスク、ボウルの積み重ねです。比較手法の UniSkill は、同じ変換データ、同じ 120k ステップの事前学習と 70k ステップの微調整を使い、スキルの表現だけが異なります。
| 手法 | 単一スキル:緑 / 赤 / コップ / ボウル | 単一スキルの平均 | 系列のなか:緑 / 赤 / コップ / ボウル | 系列の合計 |
|---|---|---|---|---|
| UniSkill | 80 / 20 / 20 / 60 | 45.0 | 0 / 0 / 0 / 0 | 0.0 |
| DexStitch | 100 / 100 / 40 / 80 | 80.0 | 80 / 70 / 80 / 80 | 77.5 |
分母は小さいものです。単一スキルの設定では各スキル 5 回なので、100% は 5/5、40% は 2/5 で、平均 80.0% は 20 回中 16 回にあたります。系列の設定は 4 スキルの系列を 10 回、つまりスキルの実行が 40 回(各スキル 10 回)で、77.5% は 40 回中 31 回に相当します(本サイトによる換算)。つまり 77.5% は「系列のなかでのスキル 1 回ごとの実行」の成功率であり、「4 つのスキルをすべてやり遂げた系列」の割合ではありません。10 回の系列のうち 4 段階すべてに成功したのが何回だったのか、あるスキルが失敗した後に続くスキルを実行し続けたのかリセットしたのかは、論文に書かれていません。コップのタスクの呼び方も一致していません。タスクの一覧では「コップを手渡す」(handing over a cup)、表 I の説明では「コップを掛ける」(hanging a cup)となっています。
著者は UniSkill との差をスキルの表現、とくに遷移をモデル化しているかどうかに帰しています。根拠は、両者がデータと学習の予算を共有していることです。この帰属は著者の解釈であり、別途検証されてはいません。
分類器:240 本の人間のデモのうち 216 本で分類器を学習し、残りの 24 本(18,792 フレーム)で評価しています。比較対象はゼロショットでプロンプトを与えた 2 つの視覚言語モデルで、同じ 2 Hz の判定時刻、同じ因果的な窓で、同じ閉集合の質問に答えます。
| 手法 | 正解率 | Macro-F1 | Edit | F1@50 |
|---|---|---|---|---|
| Qwen2.5-VL-7B(ゼロショット) | 65.8 | 66.0 | 70.3 | 41.0 |
| InternVL3-8B(ゼロショット) | 57.8 | 56.7 | 47.5 | 28.5 |
| V-JEPA 2 + MLP(本論文) | 92.4 | 92.7 | 99.6 | 99.0 |
著者の報告では、本論文の分類器は 242 区間を切り出し(正解は 241 区間)、1 エピソードを除いてスキルの順序がすべて一致しました。差は遷移に集中しており、遷移の F1 は本論文 0.89、Qwen 0.41、InternVL 0.18 です。ただし、これは同じセットアップのデータで学習した分類器とゼロショットのモデルとの比較です。示しているのはこの設定で切り分けが使えるということであり、2 種類のモデルの一般的な能力の比較ではありません。
アブレーション(4 スキルの系列の設定、%):
| 変種 | 成功率 |
|---|---|
| 人間のデータなし | 35.0 |
| 遠隔操作のデータなし | 5.0 |
| 遷移スキルなし | 10.0 |
| 次のスキルの条件付けなし | 7.5 |
| 微調整での遠隔操作の割合 50% / 75% / 100% | 10.0 / 20.0 / 50.0 |
| 完全な手法(遠隔操作 90%) | 77.5 |
著者の解釈は次のとおりです。どちらのデータも単独では足りません。遷移スキルや次のスキルの条件付けを外すと、失敗は主に遷移で起きます。同じ遷移でも、後に続くスキルに応じて異なる状態へ向かわなければならないからです。微調整で合成データを少し残す(遠隔操作 90%)ほうが、遠隔操作のデータだけ(50.0%)より良い結果になります。論文には「すべての変種で同じ 90% の遠隔操作の割合を使う」とありますが、割合を変えた変種と「遠隔操作のデータなし」は明らかにこれに当てはまらないため、表のほうを基準としてください。アブレーションも表 I と同じく 40 回のスキル実行を分母とするなら、5.0% は 2 回、7.5% は 3 回にあたります(本サイトによる推定。論文はアブレーションの分母を明記していません)。試した割合は 50%、75%、90%、100% の 4 段階だけなので、「90% が最良」はこの 4 段階のなかでしか成り立ちません。
本サイトの既存ページとの関係
フィジカルAIラボ 1.5:データはどこから来る?では、人間の動画の難しさを扱いました。人の手はロボットの手ではなく、動画には正確な関節角も力もありません。DexStitch はリターゲティングで関節角を補い、インペインティングと合成で画面をロボットの姿にしています。それでも得られるのは運動学的な軌道で、力や触覚の情報は含まれず、実機での実行とのずれは約 32 本の遠隔操作による微調整に委ねられています。
フィジカルAIラボ 1.6:模倣学習では、誤差がロボットをお手本のカバー範囲の外へ運んでしまうことを扱い、Diffusion Policy の報告値を実験条件に照らして読みました。DexStitch の方策も Diffusion Policy です。同じ問題をスキルの境界で捉えており、前のスキルが残した状態が次のスキルの学習時の開始状態に含まれないかもしれないので、遷移そのものをラベル付きの、教師信号のあるスキルにしています。
フィジカルAIラボ 1.8:評価では、まず分母と条件を確かめる練習をしました。ここでの 100% は 5 回中 5 回であり、系列の結果の単位は系列全体ではなくスキルの実行です。どちらも、紹介するときには明記すべき点です。
フロンティア・レーダー|Cracking Mobile Manipulationも、スキルをつないだ後の性能に注目しており、長いタスク全体の成功率を報告しています。DexStitch の 77.5% は系列のなかでのスキル実行 1 回ごとの成功率です。2 本の論文はロボット、タスク、指標が異なるため、数値を互いに比べることはできません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトではどの結果も再現していません。本サイトが読んだ本文にはコードやプロジェクトページへのリンクがなく、本記事でもリンクしていません。
- 著者自身が 2 つの制約を挙げています。合成は包み込む把持(親指が手前、ほかの指が後ろ)を仮定しているため、つまむ把持や上からの把持はこのルールの対象外です。また、組み合わせは 1 つの固定した 4 スキルの順序でしか評価しておらず、学習に含まれない順序はまだ試していないため、「組み合わせられる」という主張は直接には検証されていません。
- 実機評価の規模は小さく、単一スキルは各スキル 5 回、系列は 10 回です。信頼区間や有意性検定は報告されておらず、系列全体をやり遂げた回数も示されていません。
- 変換の品質は定性的な図だけで、定量的な指標はありません。分類器の比較対象はゼロショットの視覚言語モデルですが、本論文の分類器は同じセットアップの動画 216 本で学習しています。
- すべての実験は 1 組のハードウェア(RB5-850E と xHand、D435i 1 台)と 4 つの家事スキルで行われています。人間の動画とロボットの場面の具体的な対応、撮影した人数、場面のばらつきについて、本サイトが読んだ本文には詳しい説明がありません。
- リターゲティングが保証するのは運動学的な接触点の一致だけで、力は含みません。実機での実行の安全性は論文の範囲外であり、この結果はハードウェアの安全性検証にはなりません。
リンク
- DexStitch: Learning and Composing Dexterous Skills from Human Videos via Contact-Aware Robotic Inpainting(arXiv 2610.17789)
- 論文の HTML 全文
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フィジカルAIラボ 1.6:模倣学習――誤差がお手本のカバー範囲からはみ出すまでを手で計算し、ACT・拡散方策・データのスケーリング則の数字をそれぞれの条件に照らして読む
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フロンティア・レーダー|Cracking Mobile Manipulation:サブタスクでは 80%、つないでモバイル操作にすると 19%――失敗エピソードの原因を割り当ててから、段階ごとに介入する
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)