同じサブタスク VLA が、RoboCasa365 の原子タスクでは 80% 成功するのに、それらのスキルをつないで移動ベースを動かす長いタスクにすると、エージェント型ベースラインの成功率は 19% にとどまります。プレプリント Cracking Mobile Manipulation(arXiv 2610.19600、2026-10-14)は、より強い方策を学習するのではなく、まず 81 件の失敗エピソードを 1 件ずつ原因に割り当て、「最後まで修正されず、タスクの完了を妨げた最初の誤り」を特定します。そのうえで、失敗が集中する 3 つの段階にそれぞれ的を絞った介入を 1 組ずつ加えます(計 4 つ)。基盤となる VLA は最後まで変えません。著者の報告では、開発用エピソードでの成功率は 19.0% から 47.0% に、設計を固定した後のホールドアウトのシードでは 18.0% から 49.0% に、BEHAVIOR-1K の 5 タスクでは 14.0% から 37.0% に、実機の 2 タスクでは 5/20 から 13/20 に上がりました。読みどころは、原因の割り当てルールと、介入を 1 つずつ加えていく実験設計です。後者は、ある段階を直すと失敗が次の段階へどう移るかを示しています。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。
80% と 19% のあいだ:失敗エピソードの原因をどう割り当てるか
評価対象は、RoboCasa365 の 32 の複合タスクのうち、モバイルマニピュレーションを必要とする 20 タスクです。各タスクは 2–15 のサブタスクからなり、作業領域間を移動しながらの物体の運搬、ピック・アンド・プレース、関節をもつ物体の操作を含みます。ベースラインは Harness VLA の階層型設計を改変したもので、上位のプランナーがサブタスクの指示やツールを選び、1 つの共有サブタスク VLA がナビゲーションと操作の両方を担います。この VLA は、RoboCasa365 の学習用分割に含まれる原子タスクのデモとサブタスク単位の区間で学習されています。
各タスクを 5 回ずつ実行して計 100 エピソード、ベースラインの成功は 19 件で、残りの 81 件の失敗エピソードを分析します。原因の割り当てルールは 3 つです。
- 記録された行動、観測、シミュレータの状態を見直し、失敗したサブタスクを特定する。
- 誤りの生じたサブタスクがその後 3 回の再計画以内に完了すれば、回復したものとみなし、主要な原因の割り当てから外す。
- そうでなければ、残りの軌道のなかで、最後まで解消されずタスクの完了を妨げた最初の誤りを特定し、その時刻を t* とする。論文の例では、物体をつかみ損ねてその後も持ち上げられなかった場合は、後の配置ではなく把持に割り当てます。把持が後で回復し、その後で配置に失敗した場合にだけ配置に割り当てます。
オフラインの診断では、実行の動画、プランナーとのやり取りの履歴、ロボットの状態、シミュレータ内の物体の状態を確認します。シミュレータの状態は診断にのみ使い、オンラインで動くエージェントには与えません。候補ラベルは 3 回の独立した Codex の診断から得て、人間のレビュアーが上記のルールで確認します。無作為に抽出した 30 件の失敗エピソードでは、3 名のレビュアーの判断が 26 件で完全に一致し、Fleiss’ κ = 0.86 でした。
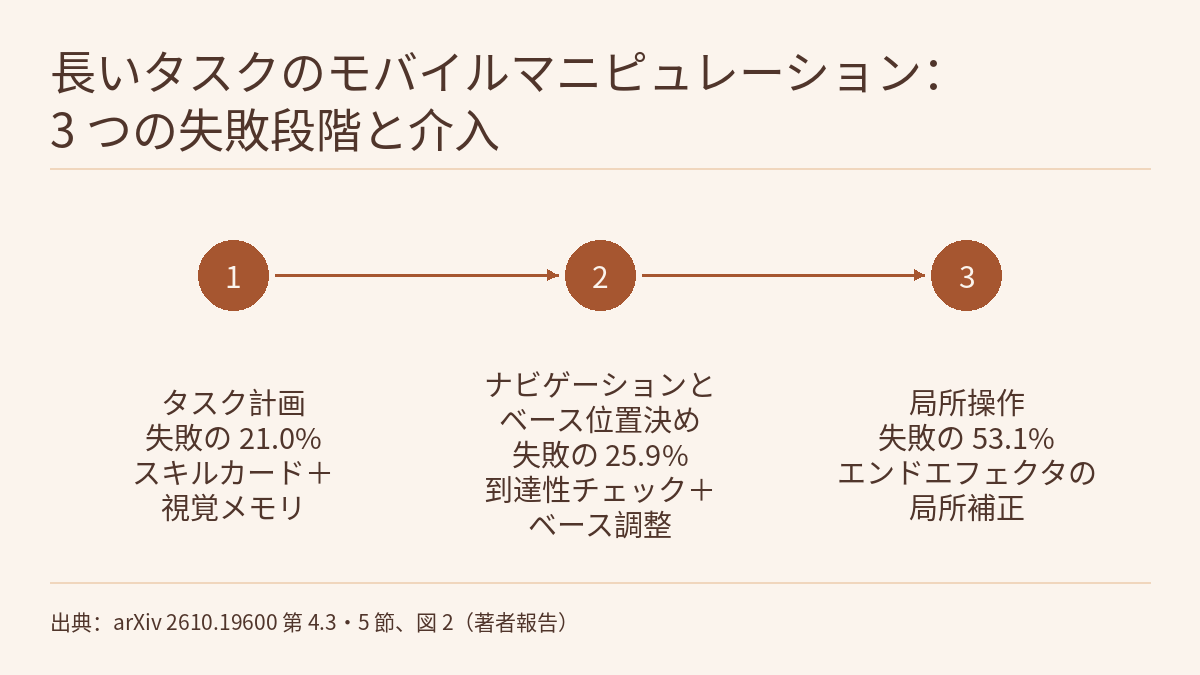
論文の図 2 によると、81 件の失敗エピソードの主な原因は、タスク計画 21.0%、ナビゲーションとベースの位置決め 25.9%、局所的な操作 53.1% に割り当てられています。エピソード数に直すと 17、21、43 件で、合計 81 件です(本サイトによる換算)。著者は 3 種類の失敗を次のように説明しています。
- タスク計画:必要な低レベルのスキルはそろっているのに、プランナーがそれを誤った対象に、あるいは誤った段階で呼び出してしまう。初期の行動で場面が変わると、その後の判断が成り立たなくなることがある。原因は、タスクの進み具合を確実に追跡できていないことにある。
- ナビゲーションとベースの位置決め:ロボットは正しい領域まで来るものの、次の操作が難しい、あるいは不可能なベース姿勢で止まってしまう。著者は、ナビゲーションの成否は目標領域に着いたかどうかだけでなく、到着した姿勢が次の操作を可能にするかどうかでも判断すべきだとしています。
- 局所的な操作:計画とナビゲーションが成功しても、対象の位置推定の誤差、把持のずれ、エンドエフェクタの位置決めの不正確さによって、最後の操作で失敗する。
著者は、これらの失敗が実行の流れのなかで順に現れることを強調しています。計画の誤りは正しい作業領域への到達を妨げ、不適切なベース姿勢は正しいサブタスクの実行を妨げ、小さな幾何学的誤差は最後の操作を台なしにしえます。
4 つの介入と、それぞれが対応する失敗段階
サブタスク VLA は固定し、すべてのエージェント型手法で上位エージェントに Kimi K3 を使います。4 つの介入は次のとおりです。
| 失敗段階 | 介入 | 方法 | 論文が明記している範囲 |
|---|---|---|---|
| タスク計画 | スキルライブラリ(デモ動画から構築) | Gemini 3.5 Flash がタスクの指示を対応するベンチマークの学習データの注釈と照合してデモを 1 本検索し、タスクの目標、サブタスクの順序、代表的なキーフレーム、完了条件をまとめた「スキルカード」にします。プランナーは各ステップで、スキルカードと現在の実行文脈(現在の観測と行動履歴)の両方をもとに判断します | タスク単位の指針を与えつつ、プランナーは現在の場面に合わせて行動を調整できる |
| タスク計画 | 適応型視覚メモリ | 現在のエピソードの観測を保存し、プランナーが問い合わせたときに、Qwen3.8-27B が問い合わせに対して保存済みの観測を順位付けし、最も関連する 16 フレームと短い軌道の要約を返します。たとえば「かごが最後に見えたのはどこか」という問い合わせです | 使えるのは過去の観測だけで、未来のフレームやシミュレータの状態にはアクセスできない |
| ナビゲーションとベースの位置決め | 到達性チェックとベース調整 | ナビゲーションから操作へ移る前に check_stance を呼び出します。対象の名前をテキストクエリとして Grounding DINO で検出し、SAM でマスクを精緻化し、マスク内の有効な深度画素を校正済みのカメラパラメータでロボット座標系に逆投影します。対象までの距離に応じて、立ち位置を reachable、marginal、out of reach に分類します。marginal なら approach_xy が向きを保ったままベースを小さく補正し、out of reach なら goto_stance が操作可能範囲内に新しい立ち位置を選び、現在の深度観測から作った 2 次元の占有格子上で A* により経路を計画します。障害物は安全余裕として 0.1 m 膨張させ、PD 制御器で経由点をたどります | 距離のしきい値は成功した学習軌道から推定し、評価前に固定。チェックは対象までの距離だけを見ており、関節の可動範囲、逆運動学、全身の衝突は検証しない |
| 局所的な操作 | エンドエフェクタの調整 | 把持や配置の各サブタスクで、同じ Grounding DINO と SAM の処理で対象のマスクを得て、有効な深度画素を 3 次元に逆投影します。点群の中央値を対象位置とし、深度の外れ値や欠損の影響を抑えます。点群から局所的な表面の法線を推定してエンドエフェクタの向きを決め、その方向に沿ってオフセット姿勢へ向けた範囲付きの補正を行います | 1 回の呼び出しでの並進量は 0.3 m まで。変えるのは局所的な姿勢だけで、サブタスク VLA は変えない |
1 つずつ加える:失敗が次の段階へ移る様子
開発段階では、すべての構成を同じエピソードのシードとシミュレータの初期状態で試すため、要素を 1 つ加えるたびに、直前の構成とエピソード単位で対にして比べられます。論文の図 4 の順に、スキルライブラリ、適応型視覚メモリ、ベース調整、エンドエフェクタの調整を加えていきます。本文の数値は、ベースライン 19.0%、ベース調整を加える直前が 29.0%、加えた後が 40.0%、すべて加えると 47.0% です。つまり計画関連の 2 つで合わせて 10 ポイント、ベース調整で 11 ポイント、エンドエフェクタの調整で 7 ポイント増えたことになります(本サイトによる計算。スキルライブラリだけを加えた時点の数値は本文にありません)。著者は、この順序のなかでベース調整の伸びが最も大きいと指摘しています。
論文の図 5 は、同じ 100 件の対応エピソードについて失敗の種類ごとの件数を数えたものです。著者の説明では、最初に加えた計画向けの介入は主に対象の選択とタスクの進行に関する失敗を減らし、ベース調整はナビゲーションとベースの位置決めの失敗を大きく減らしました。計画とナビゲーションのボトルネックが緩むと、より多くのエピソードが実行の後半まで進み、残る失敗の中心は操作になります。著者はこれを「移動する失敗の最前線」と呼んでいます。ある段階を改善すると、パイプラインの次のボトルネックが表に出るということです。細かい分類では、介入が直接狙った失敗が大きく減りました。
- 配置先や容器の割り当ての誤り:9 → 0
- 効果のない接近、または不適切なベース位置:11 → 1
- 把持のずれ、または空振り:10 → 3
残った失敗は、物体を誤った場所に置く、運搬中に落とす、衝突で場面を乱す、といったものに集中しています。これらは実行の後半で起き、現在の幾何学的な補正では十分に解決できていません。
1 つ注意したい点があります。ベースラインでは局所的な操作が失敗の 53.1% と最も大きな割合を占めていたのに、1 ステップあたりの伸びが最も大きかったのはベース調整でした。本サイトの読み方はこうです。失敗エピソードは「最初の未回復の誤り」で 1 回だけ数えるので、この割合が示すのは失敗が最初に起きる場所であり、どの段階を直せば最も効果があるかを直接予測するものではありません。前の段階を直すと、後の段階まで進んでからまた失敗するエピソードも出てきます。論文の「失敗の最前線」の説明はこの読み方と矛盾しませんが、本文には各ステップで改善したエピソードと悪化したエピソードの対応した件数は示されていません。
ホールドアウトのシード、BEHAVIOR-1K、実機
システムの設計、プロンプト、ツールのパラメータを固定した後、著者はタスクごとに 5 つのホールドアウトのシードで別途評価しました。タスクの定義は同じで、場面のレイアウトと物体の初期状態が異なります。表 1 のすべての手法は同じエピソードのシードを使います。エージェント型手法ではさらにプランナーの予算と再試行の予算をそろえ、Pigey と著者が改変した Harness VLA は提案手法と同じサブタスク VLA のチェックポイントを使います。end-to-end のベースラインには、RoboCasa365 の公式リポジトリからリンクされた公開済みのチェックポイントと実装を使っています。
| 種類 | 手法 | 開発用(%) | ホールドアウト(%) |
|---|---|---|---|
| VLA | π0 | 2.0 | 2.0 |
| VLA | π0.5 | 3.0 | 4.0 |
| VLA | GR00T N1.6 | 7.0 | 8.0 |
| VLA | GR00T N1.5 | 8.0 | 9.0 |
| VLA | RLDX-1 | 15.0 | 14.0 |
| VLA | Xiaomi Robotics 1 | 44.0 | 45.0 |
| エージェント型 | CaP-X(Kimi K3) | 10.0 | 11.0 |
| エージェント型 | Pigey(Kimi K3) | 13.0 | 12.0 |
| エージェント型 | Harness VLA(Kimi K3) | 19.0 | 18.0 |
| エージェント型 | 提案手法(Kimi K3) | 47.0 | 49.0 |
著者は、ホールドアウトでの改善が対応のある分析で統計的に有意であると報告し(p < 0.001、付録 E。参考文献一覧から、付録 E が McNemar 検定とブートストラップの文献を引用していることがわかります)、改善が開発に使ったエピソードに限られないと結論づけています。Xiaomi Robotics 1 については「同等の性能」(comparable)と表現しています。数値は 47.0 対 44.0、49.0 対 45.0 で、本サイトが読んだ本文には両者のあいだの有意性検定はありません。
転移の実験は 2 つです。BEHAVIOR-1K の 5 タスクでは、低レベル方策を BEHAVIOR-1K の学習データで学習し直し、介入の設計はそのままにして、成功率は対応する Harness VLA ベースラインの 14.0% から 37.0% に上がりました。双腕のモバイルマニピュレータを使った実機の 2 タスクでは、完全なシステムが 20 回中 13 回、エージェント型ベースラインが 5 回成功しました。タスクの定義と詳しい結果は付録 I と J にあり、本サイトが読んだ本文には含まれていません。
アブレーション:どの設計上の選択が効いているか
各アブレーションでは設計を 1 か所だけ変え、ほかは完全なシステムのままにして、すべて同じ 100 件の対応エピソードで評価しています(%)。
| 構成要素 | 変種 | 成功率 |
|---|---|---|
| 基準 | 完全なシステム | 47.0 |
| スキルライブラリ | テキストのみのスキルカード(VLA の学習データ) | 43.0 |
| スキルライブラリ | テキストのスキルカード+キーフレーム(HIW-500) | 40.0 |
| スキルライブラリ | テキストのスキルカード+キーフレーム(VLA の学習データ) | 47.0 |
| 視覚メモリ | 毎ターン一様に抽出した履歴 8 / 16 / 32 フレーム | 37.0 / 40.0 / 35.0 |
| 視覚メモリ | プランナーが必要時に問い合わせ 8 / 16 / 32 フレーム | 42.0 / 47.0 / 45.0 |
| ベース調整 | 到達性チェック check_stance なし | 36.0 |
| ベース調整 | 局所的なベース補正 approach_xy なし | 42.0 |
| ベース調整 | 立ち位置の再計画 goto_stance なし | 39.0 |
| エンドエフェクタの調整 | 目標位置をエージェント型プランナーが指定 | 43.0 |
| エンドエフェクタの調整 | 目標位置を幾何スキルが推定 | 47.0 |
著者の解釈は次のとおりです。HIW-500 は人型ロボットを遠隔操作して集めた実世界の家庭内デモで、これを RoboCasa365 の学習用分割にある同じドメインのデモに置き換えると、成功率は 40.0% から 47.0% に上がります。同じドメインのデモからキーフレームを除いてテキストだけにすると 43.0% に下がることから、ドメインの一致と視覚的な文脈の両方が効いていると考えられます。必要時の問い合わせは、どのフレーム数でも毎ターン一様な履歴を与えるより高く、フレーム数を増やしても一貫して良くなるわけではありません。著者は、視覚メモリの価値は履歴の量よりも、タスクに関係する証拠を取り出すことにあるとみています。到達性チェックを外したときの低下が最も大きく、立ち位置の再計画を外す影響は局所補正を外すより大きくなりました。エンドエフェクタの組の差は 4 ポイントで、著者自身も差は小さい(modest)としています。
この表を読むときは、ここでの 1 ポイントが 100 エピソード中の 1 件にあたり、4 ポイントは差し引き 4 件の差だという点に注意してください。各アブレーションの対応のある統計は付録 K.1 にあり、本サイトが読んだ本文には含まれていません。そのため、これらの差のうち何件が改善し何件が悪化したのか、どの差が統計的に信頼できるのかはわかりません。
本サイトの既存ページとの関係
フィジカルAIラボ 1.8:評価では、「失敗」という 1 つのラベルが異なる失敗のしかたを覆い隠すこと、差し引きの増加数では改善と悪化が打ち消し合うことを扱いました。この論文は、失敗ラベルのルールを明文化しています。3 回の再計画という回復の猶予、最初の未回復の誤りだけを数えること、モデルが候補ラベルを出し人が確認すること、そしてレビュアー間の一致度の報告です。開発段階の評価も 1.8 で扱った対応のある設計になっており、すべての構成を同じシードと初期状態で実行しています。
フィジカルAIラボ 1.1:座標系と運動学では、作業空間の円環でアームが「届くかどうか」を判定し、位置だけを計算して関節の可動範囲は考慮しないと断っていました。check_stance も対象までの距離で立ち位置を 3 段階に分類するもので、論文は関節の可動範囲、逆運動学、全身の衝突を検証しないと明記しています。ここでの reachable は距離による分類であり、逆運動学の解が必ずあることを意味しません。
フロンティア・レーダー|RoboAwareも固定した実行器の外側にエージェントの層をつくっています。考え方は異なり、RoboAware はシミュレーション内で同じ状態から分岐させた反事実の結果でコーディネーターを学習するのに対し、本論文は人が確認した失敗の原因割り当てをもとに介入を手で設計しています。2 本の論文はベンチマーク、タスク、プロトコルが異なるため、成功率を互いに比べることはできません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトではどの結果も再現していません。著者は再現性に関する記述で、コード、プロンプト、設定ファイル、評価エピソードの一覧を公開予定としています。本サイトはそれらがすでに公開されているかを確認しておらず、本記事ではコードのリポジトリにリンクしていません。
- 失敗の候補ラベルは Codex が出し、人が確認しています。一致度は無作為に抽出した 30 件の失敗エピソードでしか報告されていません(26 件で完全一致、κ = 0.86)。論文は、文献収集、原稿の一部、実験コードの一部にも生成 AI ツールを使ったと記しています。
- 開発用エピソードは、システムの設計と、19.0% → 47.0% の段階的な結果の報告の両方に使われています。設計の過程から独立しているのは、ホールドアウトのシードでの 18.0% → 49.0% です。どちらも RoboCasa365 のモバイルマニピュレーション 20 タスク、各タスク 5 エピソードだけが対象です。
- BEHAVIOR-1K は 5 タスクのみ、実機は 2 タスクで計 20 回の試行のみです。タスクの定義、タスクごとの試行の配分、実験条件は付録 I と J にあり、本サイトが読んだ本文には含まれていません。シミュレーションの結果はハードウェアの安全性検証ではありません。
check_stanceは対象までの距離だけを見ており、関節の可動範囲、逆運動学、全身の衝突は検証しません。立ち位置の再計画での障害物の 0.1 m の膨張は論文が設定した余裕であり、安全を保証するものではありません。著者自身の分析でも、運搬中の落下や衝突による場面の乱れといった後半の失敗は、現在の幾何学的な補正では十分に解決されていません。- システムは複数の外部モデルに依存しています。上位エージェントに Kimi K3、スキルカードに Gemini 3.5 Flash、視覚メモリの順位付けに Qwen3.8-27B、対象の分割に Grounding DINO と SAM を使いますが、本サイトが読んだ本文にはこれらの呼び出しのレイテンシやコストは示されていません。アブレーションとホールドアウト評価の対応のある統計は付録 E と K.1 にあり、本サイトが読んだ本文には含まれていません。
リンク
- Cracking Mobile Manipulation: From Failure Diagnosis to Agentic Robot System(arXiv 2610.19600)
- 論文の HTML 全文
- フィジカルAIラボ 1.8:評価――「差し引き +2」を対応表に分解し、失敗ラベルと乱数シードを計算で確かめる
- フィジカルAIラボ 1.1:座標系と運動学――2 リンクのアームがコップに届く計算を手で追う
- フロンティア・レーダー|RoboAware:同じ状態から分岐させた反事実の結果をもとに、各スキル段階をモジュール合成と end-to-end 方策のどちらに任せるかを学ぶ
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)