本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
上一集搭好了场景,机器人还是不会抓,它到底跟谁学?这一集,我们用真人远程操控的示范数据。训练出一个会抓取的策略。全程用 LeRobot 完成,不碰真机也能开始。
从示范到策略
先把目标说清。给机械臂两样东西:看到的画面,和此刻的关节角度。具体点说:状态有六个位置值,五个臂关节,加一个夹子的开合。动作给出它们接下来要到的位置。它要输出的,是下一步怎么动。最省事的办法不是写规则。是给它看人怎么做。这就是模仿学习:把人的示范当老师。让策略照着学。为什么不写规则?抓一个杯子,位置、角度、光线千变万化。规则根本写不完。示范怎么来?人握着另一只手臂遥控。机器人同步动,画面和动作一起被录下来。录的时候,画面和动作严丝合缝对齐。差半拍,策略就学歪了。在 LeRobot 里,各种机器人的数据都是一种格式。所以别人的数据,你也能直接拿来训练。我们用 LeRobot 社区公开的一个数据集。它录的是 SO 系列机械臂的抓取和放置示范。里面有五十段真机示范,两路相机。一路从上方看全局,一路从侧面看细节。每段都是同步的画面加动作。数据质量很关键。示范越干净、越多样,策略学得越稳。乱糟糟的示范,只会教坏它。
ACT:一次出一小段
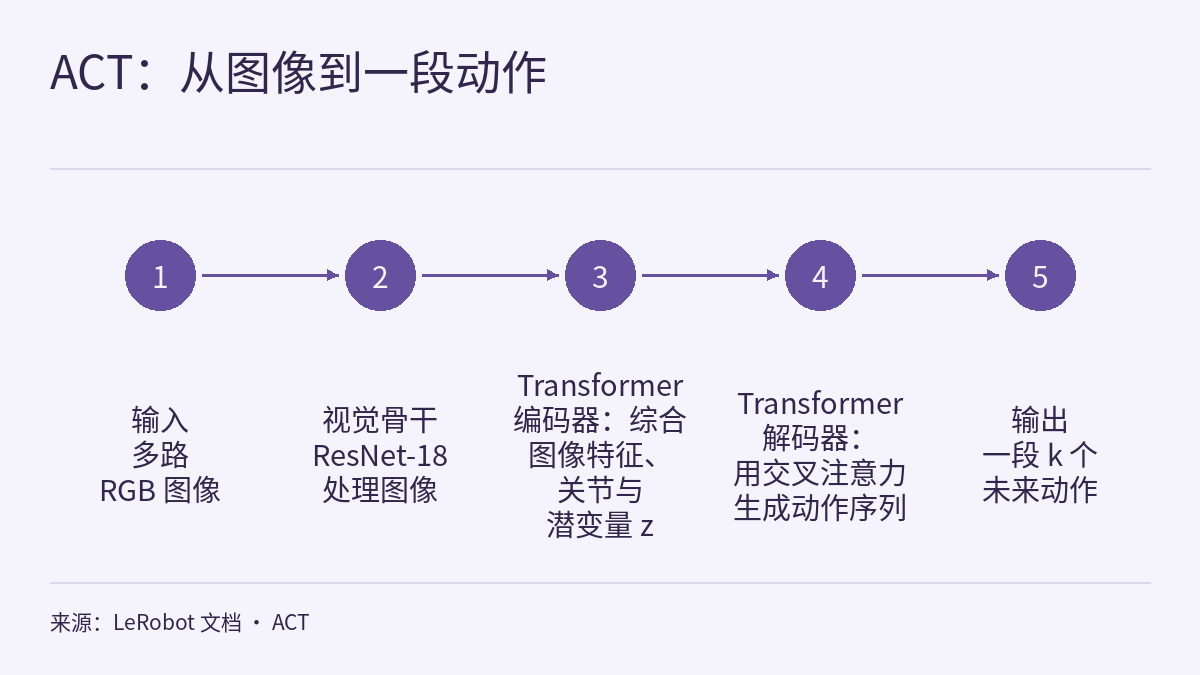
训练用的模型叫 ACT,也就是动作分块变换器。它是 LeRobot 推荐的入门策略。关键在名字里:动作分块。它不是一步一步预测。而是一次出未来一小段动作。一小段有多长,可以调。太短,就退回逐步预测。太长,又跟不上变化。为什么要分块?一步一步预测,小误差会越滚越大。动作就容易发抖。里面有一个视觉网络看图。一个变换器把画面和关节角揉在一起,再吐出动作。视觉网络认画面,变换器管时序。两个一配合,动作就顺下来了。别看它做的事复杂,个头并不大。文档说,它只有大约八千万个参数。小归小,本事不小。文档说,往往只要五十条示范,就能有较高的成功率。但它有个短板。它只学会了这一个抓取任务。你跟它说话,它也听不懂。原来不写规则也行!五十段左右示范,往往就有较高的成功率。
动手训练一次
打开本集 Notebook。第一步,装好 LeRobot,确认显卡能用。数据不用手动下载。加载器会从 Hub 获取数据,放进本地缓存。我们先检查样本,再开始训练。第二步,把数据集加载进来。看看画面多大、动作有几维。第三步,一行命令开始训练。告诉它:用 ACT 策略,数据在哪,算在显卡上。用什么来算?设备这一项选显卡。没显卡就退到 cpu,但会慢很多。开始训练之后,它反复做一件事。从数据里随机取一批,算算差多少,再微调参数。批量大小先设小,比如八。显存还够,再往上加。别一上来就撑爆显存。第一次先跑个小配置,验证流程能走通。确认没问题,再放大。小配置几分钟就跑完。看没报错、损失在动,就放心放大。正式训练要多久?文档说,单块 GPU 上,训练十万步,大概要几个小时。训练时要盯住损失。它稳稳往下走,就说明策略在学东西。日志会一直打印损失和速度。你也能开一个面板,实时看曲线走势。训练能中断,再接着来。存下的检查点,随时能加载回来继续。训练完,你会拿到一个检查点。那就是学好的策略,随时能载入。想分享给别人?再加一个参数,就能把策略推到 Hub 上。
评测与边界
这里要说清一件事。这份数据是真实机器人录的,没有配套仿真环境。在真实机器人上评测,又贵又慢。所以很多人先在仿真中练,练好了再上真的机器人。所以要真正评测,得把策略放回真机上跑。看它到底抓不抓得起来。在真机上,它连着相机和电机。一次一次地抓给你看,你才知道行不行。真实机器人上还有一堆麻烦:标定、延迟、磨损。仿真里可以先绕开,上了真机,还得一一面对。评测别只跑一次。多跑几十次,取平均。跑一次成功,可能只是运气好。没有真机也行:换一个带仿真的任务。用评测命令在标准题库上打分。还有:一个成功率,别急着信。要问它在什么物体、什么光线、试了多少次测出来的。说到底,泛化仍是难题。换个杯子、换个光,成功率还可能往下掉。所以别只报一个数。把测试条件写清楚。别人照着做,才复现得了。回顾一下三个要点。一,模仿学习,看示范,不写规则。二,ACT 一次出一小段动作,模型小、训练快。三,真机数据要在真机上评测,泛化还是难题。所以机器人不是被编程的,是被示范教会的!那要让它听懂一句话再动手,又该怎么训?下一集见!
证据与出处
约 8000 万 · ACT 策略的参数量,轻量、易上手(LeRobot 官方文档) [O] · Hugging Face · LeRobot 文档:ACT
50 条 · 示范往往就能让 ACT 达到较高成功率(LeRobot 官方文档的概括说法,非本片实测) [O] · Hugging Face · LeRobot 文档:ACT
10 万步 · 训练在单块 GPU 上约需几个小时(LeRobot 官方文档) [O] · Hugging Face · LeRobot 文档:ACT
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
第 2.2 集的视频用 LeRobot 走完一遍“把示范变成策略”:输入是看到的画面和此刻的关节角度,输出是接下来要到的位置;训练用的模型是 ACT(Action Chunking with Transformers,动作分块变换器),一次预测未来一小段动作;数据是 LeRobot 社区公开的数据集 svla_so101_pickplace,录的是 SO 系列机械臂的 50 段真机抓放示范;训练是一行命令,评测则要回到真机。片中的数字卡来自两份公开材料:数据集的 meta/info.json,以及 LeRobot 文档的 ACT 页面(约 8000 万参数、往往 50 条示范就有较高成功率、单块 GPU 上 10 万步约几个小时)。本篇是这一集的图文课与练习,不重复文字稿,而是把这两份材料并排读:元数据里的每个字段对应 ACT 的哪个输入或输出,文档里那条训练命令的每个参数管什么、没说什么,评测示例和训练数据在机型与相机上哪里对不上。贯穿全文的规则:一条命令、一个数字,只对写出它的那份数据和那个版本的文档成立,运行前要逐项对上。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 2.1:用 MuJoCo 搭抓取场景,把 XML 里没写的质量、单位、步长和碰撞规则算出来结尾问:场景有了,机器人怎么从数据里学会自己动作?本课接着回答。这份数据集的段数、帧数和总时长,物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间已经从同一份元数据算过;ACT 论文里“约 10 分钟示范、80–90% 成功率”的实验条件,物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件已经讲过;一个成功率要写清条件、配对和次数,物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账已经练过。本课不再重复,只讲视频新用到的 LeRobot 文档页,以及它和元数据之间要核对的地方。
公开小测的 5 道题附完整解析;登录后可完成三项练习:把元数据字段对到 ACT 的输入与输出,算出几种动作块长度覆盖多长时间,再为一份虚构数据集写训练命令;用一组虚构计时给训练预算记账,分清步数、批量与样本数;在运行前审一份虚构的真机评测方案,再改写它的报告。每项都附分步解法、常见错误与 20 分评分标准。
一、两份材料,各自说了什么
数据集元数据。meta/info.json 是一个 JSON 文件。下表列出它记录的字段与值,这是元数据事实的整理,不是原文句子:
| 字段 | 值 | 读法 |
|---|---|---|
| robot_type | so100_follower | 机型字段;数据集名里的 so101 只出现在名字中,所以视频只说“SO 系列机械臂” |
| total_episodes | 50 | 50 段示范 |
| total_frames | 11939 | 全部帧数 |
| total_tasks | 1 | 只有 1 个任务 |
| fps | 30 | 每秒 30 帧;动作和状态也按 30 fps 记录 |
| splits | train: 0:50 | 50 段全部划在 train,元数据里没有留出的测试段 |
| observation.images.up、observation.images.side | video,形状 [480, 640, 3](高、宽、通道),av1 编码 | 两路相机 |
| observation.state | float32,6 维 | shoulder_pan.pos、shoulder_lift.pos、elbow_flex.pos、wrist_flex.pos、wrist_roll.pos、gripper.pos |
| action | float32,6 维 | 名称与 observation.state 相同 |
| timestamp、frame_index、episode_index、index、task_index | 各 1 维 | 时间与编号 |
| chunks_size | 1000 | 见第二节 |
片中两张数字卡对应元数据里的两处原文,各自独立摘录:
"total_episodes": 50
"gripper.pos"
第二处是 action 与 observation.state 名称列表的最后一项:前五项是臂关节,最后一项是夹爪,合起来就是视频说的“六个位置值”。
LeRobot 文档的 ACT 页面。片中三张数字卡对应的三句,各自独立摘录:
Lightweight : Only ~80M parameters, making it efficient and easy to work with
Data Efficient : Often achieves high success rates with just 50 demonstrations
Expect a few hours for 100k training steps on a single GPU
页面还写道:ACT 是一个轻量、高效的模仿学习策略,特别适合精细操作;因为训练快、算力要求低、表现强,它是从 LeRobot 起步时首推的模型;它出自 Zhao 等的论文 Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware。训练技巧里另有两条:ACT 的默认超参数对大多数任务都好用;批量从 8 开始,再按 GPU 显存调整。
读这些材料要注意三点:
- 都是 O 级,但性质不同。元数据是数据集文件自己的记录;文档是 LeRobot 团队对自家模型的介绍。本站没有运行训练或评测,没有核对其中任何一项。
- 两个“50”不是一回事。数据集有 50 段示范;文档说 ACT 往往 50 条示范就能有较高成功率。后者是文档的概括说法,没有指明任务、机型或评测条件,不是对这份数据集的预测;片中数字卡也注明它不是片中实测。ACT 论文里另有一组“10 分钟或 50 条示范”的实验条件,见 1.6。
- “几个小时”没有给出 GPU 型号、批量或任务。它是 10 万步的时长参考,不是训练必须跑满的步数,也不是评测有效的条件。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- meta/info.json 读的是数据集 main 分支的版本,抓取于 2026-10-14;main 分支可能更新。1.5 课在固定提交上读过同一份元数据,段数、帧数、帧率与相机路数和本课一致。元数据属 O 级;本课没有下载或核对数据文件和视频,元数据也不说明录制方式、示范质量,或 robot_type 字段之外的硬件信息。
- LeRobot 文档的 ACT 页面属 O 级厂商文档,读的是不带版本号的地址,抓取于 2026-10-14;页面提供 main、v0.6.1、v0.5.1、v0.4.4 等版本切换。本课没有绑定 LeRobot 版本,命令名和参数可能随版本变化。约 8000 万参数、50 条示范、10 万步约几个小时都是文档的概括说法,不是本站的测量,也不是这份数据集上的基准;“几个小时”没有给出 GPU 型号。
- 页面文本在提取时,${HF_USER} 两侧和 –wandb.enable= 之后带空格,评测命令里 –task 一行的注释与 –duration=60 在同一行;本课去掉了训练命令里的这些空格,其余照页面列出。文档正文写 lerobot-record,示例写 lerobot-rollout,本课没有判断哪个对应当前版本。
- –output_dir、–job_name、–policy.repo_id 的含义,chunks_size 指数据文件分组,action 是训练目标,以及“一个样本对应一帧”“动作按数据集帧率执行”,都是本课的推断或假设,文档和元数据没有这样写。
- k = 30 及练习里的 k、cup_pick_v1、全部计时、检查点间隔、团队 W 的方案与报告、试验次数和成功次数都是练习用的虚构;1.0 s、180、67.0 遍、4.17 h、33.8 min、85%、45% 等只在这些假设下成立,不是任何系统的性能。
- 本站没有运行片中 Notebook、训练或评测命令。评测命令会驱动真实机械臂;硬件安全措施不在本课范围内,纸面计算和仿真结果都不是硬件安全验证。数据集名里有 so101,但 robot_type 是 so100_follower,本站没有一手来源确认录制硬件,所以本文和视频都只说“SO 系列机械臂”。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 2.1:用 MuJoCo 搭抓取场景,把 XML 里没写的质量、单位、步长和碰撞规则算出来
- 物理AI实验室 1.5:数据从哪来,从 SO-101 元数据算出示范时长,再分清三条来路的单位与动作空间
- 物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件
- 物理AI实验室 1.8:评测,把“净增 2”拆成配对表,再给失败标签和随机种子算一笔账
- Hugging Face:lerobot/svla_so101_pickplace 的 meta/info.json
- LeRobot 文档:ACT (Action Chunking with Transformers)