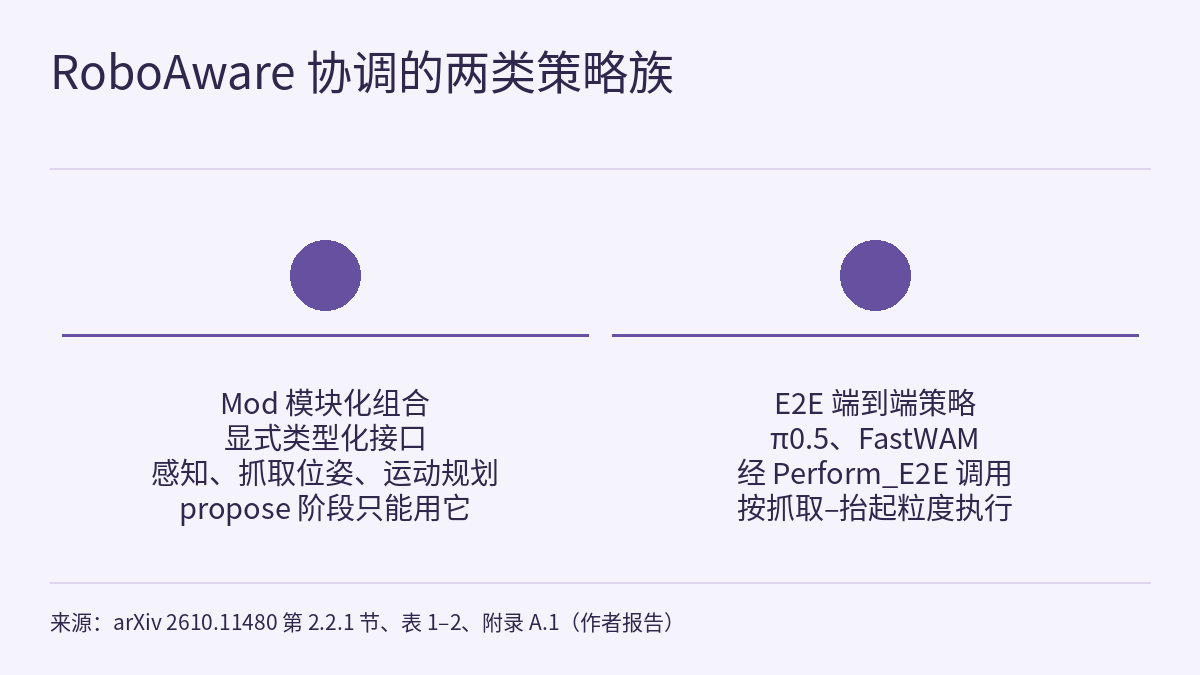
编码智能体既可以写代码调用模块化的感知、抓取与运动规划接口,也可以直接调用冻结的 VLA 或世界动作模型(WAM),但它事先不知道在当前物理状态下哪一种会成功。预印本 RoboAware(arXiv 2610.11480,2026-10-08)不改编码智能体,也不改任何执行器,只训练一个“责任协调器”:每个技能阶段开始时,决定下一段代码交给模块化组合(Mod)还是端到端策略(E2E)。训练数据来自仿真里的“状态锁定反事实分支”:把仿真恢复到同一个状态,两类分支各执行一遍,从而看到没被选中的那条路会怎样。作者报告,在 LIBERO-Pro、RoboSuite、RoboTwin 2.0 三个基准的 100 个任务上,总成功率为 77.0%。以下数字均为作者报告 [R],本站未复现。
只有两个选项的高层动作
论文把问题写成一个有限时域的分层 MDP。高层动作只有一个:选择策略族 c ∈ {Mod, E2E}。选定之后,冻结的编码智能体按所选的族和当前上下文,通过固定的 API 库生成一个完整的局部代码块并执行。决策点是 P⁵ 技能模式中每个阶段的开头。P⁵ 把每个技能拆成五个阶段:perceive(感知)、propose(提出位姿)、pre-manipulate(操作前)、perform(执行)和 post-manipulate(操作后),pick、place、push、pull 这类基本技能和 handover 这类组合技能都用同一种表示。协调器看到的是语言指令、观测(RGB 图像、度量深度、本体感觉)、可观测的执行历史、当前阶段和当前技能。只有协调器的价值模型 Qθ 参与训练;编码智能体、API 接口、后端绑定和底层参数都保持不变。
| API | 覆盖的 P⁵ 阶段 | 策略族 | 后端 |
|---|---|---|---|
Perceive_object_pose | perceive | Mod | InstructSAM |
Propose_eef_pose | propose | Mod | NeuGraspNet+(作者在 NeuGraspNet 上的扩展) |
Plan_to_eef_pose | pre-manipulate、post-manipulate | Mod | cuRoboV2 |
Perform_gripper | perform | Mod | 确定性的夹爪接口 |
Perform_E2E | perceive、pre-manipulate、perform、post-manipulate | E2E | π0.5、FastWAM |
为什么把 VLA 和 WAM 放在“抓取–抬起”这一粒度,而不是交给它们完成整个任务?作者的离线筛选(表 1,成功次数 / 总次数)显示:π0.5 完成整个任务在 LIBERO-Pro、RoboSuite、RoboTwin 2.0 上分别是 10/14、0/4、0/10,只做抓取和抬起时是 13/14、2/4、2/10;FastWAM 完整任务为 4/14、0/4、10/10,抓取–抬起为 11/14、0/4、10/10。propose 阶段只允许 Mod,因为端到端后端在内部决定抓取目标,不经这个接口输出。一次 Perform_E2E 调用可以跨越多个阶段,调用期间所选的族不变,直到满足注册的后置条件、报告失败或用完步数预算。
SCB 与 EAL:在同一状态下补上没选的那条路
作者指出,已有方法要么不看执行结果,要么只用 VLM 判断已执行轨迹的结果。后一种只能看到选中分支的后果,因此带有选择偏差。State-Locked Counterfactual Branching(SCB)只在训练时使用:依靠仿真器的保存–恢复机制和 oracle 结果判定,在每个 P⁵ 决策点从完全相同的物理状态出发,对每个允许的策略族各生成并执行一个代码块。快照里除了部署时可见的上下文,还有 oracle 掩码、物体真值位姿和终局奖励评估器,这些都是特权信息。
Execution-Aware Learning(EAL)用蒙特卡洛树搜索组织这些分支:节点是可恢复的决策状态,边是允许的策略族;已展开的节点按 UCB 选边;新节点上每个族至少评估一次;之后用 API 库把剩余部分跑完,直到任务结束、出现不可恢复的失败或到达时域上限 T,再把回报沿路径回传。每个根节点的预算是 K = 20 次完整的后续模拟。所有评估过的边,包括失败和未被偏好的分支,都进入训练集 D_SCB。
每一步的训练奖励是 r̃ = w_p·r_p + w_m·r_m + w_t·d·r,权重非负且 w_p + w_m + w_t = 1。其中 r_p 由与 oracle 掩码的一致程度给出,r_m 由物体位姿误差在阈值 ε_p 下给出,r 是只在终局给出的二元任务成功,折扣 γ = 1;本站所读正文没有给出权重的取值。采集完成后,作者在这份固定数据集上用 Bellman 目标、Smooth-L1 损失和停止梯度的目标网络训练 Qθ,而不是直接回归搜索得到的回报。Qθ 是一个轻量 VLM 骨干(例如 Qwen3.5-0.8B)加一个 MLP 头,读取以 <VALUE> token 结尾的“上下文–策略族”序列。部署时取 Q 值最大的族,由编码智能体生成代码块;这一步不恢复仿真状态,不用特权信息,也不做在线搜索。
77.0% 是怎样算出来的
评测共 100 个桌面操作任务。只有场景种子 0 用来采集 SCB 分支和训练 Qθ,冻结后在种子 1–10 上测试,共 1,000 个测试回合,每个种子跑一次。依赖记忆的基线关闭了跨回合的全局记忆。π0 和 π0.5 与 RoboTwin 的双臂设置不兼容,涉及它们的结果标为“/”。下表的 LIBERO-Pro 列是本站按论文表 3 的八个分组求的平均,其余为论文原值(%)。下表为节选,省略的行包括 π0、FastWAM、CaP-X、RATS 和 VLS。
| 方法 | LIBERO-Pro 八组均值(本站计算) | RoboSuite | RoboTwin | Overall(论文) |
|---|---|---|---|---|
| π0.5(端到端) | 11.0 | 0.0 | / | 9.8 |
| FasterWAM(端到端) | 12.5 | 0.0 | 85.6 | 18.6 |
| CaP(代码即策略) | 0.0 | 70.0 | 5.6 | 7.6 |
| ASPIRE(代码即策略) | 61.25 | 80.0 | 0.0 | 57.0 |
| Pigey(VLA + harness) | 45.0 | 15.0 | / | 41.7 |
| Harness-VLA(VLA + harness) | 53.75 | 20.0 | / | 50.0 |
| RoboAware | 73.75 | 90.0 | 90.0 | 77.0 |
读这张表要注意三点。第一,表 3 的 Overall 是可用列的简单平均。RoboAware 的 10 列里有 8 列是 LIBERO-Pro 的分组(摘要中的 73.8% 就是这 8 列的平均),而带“/”的行只在 9 列上平均。本站所读正文没有给出各列的任务数,所以 77.0% 不是按 100 个任务或 1,000 个回合加权的成功率(本站核算)。第二,RoboAware 的平均值最高,但不是每个分组都最高:Obj-T、Obj-S 上 ASPIRE 为 95.0、98.0,RoboAware 为 92.0、86.0;Spat-T 上 Pigey 为 80.0,RoboAware 为 68.0;Spat-S、Obj-S 上 Harness-VLA 为 70.0、90.0,RoboAware 为 68.0、86.0。第三,RoboTwin 上单独运行的 FastWAM 和 FasterWAM 已有 81.9 和 85.6,RoboAware 的 90.0 比 FasterWAM 高 4.4 个百分点。本站所读正文没有给出置信区间。
消融:两类策略族、配对结果和逐阶段切换
| 变体 | 含义 | LIBERO-Pro | RoboSuite | RoboTwin 2.0 |
|---|---|---|---|---|
| MO | 只用模块化代码块 | 54.8 | 67.5 | 41.9 |
| EO | 只用端到端代码块 | 49.5 | 60.0 | 45.6 |
| UO | 训练协调器,但只用已执行轨迹,没有配对分支 | 58.5 | 75.0 | 53.8 |
| TF | 不训练协调器,由编码智能体直接在混合 API 库中选择 | 51.0 | 60.0 | 40.0 |
| FH | 固定交接:perceive、pre-manipulate 用模块化 API,之后调用 E2E | 64.5 | 82.5 | 55.6 |
| ES | 回合开始时选一次策略族,全程不变 | 59.3 | 70.0 | 51.9 |
| RoboAware | 每个 P⁵ 阶段重新选择 | 73.8 | 90.0 | 90.0 |
作者的解读是:MO 和 EO 都更低,说明两类策略族需要按状态协调;UO 高于 TF,说明编码智能体本身不具备对执行后果的感知,没有反事实数据时训练协调器也有帮助;完整方法高于 UO,支持同一状态配对执行的必要性。作者把 UO 的差距称为 modest(小幅),但按表 4,三个基准上分别低 15.3、15.0、36.2 个百分点(本站换算)。FH 和 ES 都低于逐阶段选择。另一个值得留意的数字:EO 在 RoboTwin 上为 45.6%,低于单独运行的 FastWAM(81.9%)和 FasterWAM(85.6%),本站所读正文没有解释这一差别。
另两项分析只以图的形式给出。在 RoboSuite 上,搜索预算 K 取 5、10、20、50 时,成功率的增幅随 K 递减,作者取拐点 K = 20,同预算下 UCB 分配优于均匀分配。换用 Claude Code(默认)、Cursor、Codex 三种编码智能体,以及 Aloha-AgileX(默认)、Franka-Panda、ARX-X5、UR5-WSG 四种机器人本体,在 RoboTwin 2.0 的四个任务上平均成功率差距较小。作者把编码智能体之间差距小归因于 P⁵ 每次只让它生成一个代码块。这两项的具体数值不在本站所读的正文里。
和站内已有内容的关系
物理AI实验室 1.7:强化学习讲过回报、价值和奖励塑形。RoboAware 的 Qθ(x, c) 估计的是“下一步选择族 c 后剩余的技能级和任务级回报”,奖励里的感知分和操作分就是一种塑形,并且依赖仿真里的 oracle 掩码和真值位姿。1.7 提醒过,塑形项写歪了会被钻空子;本站所读正文没有给出权重,也没有单独分析塑形项对协调器选择的影响。
物理AI实验室 1.8:评测讲过配对比较:同一个起始状态在不同条件下各跑一遍,才能一对一比较。SCB 把同样的思路用在训练数据上:在每个决策点从同一个恢复状态出发比较 Mod 和 E2E,避免两个分支的状态本来就不同。不过论文对最终方法的评测仍是每个种子跑一次,表 3 只给成功率,不给与基线逐对的变好、变坏数。
前沿雷达|RESETTLE的实验里也出现了 Harness VLA:它把 RESETTLE 加在 Harness VLA 的底层动作接口上,Harness VLA 是基础系统,而不是对照基线。RESETTLE 在动作执行接口上检测分歧,并在执行中纠正一步;RoboAware 则在生成代码之前、在阶段边界上决定由谁执行。两篇论文的任务划分和协议不同,数字不能互相比较。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R]。表 3 的基线结果按作者的协议运行,依赖记忆的基线关闭了跨回合记忆;作者自己也写明,单轮评测限制了 CaP-X、RATS、ASPIRE 这类基于记忆的方法从累积经验中获益。本站没有复现任何结果。
- SCB 依赖仿真器的保存–恢复、oracle 掩码、物体真值位姿和终局评估器。本站所读正文中训练和评测都在仿真里进行,没有真机实验,也没有说明怎样在真机上获得同一状态的配对结果。仿真结果不是硬件安全验证。
- 按第 3.1 节,SCB 分支在场景种子 0 上采集,测试用种子 1–10;本站所读正文没有报告在训练中完全没出现过的任务上的结果。每个种子只跑一次,正文没有给出置信区间;Overall 是列平均,不是按任务或回合加权。
- 作者写明的局限:目前只整合了模块化组合和端到端两类策略族,扩展到强化学习策略、检索式策略等可能需要新的反事实数据和再训练;责任只在 P⁵ 边界上切换,一次原子性的 E2E 调用可能跨越多个阶段,在返回后置条件、失败信号或超时之前,短暂的失败只能交给它内部的控制器。
- 预算 K 与编码智能体、机器人本体的敏感性分析只有图,本站所读正文没有给出数值。本站所读的论文 HTML 截至附录 A.2 的算法部分,不含附录 B 的筛选细节和附录 C 的任务细节。