本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
机器人能不能像小孩学骑车那样,自己试着试着就会了?这一集讲强化学习。不给示范,只给奖励,让机器人自己在试错里摸出动作。
奖励与试错
上一集的模仿学习,是看着人的示范照着做。这一集不一样,没有示范。强化学习里,机器人自己动,环境给它打个分,这个分叫奖励。动对了加分,动错了扣分。它要学的是一套策略。看到眼前的情况,就知道下一步该怎么动。机器人要的不是一步的分。是一整局加起来的总分,我们叫它回报。难点在这儿:一局做成了,到底是哪几步的功劳?机器人得慢慢把功劳分清楚。拿“够杯子”来举例。离杯子越近分越高,稳稳拿起来给大分,碰倒水瓶就扣分。一开始,策略是瞎动的。大部分时候够不着。偶尔碰巧离杯子近了,就得了点分。它把得分高的动作,往上调一调。练一阵,够到杯子的次数就多了起来。再练下去,动作也顺了。伸手、绕开水瓶、拿起杯子,一气呵成。原来它不是被教会的。是自己一次次撞对,再把撞对的记下来!
在仿真里试很多遍
试错的麻烦是:要试很多很多次。真机器人试不起。太慢,还容易摔坏。所以,试错大多搬进仿真。摔坏了重来一次,不花钱,也不伤人。二零二一年,一篇论文做了个实验。让几千个机器狗分身,在一块显卡上同时练。每个分身各自尝试。摔倒的、成功的,经验汇到一起,交给同一套策略。论文称,平地上不到四分钟,机器狗就学会走路。换成不平的地形,也只要二十分钟。论文还说,在仿真中练好的策略,搬到了真的机器狗上。验证过,确实能用。试错还有个讲究。多去试没试过的动作,别老用眼下最稳的那个。把每一局的回报画成一条曲线。往上爬,就是在变强。但它会抖,也会卡在半路。
奖励很难写对
强化学习有个好处。它不照抄示范,可能试出比人更好的办法。可奖励很难写。只在成功那一下给分,太少见,学得很慢。所以常常给“离得近”也加点分,一路把它往对的方向引。这叫奖励塑形。塑形是把双刃剑。奖励只要写歪一点,机器人就会钻空子。比如,奖励只看“杯子动了”。机器人可能一巴掌把杯子扫飞,照样拿高分。所以奖励得反复试、反复改。还得有人盯着回放,看它是不是真做成了。和模仿学习比一下。模仿学得快,但很难超过老师。强化可能更强,代价是慢、还要小心奖励。你在页面里拖动进度条,看奖励曲线怎么爬。再换一个设计错的奖励,看它怎么钻空子。还没解决的有三样。奖励难写对;试错要很多次;仿真和真实之间还有差距。回顾一下,三个要点。一,强化学习靠奖励和试错,不靠示范。二,试错要很多次,所以在仿真里几千个分身一起练。三,奖励难写对,写歪了就会被钻空子。所以它的本事不是别人给的。是自己在奖励里,一点点试出来的!可它到底有多行?一个成功率,藏着多少没说的?下一集见!
证据与出处
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
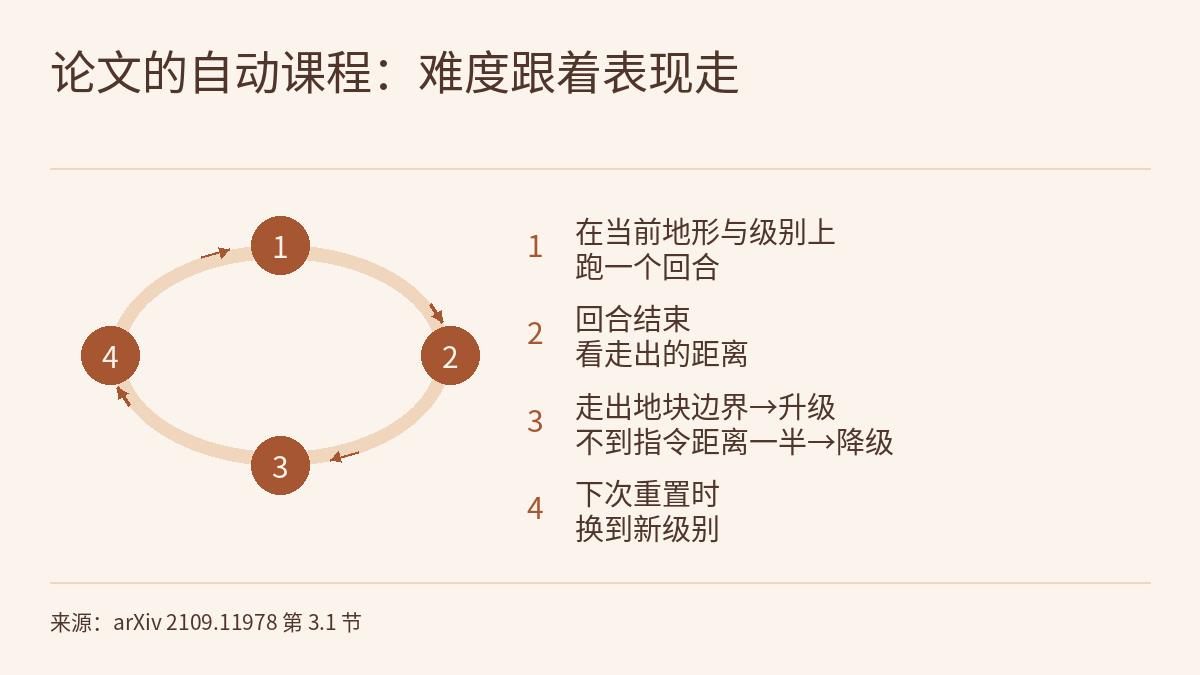
第 1.7 集的视频讲强化学习:不给示范,只给奖励,机器人在试错里自己摸出一套策略(看到眼前的情况,就知道下一步怎么动);它要的不是一步的分,而是一整局加起来的回报;试错要很多次,所以搬进仿真;奖励很难写对,写歪了会被钻空子。片中的真实证据来自一篇论文:Rudin 等的 Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning(arXiv 2109.11978)称,在一块工作站显卡上让数千个仿真机器人并行训练,四足机器人平地不到四分钟、不平地形二十分钟就能训练出行走策略。本篇是这一集的图文课与练习,不重复文字稿,而是做两件视频没有展开的事:先用一只假想的杯子手算一局回报,看“离得近也加分”的塑形怎样让“守在杯子旁边”比“拿起杯子”得分更高;再打开同一篇论文里视频没讲的两节,看它怎样用一张自动的地形课程表让难度跟着策略走,又怎样区分“时间到了”和“摔倒了”这两种回合结束。贯穿全文的规则:一个回报只对它自己的奖励定义成立,一个训练耗时只对它自己的硬件、任务和设置成立。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 1.6:模仿学习,手算误差怎样滚出示范覆盖范围,再把 ACT、扩散策略与数据规模律的数字放回各自条件结尾问:只会模仿,遇到没见过的怎么办?本课接着回答。同一篇论文的“数千个机器人”“不到四分钟”及其实验条件,物理AI实验室 0.4:在虚拟世界练一万遍,给三个仿真数字补上实验条件已经逐条讲过,并按论文的批量公式手算过一次并行设置;物理AI实验室 1.4:仿真器地图,手算步长代价、找出接触分叉点,再给三个提速数字标清基线又把它和另外两个提速数字放在一起核对了基线。本课不再重复这些,只补上与强化学习本身有关的部分:奖励与回报、课程、重置。
公开小测的 5 道题附完整解析;登录后可完成三项练习:用两版虚构奖励给三段回放算回报,找出被钻空子的那一版并给塑形项定上限;按论文的课程规则给一份虚构训练日志判升降级,并解释回报为什么可能在策略变强时下降;审三种处理超时重置的写法,并算出 critic 的训练目标。每项都附分步解法、常见错误与 20 分评分标准。
一、一篇论文,两个数字,和视频没展开的部分
论文作者是 Nikita Rudin、David Hoeller、Philipp Reist 和 Marco Hutter,来自 ETH Zurich 与 NVIDIA,arXiv 提交日为 2021-09-24,属 R 级(作者报告)。片中两个数字对应摘要里的两句,各自独立摘录:
In addition, we present a novel game-inspired curriculum that is well suited for training with thousands of simulated robots in parallel.
The parallel approach allows training policies for flat terrain in under four minutes, and in twenty minutes for uneven terrain.
第一句里的“数千个”和视频说的“几千个分身”是同一件事,但这句话的主语其实是一张课程表,本课第三节会展开。读这两句还要注意三点(0.4 已讲过的硬件与仿真条件不再重复):
- 学会的是什么。论文第 3 节写明任务:四足机器人要穿过不平地面、斜坡、台阶和障碍物,同时跟随给定的机身朝向与线速度指令。“学会走路”指在仿真里训练出这样一个策略。大部分仿真与真机实验用 ANYbotics 的 ANYmal C;仿真中另外训练了 ANYmal B、带机械臂的 ANYmal C 和 Unitree A1。
- 快是和谁比。摘要称这比此前的工作快多个数量级。引言列出几项此前的四足强化学习工作:对高度不平地面鲁棒的盲走策略训练 12 小时;结合学习与最优控制的感知行走 82 小时和 88 小时;一种完全学习的方法 120 小时;并称本文方法在单块 GPU 上不到 20 分钟训练出一个感知策略。这些是作者对别人工作的转述,任务、硬件和感知设置各不相同,不能相除得出一个“快多少倍”。
- 真机那一步。摘要说最后把策略迁移到真机器人上以验证方法;视频据此说“验证过,确实能用”。本课依据的摘录止于第 3.2 节开头,不含真机实验的结果。片中秒表的表盘按一小时画,4 分钟和 20 分钟只是表盘上的读数位置,不是另外的测量。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- Learning to Walk in Minutes(arXiv 2109.11978,2021-09-24)的训练耗时、课程规则、重置处理和图 3 的描述都是作者报告,属 R 级。作者来自 ETH Zurich 与 NVIDIA,所用的 Isaac Gym 是 NVIDIA 的仿真环境。本站没有独立复现其中任何一项。
- 本课依据的是论文摘要和正文到第 3.2 节开头的摘录,不含奖励项与动作的定义、真机实验结果和补充材料;重置处理对总奖励和 critic 损失的影响在补充材料里,本课没有读。
- 引言里的 12、82、88、120 小时是作者对其他工作的转述,各自的任务、硬件与感知设置不同,本课没有核对那些原始文献。
- 第二节的奖励 R0、两局回放、k = 0.1 分/cm 与 30 cm,第三节的 0.3 m/s 和三种距离,第四节的 γ = 0.8 与 4.6,以及第五节的 A7、回放 a–c、V1、V2、4 级台阶、机器人 A–F、仪表盘数字、团队 W、γ = 0.9、9.0、I1–I3 和其中的回合起点均匀错开,都是练习用的虚构;算出的 13、16、10.8、0.476、0.333、0.167、4.68、9.1、40 批、100 个等只在这些假设下成立,不是论文或任何系统的数据。
- “正对一条边走、4 m 出界”是本课由 8 m 地块和中央出发推出的简化。论文摘录没有说明怎样判定“走出边界”,也没有说明升级与降级条件同时成立时怎样处理。
- 给塑形项定上限、按“靠近了多少”给分、回放复核规则和在固定地形上比较,都是教学建议,不是论文的做法或结论。纸面计算和仿真结果都不是硬件安全验证;在真机上做试错需要另外的安全措施,本课不涉及。
- 片中第 30 段是实验页 1.7-rl 的脚本化表演;本文没有核对实验页的实现。