本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
同一段抓取动作,为什么换个仿真器,杯子就被撞飞了?这一集,我给你画一张仿真器地图。四个主流引擎,各自擅长什么。为什么同一个动作,换个引擎结果就不同。
仿真器在算什么
仿真器的工作,说穿了并不神秘。给每个关节多大的力,算出下一刻,物体怎么动。为什么不直接拿真的机器人练?摔一次就是钱,还危险。在仿真里,摔再多次也不心疼。它不是一口气算到底。而是切成很多小步,一步一算。步子越小越准,也越慢。最难算的,是接触那一下。手指碰到杯子,力有多大、往哪滑,全看这一瞬间。不同引擎,算接触用的近似不一样。所以同一个动作喂进去,两条轨迹会慢慢分叉。原来差别不在画面漂不漂亮,在它怎么算那一下接触!
四个引擎
先说 MuJoCo。DeepMind 维护它,开源免费。接触算得准,很多论文拿它当基准。它擅长精细接触,早年一次只跑一个。后来出了显卡版本,能一次跑很多个。再看英伟达的 Isaac。它把仿真整个搬上显卡,很多环境一起跑。快多少?老方案是处理器做仿真,显卡训练网络。技术报告称,全放到一块显卡上,快两到三个数量级。Isaac 还有一条长处:画面能做得很逼真。这对生成训练数据,很有用。第三个是 Newton。英伟达、谷歌、迪士尼宣布,要联合开发这个开源引擎。它建在英伟达的 Warp 上。配套的 MuJoCo-Warp 很关键。据英伟达介绍,人形仿真快七十倍以上。Newton 还想做两件事。让仿真可以求导,方便学习。也让布料、软物,都能一起算。第四个是 Genesis,也是开源项目。它想把多种物理,统一进一个引擎。Genesis 很新。越新的引擎,越要留意一件事。它到底验证得够不够多。慢一点更准,快一点能多练。四个引擎,其实在挑不同的取舍!
快,为了什么
为什么拼命求快?因为强化学习要试错海量次。论文称,几千个并行环境里,四足不到四分钟学会走平地。换成高低不平的地面,也就二十分钟。这个速度,靠的正是几千个环境一起练。但是,快跟准是一对矛盾。更麻烦的是,仿真再准,也不等于真实世界。那怎么缩小这道缝?常用的一招,是把重量、摩擦、光照,都随机抖一抖。让策略见惯各种变化。屏幕上试试看。同一段动作,在四个引擎里并排回放。接触那一下,偏差会被标出来。说句实在的:没有哪个引擎,在所有任务上都最好。选引擎,要看你做什么、要多准、要多快。回顾一下,三个要点。一,仿真器的核心,是算好接触那一下。二,四个引擎各有取舍,显卡并行带来数量级提速。三,快不等于准,仿真不等于现实。所以杯子被撞飞,不怪机器人,是引擎算接触的方式不同!这些要练的动作数据,最早又是从哪来的?下一集见!
证据与出处
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
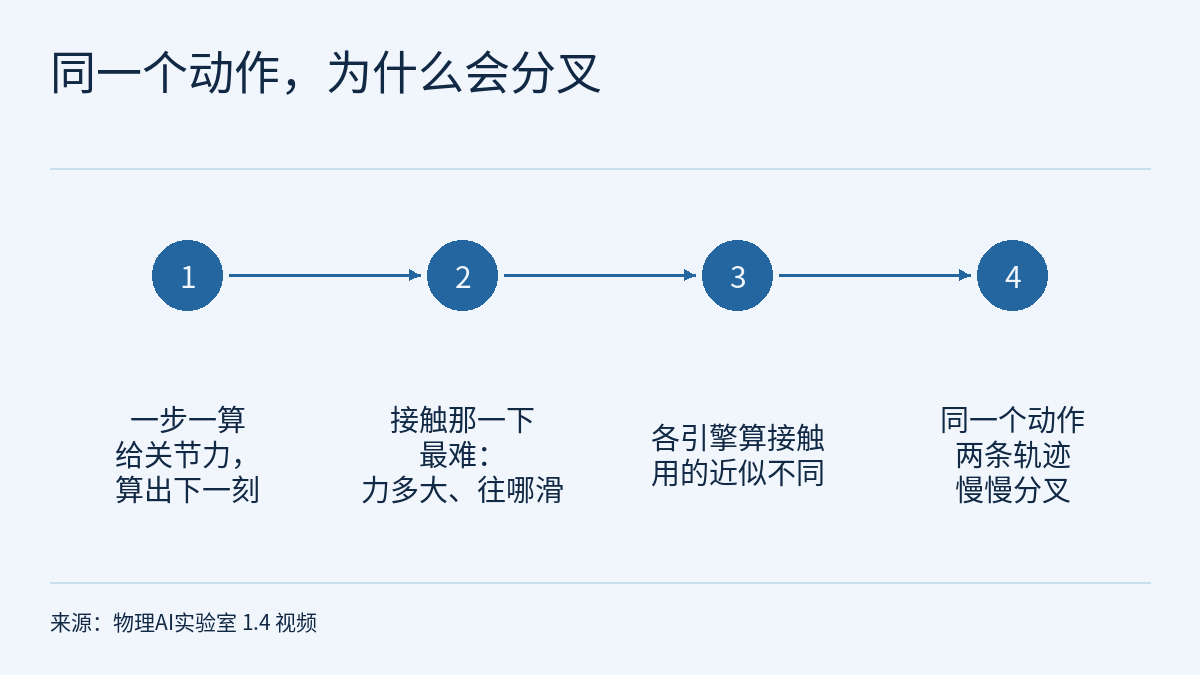
第 1.4 集的视频从“同一段抓取动作,换个仿真器,杯子就被撞飞了”讲起,画了一张仿真器地图:仿真器的核心是一小步一小步地算,最难算的是接触那一下;不同引擎算接触用的近似不同,同一个动作喂进去,两条轨迹会慢慢分叉;MuJoCo、Isaac、Newton、Genesis 各有取舍,没有哪个在所有任务上都最好。片中引了三条证据:Isaac Gym 技术报告的“快 2–3 个数量级”,NVIDIA 博客转述的 MuJoCo-Warp“人形仿真快 70 倍以上”,以及一篇论文的“平地行走不到四分钟”。本篇是这一集的图文课与练习,不重复文字稿,而是先把三个提速数字各自比的是什么摆清楚,再用一段假想的抓取手算步长的代价,从一份假想的两引擎回放记录里找出分叉点,最后把“看任务选引擎”写成一张可以照着核对的清单。贯穿全文的规则:一个提速倍数只对它自己的基线、任务和系统成立,不同来源的倍数不能相乘,也不能互相比大小。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 1.3:传感器,用一只杯子手算像素、深度量程与夹紧力结尾问:这么多传感器、这么多次试错,在真机上练太慢,到哪里练?本课接着回答。Isaac Gym 的 2–3 个数量级和 Learning to Walk in Minutes 的实验条件,物理AI实验室 0.4:在虚拟世界练一万遍,给三个仿真数字补上实验条件已经逐条讲过,本课不再重复那张表和那次批量计算,只在需要时引用;本课新增的是 Newton 博客里的 MuJoCo-Warp 数字,以及“步长”和“接触”这两件仿真器内部的事。
一、三个提速数字,各自比的是什么
片中三条证据的原句如下,分别出自三份材料:
This leads to blazing fast training times for complex robotics tasks on a single GPU with 2-3 orders of magnitude improvements compared to conventional RL training that uses a CPU based simulator and GPU for neural networks.
It enables developers to achieve significant performance gains, with more than a 70x acceleration for humanoid simulations and a 100x speedup for in-hand manipulation tasks.
The parallel approach allows training policies for flat terrain in under four minutes, and in twenty minutes for uneven terrain.
第一句出自 Isaac Gym 技术报告(arXiv 2108.10470,作者署名 NVIDIA),第二句出自 NVIDIA 开发者博客 Announcing Newton(2025-03-18),第三句出自 Learning to Walk in Minutes(arXiv 2109.11978,作者来自 ETH Zurich 和 NVIDIA)。把它们并排放在一张表里:
| 片中说法 | 说的是谁 | 和什么比 | 任务范围 | 等级 |
|---|---|---|---|---|
| 快 2–3 个数量级 | Isaac Gym:物理仿真与神经网络训练都放在单块 GPU 上 | CPU 仿真加 GPU 神经网络的传统 RL 训练 | 报告中的复杂机器人任务 | R(作者报告) |
| 人形仿真快 70 倍以上 | MuJoCo-Warp:博客称由 Google DeepMind 推出、用 Warp 加速的开源机器人仿真器 | 所引文字没有说明基线、硬件或并行规模 | 人形仿真 70 倍以上;手内操作 100 倍,是另一个数 | O(厂商博客) |
| 平地不到四分钟 | 在单块工作站 GPU 上用数千个并行仿真机器人训练四足机器人 ANYmal | 不是倍数,是训练耗时;论文另称比此前工作快多个数量级 | 平地不到四分钟,不平地形二十分钟 | R(作者报告) |
读这张表要注意三点:
- 三个数的单位和基线都不同。第一个是两种训练流程之间的比,第二个是一个仿真器在两类任务上的提速,第三个是一次训练花了多长时间。它们不能相乘成一个“总提速”,也不能拿来说 Newton 比 Isaac 快或慢。
- 70 倍只属于人形仿真。同一句话里,手内操作给的是 100 倍;所引文字没有给其他任务(例如四足行走、布料)的数字,也没有说比的是哪个版本的 MuJoCo、在什么硬件上。视频说“据英伟达介绍”,正是因为这是厂商博客对合作方工具的介绍,不是独立评测。
- “不到四分钟”是仿真里的训练时间。原文是 under four minutes,不是整 4 分钟;任务是平地行走;条件是单块工作站 GPU 上的数千个并行机器人。它不是机器人在真实地面上学会走路的时间。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- Isaac Gym(arXiv 2108.10470,2021-08-24)和 Learning to Walk in Minutes(arXiv 2109.11978,2021-09-24)的数字都是作者报告,属 R 级,两篇都有 NVIDIA 作者。MuJoCo-Warp 的 70 倍和 100 倍出自 NVIDIA 开发者博客(2025-03-18),属 O 级厂商自述,所引文字没有说明基线、硬件和测试设置。本站没有独立复现其中任何一项。
- Newton 的功能描述来自它宣布时的博客,博客当时写明开发仍在进行;本课不跟踪之后的发布进展,也不判断哪些功能已经可用。
- Genesis 的描述只来自视频,本课没有引用它的一手材料。片中对 MuJoCo“接触算得准”、Isaac“画面逼真”的介绍也是课程的概括,本课没有找到对应的量化数据。
- 第二节的 2.0 s、0.2 m/s、10,000 个回合、1,000 个并行环境和“每步计算量相同”,第三节的引擎 A、B 和全部位移数字,都是练习用的假设,不是任何引擎或系统的配置或输出。“只在步边界检查接触”是教学用的简化模型,不描述任何真实引擎的接触算法。
- 第四节右列和三个假想任务的核对项是教学建议,不是选型结论。本课依据的是两篇文献的摘要与正文前几节以及博客正文,不含补充材料;真机迁移的效果没有出现在这些文字里。
- 实验页的四引擎回放是脚本化演示,片中画面标为示意;本文没有核对实验页的实现。
链接
- 物理AI实验室:一套每个数字都能核对的物理 AI 课程(课程大纲)
- 物理AI实验室 1.3:传感器,用一只杯子手算像素、深度量程与夹紧力
- 物理AI实验室 1.2:PID 与控制频率,手算三项输出,再把频率换成周期
- 物理AI实验室 0.4:在虚拟世界练一万遍,给三个仿真数字补上实验条件
- Isaac Gym: High Performance GPU-Based Physics Simulation For Robot Learning(arXiv 2108.10470)
- Learning to Walk in Minutes Using Massively Parallel Deep Reinforcement Learning(arXiv 2109.11978)
- NVIDIA Developer Blog:Announcing Newton, an Open-Source Physics Engine for Robotics Simulation(2025-03-18)