
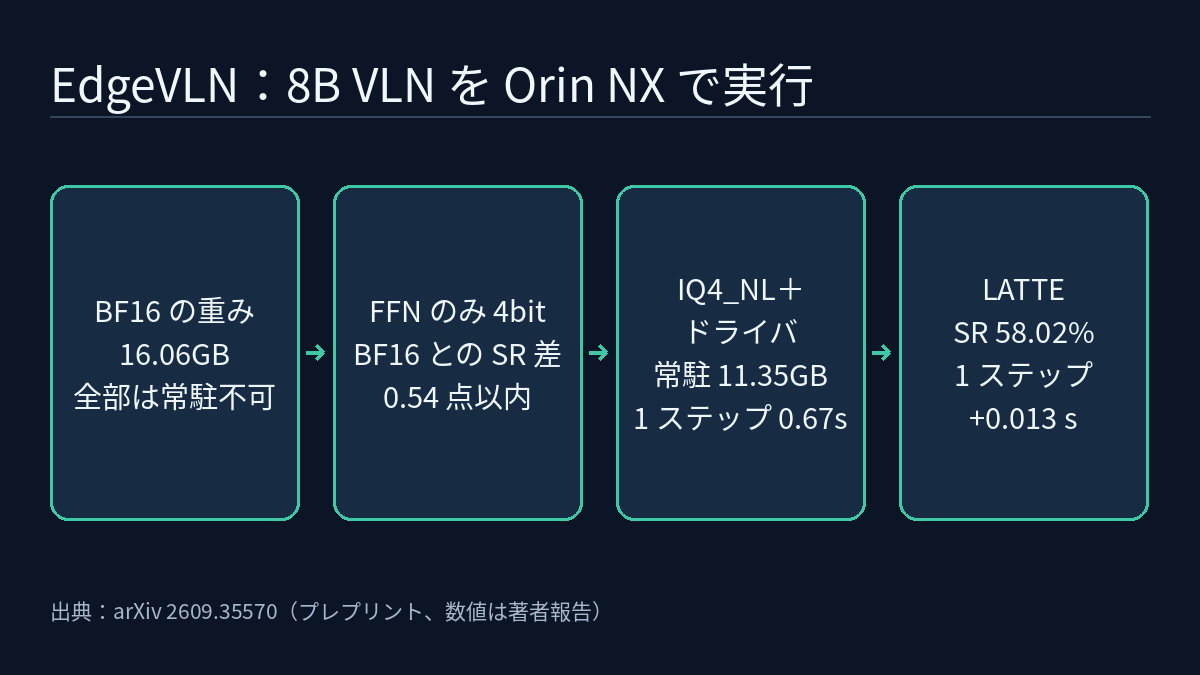
ジョンズ・ホプキンス大学のチームによるプレプリント EdgeVLN(arXiv 2609.35570、2026-09-28、証拠レベル [R])は、8.03B パラメータの視覚言語ナビゲーション(VLN)モデルを NVIDIA Jetson Orin NX 16 GB 上で動かし、レイテンシ、エネルギー、常駐メモリをボード上で測定しています。論文によると、複数の 4 bit 形式で成功率はほぼ同じでも、実行経路(形式の実装とランタイム)によってステップあたりのエネルギーは 36.8 倍違います。著者らはメモリと速度を主に決めるのはビット幅ではなく推論ランタイムだとし、量子化で空いた予算内に 8.2 MB の停止判定ヘッド LATTE を追加しています。
問題:16 GB の統合メモリに 16 GB の重みは載らない
対象は StreamVLN(arXiv 2507.05240)です。SigLIP-SO400M のビジョンタワー、2 層 MLP のプロジェクタ、28 層の Qwen2 言語モデルから成り、合計 8.03B パラメータ、BF16 の重みは 16.06 GB です。Orin NX の 16 GB LPDDR5 は GPU、CPU、OS、カメラパイプライン、KV キャッシュ、計算バッファで共有され、論文によると統合メモリプールは 16.14 GB です。論文は、ビット幅だけで見積もると外れる理由をいくつか挙げています。
- このボードの PyTorch には 4 bit の Tensor Core 経路がないため、4 bit 重みの効果は主にストレージとメモリ転送量の削減です。PyTorch フレームワーク自体も約 3 GB を占めます。
- 名目上の重みサイズではピーク常駐メモリを予測できません。収まるかどうかはランタイムのオーバーヘッド、KV キャッシュ、計算バッファで決まります。
- 著者らが量子化したのは言語モデルのフィードフォワード(FFN)ブロック、つまり 8.03B のうち 5.70B だけで、ビジョンタワー、プロジェクタ、アテンションの射影、埋め込み層、LM ヘッドは 16 bit のままです。
- ナビゲーションは閉ループのタスクで、1 回の誤った行動がその後の観測を変え、誤差は軌跡に沿って累積します。そのため量子化後のモデルは閉ループで評価する必要があります。
同じ 4 bit でも、違いは実行経路にある
著者らはまず疑似量子化(重みを目標の格子に丸めつつ 16 bit のまま保持)で各精度を掃引し、形式そのものが成功率に与える影響だけを調べ、そのうえで実際のデプロイ経路を比較しています。成功率(SR)とオラクル成功率(OSR)は、Habitat シミュレータ上の R2R VLN-CE val-unseen の全 1,839 閉ループエピソードから得たもので、すべての構成を同一の GPU で採点しています。レイテンシ、電力、エネルギー、メモリは、Orin NX 上で別途行った再生測定の値です。論文の表 I(a) は次のとおりです(エネルギーとレイテンシはナビゲーション 1 ステップあたり)。
| 形式 | 重み (GB) | SR (%) | OSR (%) | 常駐メモリ (GB) | 電力 (W) | エネルギー (J) | ステップ・レイテンシ (s) |
|---|---|---|---|---|---|---|---|
| BF16 | 16.06 | 57.69 | 65.04 | 14.99 | 10.85 | 151.68 | 13.98 |
| INT8(ロードは可能、8 ステップ後にメモリ不足) | 10.36 | 57.04 | 64.82 | 15.98 | – | – | – |
| INT4 | 7.68 | 57.48 | 64.60 | 15.85 | 19.79 | 419.70 | 21.21 |
| NF4 | 7.68 | 57.15 | 64.76 | 14.70 | 18.18 | 19.31 | 1.06 |
| IQ4_NL(デプロイ) | 7.94 | 57.31 | 64.11 | 11.35 | 16.97 | 11.41 | 0.67 |
| INT2 | 6.44 | 46.00 | 55.79 | 16.03 | 20.08 | 437.86 | 21.81 |
4 bit 形式の SR はいずれも BF16 との差が 0.54 ポイント以内で、2 bit では 46.00% まで落ちます。INT4 と NF4 の重み(7.68 GB)は IQ4_NL(7.94 GB)より小さく、PyTorch 上でボード上の再生も完走しますが、ピーク常駐はそれぞれ 15.85 GB と 14.70 GB に達し、著者らのドライバ上の IQ4_NL は 11.35 GB にとどまります。エネルギーでは IQ4_NL が 1 ステップ 11.41 J、NF4 はその 1.7 倍、INT4 は 36.8 倍です。論文は INT4 の 1 ステップ 21.21 s を逆量子化の経路によるものとしています。同じ PyTorch 上で重みサイズも同じなのに、INT4 の 1 ステップあたりのエネルギーは NF4 の 21.7 倍(419.70 J 対 19.31 J)、レイテンシは 20 倍(21.21 s 対 1.06 s)です。BF16 は全体を常駐させられず、28 個の Transformer ブロックのうち 20 個と出力層だけが常駐し、残りはトークンごとにストレージから読み込まれます。その結果、レイテンシは IQ4_NL の 20.8 倍、エネルギーは 13.3 倍で、SR は 0.38 ポイント高いだけです。平均電力が最も低い(10.85 W)のは、GPU がストレージ待ちをしているためです。
デプロイ点の 1 ステップ 0.672 s は償却値です。1 回の生成で 4 つの行動を出力し、89 回のリクエストのうち生成が走るのは 24 回だけで、残りはバッファ済みの行動を 0.024 s で返します。4 行動分の 1 回の決定あたりでは 2.49 s、42.3 J です。
llama.cpp ドライバが担うこと
llama.cpp にはネイティブの低ビット・カーネルがありますが、1 ターンに 1 枚の画像しかエンコードせず、StreamVLN のローリング・コンテキストを扱うインターフェースがありません。著者らの VLN ドライバがこれを補います。
- ビジョンタワーとプロジェクタをランタイムのマルチモーダル形式に書き出し、27×27→14×14 のプーリングを再実装して、1 フレームあたり 196 トークンを得ます。
- 32 ステップごとにコンテキストをクリアし、ストライドでサンプリングした過去フレームを生の埋め込みバッチとして再注入します。
- StreamVLN の論文に記述はあるもののコードでは公開されていないボクセル単位の空間トークン剪定を実装しています。各トークンセルで有効な深度ピクセルの中央値を取ってボクセルに逆投影し、時間バケットごとに各ボクセルの最新トークンだけを残します。剪定は履歴を再注入するときだけ実行されます。論文によると、全実行の 3,252 のチャンク境界で再注入メモリトークンの 41.7% を除去し、償却ステップを 0.744 s から 0.672 s に短縮、SR の変化は +0.05 ポイント(1,839 エピソード中 1 エピソード)でした。
最終的な推論経路は GGUF の重み、ドライバ、ランタイムだけで構成され、深層学習フレームワークは含まれません。
LATTE:バックボーンが計算済みの隠れ状態から停止の時機を判断する
SR と OSR の差は量子化してもほとんど変わりません。BF16 で 7.35 ポイント、IQ4_NL で 6.80 ポイントです。OSR は軌跡がいずれかの時点でゴール半径に入ったかを数えるため、この差は、約 7% のエピソード(6.80〜7.35%)で軌跡がゴール半径に入りながら、その中で停止しなかったことを示します。著者らはここから、停止の誤りは量子化によるものではなくベースモデル自体の性質だと結論づけています。
LATTE はバックボーン第 24 層の隠れ状態を読み、各フレームの 196 個の画像トークンを平均プーリングして 3584 次元の特徴を得ます。最大 256 の決定ステップをバッファし、時間方向に平均してから 256 次元に射影し、因果マスク付きの pre-norm Transformer エンコーダ 2 層(4 ヘッド、FFN 幅 512)に通して 0〜1 の「停止ランク」を出力します。学習ターゲットは clip(1 − d/5.0 m, 0, 1) で、最接近ステップの後と、ゴールがカメラ高さの可視性テストに通らないときは 0 にします。ヘッドはバックボーンを凍結したまま、R2R VLN-CE 学習分割の成功ロールアウト 3,184 本の特徴で別途学習します。トリガーにはヒステリシスがあり、スコアの累積最大値がしきい値を超え、かつ現在値がそこから一定幅下がったときにだけ STOP を出し、最小ステップ数も設けています。ヘッドは FP32 のまま CPU 上で動きます。
7 つの候補ヘッドの比較から、ヘッドが何を読むかで結果が決まることがわかります。プーリングした視覚特徴を読む MLP ヘッドは BF16 の SR を 57.69% から 51.70% に下げ、指示文を連結すると 45.79%、FiLM では 55.14% でした。改善したのはデコーダの隠れ状態を読む MLP ヘッドだけです(第 20 層 58.24%、第 24 層 58.13%、いずれも 15.7 MB)。LATTE は BF16 で 58.35%、IQ4_NL で 58.02%、サイズは 8.2 MB です。IQ4_NL では 26 エピソードを正し、13 エピソードを壊し、SR を 0.71 ポイント上げる一方で OSR を 0.65 ポイント下げました。変えているのは経路ではなく停止の判断です。著者らが報告する追加コストは 1 ステップあたり 0.013 s、0.13 J(約 +1.9% と +1.1%)です。別の測定上の制約として、著者らは同じバックボーン上の候補ヘッド間のボード測定差が繰り返し実行のばらつきより小さく、比較すべきではないとしています。これは LATTE の追加コストがそのばらつきより小さいと示したものではありません。
本サイトの既存記事との関係
「フロンティア・レーダー特集|エッジとリアルタイム性:VLA と世界行動モデルのレイテンシ予算はどこに使われているか」でまとめた 9 月の資料では、量子化は実測で省メモリになるものの低速でした。EdgeVLN では、実行経路を個別に比較する必要があり、低速化を量子化一般の性質とはみなせません。同じ PyTorch 上で INT4 は 1 ステップ 21.21 s、NF4 は 1.06 s で、論文は INT4 の所要時間を逆量子化の経路によるものとしています。INT2 も 1 ステップ 21.81 s、437.86 J と低速ですが、そのランタイムは明記されていません。比較対象の BF16 もそれ自体が不利な条件にあります。28 個の Transformer ブロックのうち 8 個はトークンごとにストレージから読み込まれ、13.98 s にはその読み込みが含まれます。したがって、NF4 が BF16 より約 13 倍速いことも、INT4 が BF16 より遅いことも、「量子化は速い」「量子化は遅い」という一般論にはなりません。ピーク常駐メモリも同様で、INT4 は 15.85 GB と一部しか常駐していない BF16(14.99 GB)を上回り、NF4 は 14.70 GB、著者らのドライバ上の IQ4_NL は 11.35 GB です。「量子化で速くなるか」は形式の実装とランタイムをあわせて答える必要があります。「フロンティア・レーダー特集|シミュレーションと評価:VLA の評価に初期状態成功率以外で欠けているもの」では量子化後の閉ループ検証を取り上げました。この論文も同じ考え方で 1,839 の閉ループエピソードを評価し、さらに SR と OSR の差を使って停止の誤りを切り分けています。講座で計画中の L2「エッジデプロイにおける量子化、レイテンシ、制御周波数」の回(講座紹介を参照)や、第 0.2 回の搭載計算資源の話でも、これらの数字は例として使えます。ピーク演算性能だけでなく、常駐メモリ、1 ステップあたりのエネルギー、実行経路も見る必要があります。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者の報告です。本記事が依拠した資料には独立した再現もコードリポジトリへのリンクもありません。
- SR と OSR はシミュレーションの結果です。ボード上の測定は、静止したロボットに実環境で録画した 89 フレームの系列を再生して行ったもので、実環境での閉ループ・ナビゲーションではありません。論文は実機でのナビゲーション成功率を報告していません。電力はモジュールの電源レールで測定しており、モーターを含まず、待機電力も差し引いていません。
- LATTE のトリガーのしきい値と下降幅は、報告しているのと同じ val-unseen エピソード上の 16 セルのグリッド探索で選ばれています。著者らは、ホールドアウト分割がないため、この改善は上限として読むべきだと述べています。「BF16 のベースラインを上回る」とは 58.02% 対 57.69%、差は 0.33 ポイントです。
- 著者らによれば、同じバックボーン上のヘッド間のボード測定の差は繰り返し実行のばらつきより小さく、比較すべきではありません。BF16 の行は 1 回だけの実行で、その他の構成は 3 回の平均です。
- 論文はある箇所で、ボクセル剪定は RGB のみの VLN-CE 設定では働かない(評価エージェントがエンコーダに渡すのはダミーの姿勢とゼロ値の深度マップ)と述べる一方、別の箇所では全実行で再注入トークンの 41.7% を除去したと報告しています。両者の関係は論文中で説明されていません。
- 論文は「我々の VLN ドライバ上の IQ4_NL だけがボードに収まる」(only IQ4_NL under our VLN driver fits the board)と述べていますが、NF4 と INT4 もボード上の再生を完走しており、ピーク常駐はそれぞれ 14.70 GB と 15.85 GB で、統合メモリプールは 16.14 GB です。論文は「収まる」の基準を定義しておらず、実際のカメラパイプラインに必要な余裕や長時間の連続動作を求めるのかは不明です。そのため本記事では、どの形式が「収まる」かを確定した結論として扱いません。
- 論文が明記しているのは、INT4 と NF4 が PyTorch 上、IQ4_NL が著者らの llama.cpp ドライバ上で動いたことで、INT8 と BF16 のランタイムははっきり書かれていません。そのため、表の形式間の差には形式とランタイムの両方の要因が含まれます。
リンク
- arXiv 2609.35570:EdgeVLN: Runtime-Aware Deployment Ready Quantized Vision Language Navigation Model(著者:Rithvik Jonna、Man Namgung、Aakash Gurram、Tinoosh Mohsenin)
- 論文の HTML 版全文


