人の一人称視点動画をロボットのデータに変換する既存のパイプラインは、主に手と腕の動きを移し替えています。プレプリント Ego2X(arXiv 2611.24138、2026-11-18)の著者は、単眼で推定した手はカメラの視線方向に数センチずれる一方、安定した操作には物体表面でミリ単位の精度が必要だと指摘します。その結果、リターゲティング後の指は物体の横に浮き、平行グリッパは何もない所で閉じます。Ego2X はすべての接触を物体座標系で記録し、それを使って多指ハンドや平行グリッパを動かし、最後に RoboTwin 2.0 シミュレータで閉ループ再生して、実際にタスクを完了したクリップだけを残します。以下の数値はすべて著者報告 [R] で、本サイトでは再現していません。論文には実機での展開はまだ完了していないと書かれています。
本サイトの講座 フィジカルAIラボ 1.5 では、人の動画は量が多いものの「人の手はロボットの手ではない」ため、ロボットの手に翻訳してから使う必要があると説明しました。以前紹介した EgoJEPA はリターゲティングを避けて潜在動作を直接学習し、DexStitch は接触に導かれた修復で人の動画を多指ハンドのデータに変換します。Ego2X はリターゲティングの路線にとどまります。違いは移し替える対象を物体上の接触に変えた点と、シミュレーションでの物理的な検証をクリップが学習データに入る条件にした点です。
CORE が接触ごとに記録するもの
Ego2X の中心は CORE(Contact-centric Object-interaction REpresentation)です。フレームごと、接触ごとに 4 項目の記録を持ちます。
- 位置:接触している MANO の手の領域、物体座標系での表面アンカー、その外向き法線。
- 力の事前分布:各領域の相対的な荷重の割合、押す方向、法線方向の支持力の下限。
- 把持モード:掌と指のどの領域が物体に触れているかで、掌での保持、パワーグラスプ、中間把持、指先保持、精密ピンチ、フック把持、不明の 7 種類に分けます。各モードには、それを実現するロボット側の接触パッドが対応します。
- インタラクション状態:Approach、Acquire、Hold、Transport、Release の 5 種類で、グリッパの開閉、動画中の物体ピクセルの保護、シミュレーションの経由点を同期させます。
接触位置の求め方は、単眼の手の深度は視線方向にずれるが、2D 投影の位置は正確だという観察に基づきます。Ego2X はまず EgoTac で画像の触覚的な見た目から接触のタイミングを検出し、次にカメラ中心から手の各頂点のピクセルを通る光線を飛ばして、物体の符号付き距離場(SAM 3D で再構成したメッシュから計算)との最初の交点を求めます。各アンカーは掌側の向き、隣接する指節が貫通していないか、物体の剛体運動と一致するか、2D の遮蔽順序に基づいて Certified、Trusted、Hypothesis、Uncertain の 4 段階に分けられます。後段の深度補正と逆運動学を拘束するのは上位 2 段階だけで、残り 2 段階は時間的な連続性を保つためにだけ使われます。
論文は、触覚センサーがなければ単眼 RGB からニュートン単位の把持内力を一意に決めることはできないと明記しています。そのため CORE の力は事前分布にとどまります。相対的な割合は EgoTac の予測強度を正規化して得ます。支持力の下限は、メッシュ体積に 0.5、1.0、1.5 g/mL の 3 段階の参照密度を掛けて物体の質量を推定し、重心加速度から重力加速度を引いた大きさを掛け、さらに手の負担割合と各領域の割合を掛けて配分します。
1 本の動画から 1 つの LeRobot エピソードへ
入力は単眼の一人称視点動画 1 本と対象ロボットの URDF です。出力は検証済みの LeRobot エピソードで、ロボットの動作、学習用マスク、持っている物体を残した動画を含みます。その間に 4 つのステップがあります。
- 分離した深度補正:手で物体のスケールを決め、その物体で手の深度を補正すると、両者の誤差が循環的に結びつきます。Ego2X は物体と手を 2 つの経路に分けます。手は根元のカメラ光線に沿って −150〜+50 mm の範囲でのみ平行移動し、移動量は Certified と Trusted の頂点とアンカーの組による Cauchy 目的関数で選びます。
- 形態をまたぐリターゲティング:URDF コンパイラがロボットのリンクの衝突メッシュをサンプリングし、把持モードに合った接触パッドにします。多指ハンドでは逆運動学がパッドを CORE アンカーへ引き寄せます。平行グリッパでは物体の距離場上でジョーの開き幅に合う対向する接触点の組を探し、接触区間ごとに物体座標系での把持姿勢を 1 つ固定します。
- 接触状態に基づく動画合成:Acquire、Hold、Transport の間は、消去マスクから物体の保護領域を差し引き、腕と一緒に持っている物体まで修復で消さないようにします。続いて接触の縁に残った肌色ピクセルを Lab 色で取り除き、レンダリングしたロボットを重ねます。
- シミュレーションでの閉ループ検証:RoboTwin 2.0 で再生し、物理的なチェックを通過したロールアウトだけを VLA の追加学習に使います。
幾何と接触の指標は、それぞれ条件が違う
アブストラクトの「接触中の手の深度誤差を 33.7% 削減」は、HOT3D の限られた設定によるものです。手の推定に HaWoR を使い、6 クリップで、データセット付属の物体姿勢を使ったとき、光線方向の誤差が 14.35 mm から 9.51 mm に下がりました。EgoHand の推定(10 クリップ)では、同じ誤差が 51.71 mm から 44.41 mm で、14.1% の削減です。物体姿勢を推定値にすると、接触中の物体の並進誤差の中央値は 8 クリップの確認用分割で 104.6 mm から 67.3 mm、11 クリップのホールドアウト分割で 141.9 mm から 99.1 mm に下がり、平均ではそれぞれ 30.4 mm、47.3 mm 減りました。
物体姿勢の出どころは接触の復元に大きく影響します。データセットの姿勢を使うと、CORE のフレーム F1 は 31 クリップで 0.924 です。FoundationPose で推定した姿勢(19 クリップ)では、そのままのフレーム F1 は 0.191 にすぎず、物体深度の融合後で 0.386 です。
EgoDex でのリターゲティングの比較(論文の表 4 と表 5)は次のとおりです。
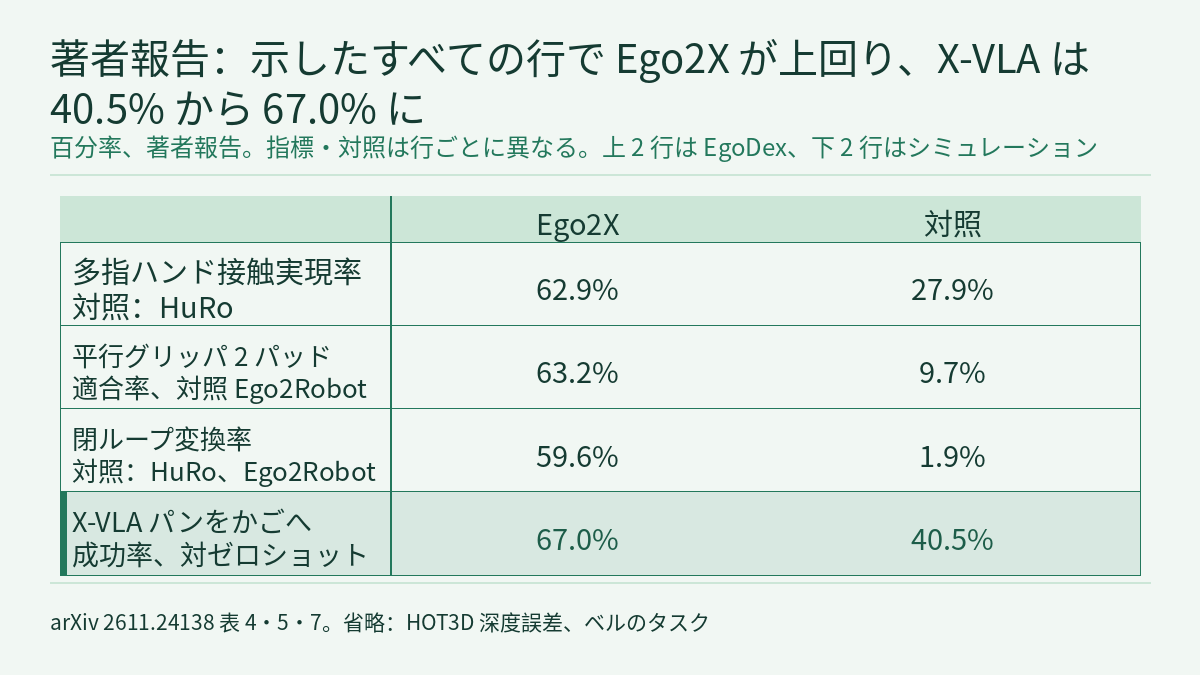
- 多指ハンド:79 テイク、25,549 の接触スロットで、パッドの符号付き距離が −5〜+10 mm に入れば「実現」とします。Ego2X の実現率は 62.9%、公式の HuRo stage-8 は 27.9% で、対応のある検定で p = 2.6 × 10⁻¹⁴ です。手首追従のアブレーションは 29.6% で HuRo に近い値でした。このアブレーションは Ego2X とフロントエンド、手首の目標、ソルバーを共有し、接触項だけを外しているので、差は接触項によるものと考えられます(アブレーションの設計からの本サイトの推論)。推定された人の MANO の手そのものも、全スロットでは 35.8% しか実現していません。関節速度は 7.5 rad/s 以内(HuRo は 63.9 rad/s)に収まり、手全体の貫通率は 4.4% 対 4.1%、p = 0.393 です。
- 平行グリッパ:28 の手の側、1,272 の把持フレームで、2 パッドの適合率は 63.2%、Ego2Robot は 9.7% です。入力条件は異なります。Ego2X と HuRo は単眼 RGB から再構成した手を使い、公式の Ego2Robot はデバイスで追跡した 3D の手のデータを使います。
- 5 種類のグリッパ:同じ CORE 記録から Panda + 2F-85、ARX5、Franka Hand、UR5 + WSG50、Piper へコンパイルすると、エンドエフェクタの実現率は 0.796〜0.820 です。テーブル端に固定設置した場合の腕全体の逆運動学は、0.032(Piper)から 0.695(UR5 + WSG50)まで幅があります。
動画合成では、ピクセル単位で監査した 3 テイクで、物体を保護せずに腕を消去すると、見えている把持物体のピクセルの 19.4%〜55.0% が消えました。CORE の区間で保護すると 3.0%〜11.2% に下がります。未見の EgoDex 14 テイク(663 フレーム)では、接触の縁での肌色のにじみが 12.55% から 0.00% に下がりました。
シミュレーションでの検証と X-VLA の追加学習
RoboTwin 2.0 で同じシミュレータのチェックをかけると、Place bread in basket の対応する動画 52 本のうち、Ego2X は 31 本(59.6%)を変換できましたが、HuRo と Ego2Robot はそれぞれ 1 本(1.9%)でした。Place bell on scale では 53 の仕様のうち Ego2X が 45(84.9%)、2 つのベースラインはどちらも 0/53 です。論文はこれらを matched videos と呼んでおり、その節では出どころを説明していません。
続いて著者は、シミュレータのデモを一切使わず、Ego2X で変換したクリップだけで X-VLA を追加学習し、200 組の対応シーンで Place bread in basket を評価しました(論文の表 7。p 値はゼロショットに対する Holm 補正済みの正確な McNemar 検定)。
| 学習データ | クリップ数 | 成功率 | ゼロショットとの比較 |
|---|---|---|---|
| ゼロショットの X-VLA | 0 | 40.5% | ベースライン |
| Ego2X、未選別のデータプール 2 つ | 55 / 73 | 41.0% / 44.5% | 有意差なし |
| Ego2X、シミュレーション検証を通過(P70) | 70 | 63.5% | p = 7.4 × 10⁻⁶ |
| Ego2X、シミュレーション検証を通過、レイアウト重み付け(55 lw) | 55 | 67.0% | p = 5.0 × 10⁻⁷ |
| シミュレータの専門家デモ(参考) | 20 | 72.0% | 参考 |
この表から 2 点が読み取れます。1 つ目に、同じ出どころの変換データでも、検証しなければ成功率はゼロショット付近にとどまり、シミュレータのチェックを通した後で初めて 63.5% と 67.0% に上がります。2 つ目に、67.0% はシミュレータの専門家デモ 20 本による 72.0% をまだ下回っており、論文はこの 2 つの間の検定を示していません。結論で述べられている「26.5% の向上」は 67.0% と 40.5% の差で、単位はパーセントポイントです。
そのほかの結果です。最初の 50 シーン(ゼロショット 44.0%)では、検証済みの Ego2X が 70.0% で、HuRo と Ego2Robot がそれぞれ 1 本だけ持つ検証済みクリップで学習すると 2.0% と 4.0% でした。3 シードの共同学習(シミュレータのデモ 20 本と未選別クリップ 24 本)では、HuRo のデータを加えるとシミュレータのデモだけの場合より成功率が 7.5 ポイント下がり、Ego2X は HuRo を 5.5 ポイント上回りました(95% 区間 [+0.7, +10.3])。Place bell on scale(200 シーン、ゼロショット 17.0%)では、未選別の 40 クリップで 27.0%、zero-retry の 40 クリップでタスクに合わせたプロンプトなら 55.0%、固定のプレースホルダー・プロンプトなら 48.0%(195 シーン)でした。
制約と注意点
- これは arXiv のプレプリントで、数値はすべて著者報告 [R] です。本サイトでは再現していません。著者は変換パイプラインと CORE 注釈付きデータセットを「公開する予定」と書いており、本サイトは公開済みかどうかを確認していません。
- 実機の結果はありません。論文の Future Work には、ハードウェアとスケジュールの制約により実機での展開はまだ進行中だと書かれています。方策の成功率はすべて RoboTwin 2.0 シミュレーションの 2 タスクによるもので、シミュレーションでの成功率はハードウェアの安全性検証ではありません。
- CORE の力は視覚と運動学に基づく事前分布で、センサーで校正したニュートン単位の力ではありません。著者は触覚の統合で対処する予定です。
- 著者は、強い遮蔽の下では接触の位置推定が物体姿勢の推定誤差に制約されると認めています。推定姿勢でのフレーム F1 は上記のとおり 0.386 で、データセットの姿勢での 0.924 と大きく離れています。
- 33.7% は HaWoR、6 クリップ、データセットの物体姿勢という設定にだけ当てはまります。幾何指標のサンプルは小さく(6〜31 クリップ、合成の監査は 3 テイク)、比較対象の入力条件も異なります。特に Ego2Robot はデバイスで追跡した手のデータを使っています。
- 本記事は論文の arXiv HTML 本文に基づいており、補足資料は確認していません。
リンク
- Ego2X: Contact-aware Transfer from Egocentric Human Data to Any Robot(arXiv 2611.24138)
- 論文の HTML 全文
- フィジカルAIラボ 1.5:データはどこから来る?――SO-101 のメタデータからお手本の長さを求め、三つの入手ルートの単位と動作空間を見分ける
- フロンティア・レーダー|EgoJEPA:人からロボットへのリターゲティングをやめ、一人称視点の人間の動画から潜在動作を学び、ロボットごとにアダプター 1 組を加えて調整する
- フロンティア・レーダー|DexStitch:「遷移」もスキルとしてラベル付けし、人間の動画から多指ハンドのスキルを切り出し、変換し、つなぎ合わせる
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)