本节视频
配音由 AI 合成。 视频章节、文字稿与出处
文字稿
文字稿
知行问
教机器人走路,得摔无数跤。真机哪摔得起?这一集,我们在仿真里同时开一大批环境。用强化学习,教一个人形机器人走路。用的是 Isaac Lab。
为什么在仿真里练
让真实机器人学走路,太难了。摔一次可能就摔坏。还得有人守着,慢得要命。换个说法:真实的机器人是唯一的宝贝,摔坏就没了。你也不敢让它使劲试。真机器人还慢。一次动作,得等它真的做完,急不得。而且一次只能教一台机器人。你想快,也快不起来。仿真中就没这顾虑。摔了重来,不花钱。一个零件也不会坏。仿真还能加速。里面的时间,能比真实快很多倍。更关键的是并行。真机只有一台,仿真能同时开一大片。在仿真里,你可以放开手。让它使劲摔,往死里试。当然,仿真不是真实。这一点,我们最后再说。
强化学习:靠奖励学
前两集是看示范学。这一集不一样。这回,没有示范。怎么学?靠试错。走得好给奖励,摔了扣分。有点像训练小狗。做对了给块饼干,做错了不给。它不知道什么叫走路。它只知道,怎么做分数高。这既是好事,也是坏事。它会拼命找拿分最省事的办法。关键就一句:给什么奖励,它就学什么。想让它走得快又稳?就照这个方向给分。好处很实在。不用人一条条示范。给个目标、给套奖励,它自己试。难点也在这儿。奖励设歪了,它就钻空子。比如你的奖励只看往前走,它可能冲两步,摔个漂亮跟头。拿走路说:前进给奖励,摔倒重罚,还鼓励省力气。把这些揉成一个分数。它每走一步,都在算怎么多拿分。训练算法用现成的,叫 PPO。它一边试,一边把好的留下。它不要你手把手。你只要把奖励和规则定好。原来不用教,给对了奖励,它自己就摸索出走路了!
几千个环境一起练
先说环境。一个环境,就是一个机器人加一小片地。它在里面反复练。这一小片地,可能平,也可能坑坑洼洼。逼它练出真本事。从平地到斜坡,从台阶到碎石。见过的越杂,走得越稳。把这一个环境,复制成很多很多份。它们同时开跑。GPU 厉害在这儿。它能同时算好多份,一个屏幕上开出一大群。每个环境各走各的,各摔各的。互不影响,一起长经验。有的在爬坡,有的在摔跤,有的已经走得挺稳。都在同一个画面里。一批环境同时跑下来,海量经验,一下就喂给它了。官方文档说,Isaac Lab 用端到端 GPU 训练。它能同时并行数千个环境。多到什么程度?入门教程里,一个平衡杆任务,就开六十四个环境。换成人形机器人走路,也是一大群一起练。差距一下就出来。别以为要超算。一块消费级显卡,就能开出一大群。一起练,经验攒得快。几千份经验同时进来。学得飞快。同样一段时间,它见过的摔法、走法,比真机多得多。经验多了,它就摸清了:脚怎么落,身子怎么稳。原来一块显卡里,能同时站着一大群机器人练走路!
动手与边界
打开本集 Notebook。先提醒:它要 N 卡和 Ubuntu。装起来不轻。装好 Isaac Sim,再装 Isaac Lab。命令都在里面,照抄就行。装的时候会拉不少依赖。第一次,可能要等上一阵。装完最好先跑个自带的小示例。确认环境没问题,再上大任务。一条命令开始训练。任务选人形机器人走路,加无头模式,跑得更快。无头模式,就是不画那个漂亮窗口。省下的算力,全用来练。先用小配置冒烟。环境开少点,迭代跑几轮,看能不能起步。训练时盯奖励曲线。它一路往上走,就说明越走越好。这条曲线,就是它进步的成绩单。看它,比看画面还准。曲线抖一抖,是正常的。只要大方向朝上,就有戏。要是奖励不涨,多半是奖励没设对。回去改,再练。训练完,回放一下。你能看它在地形上,一步步走稳。那一刻挺神奇:没人教它迈步,它自己学会了走。这就是仿真训练的魅力。省时间、省钱,还安全。所以别嫌装起来麻烦。跑通一次,后面都能重复使用。为了以后上真机,训练时故意加扰动。地面滑一点。冷不丁推它一把。见过的坑越多,真机上遇到新情况,它才不慌。但仿真终究不是真实。仿真里走得稳,真机上不一定。怎么跨过这道坎?域随机化、系统辨识。下一集,我们专门讲。回顾一下,三个要点。一,仿真里练走路,摔了不心疼,还能一起练。二,强化学习靠奖励,不用示范。三,GPU 能同时开数千个环境,学得飞快。所以摔无数次没关系,那都在仿真中,一块显卡就包了!可仿真中走得稳,真机上摔了怎么办?下一集见!
证据与出处
动手与自测
小测公开,答案与解析在作答后显示;图文课里的练习答案需登录查看。
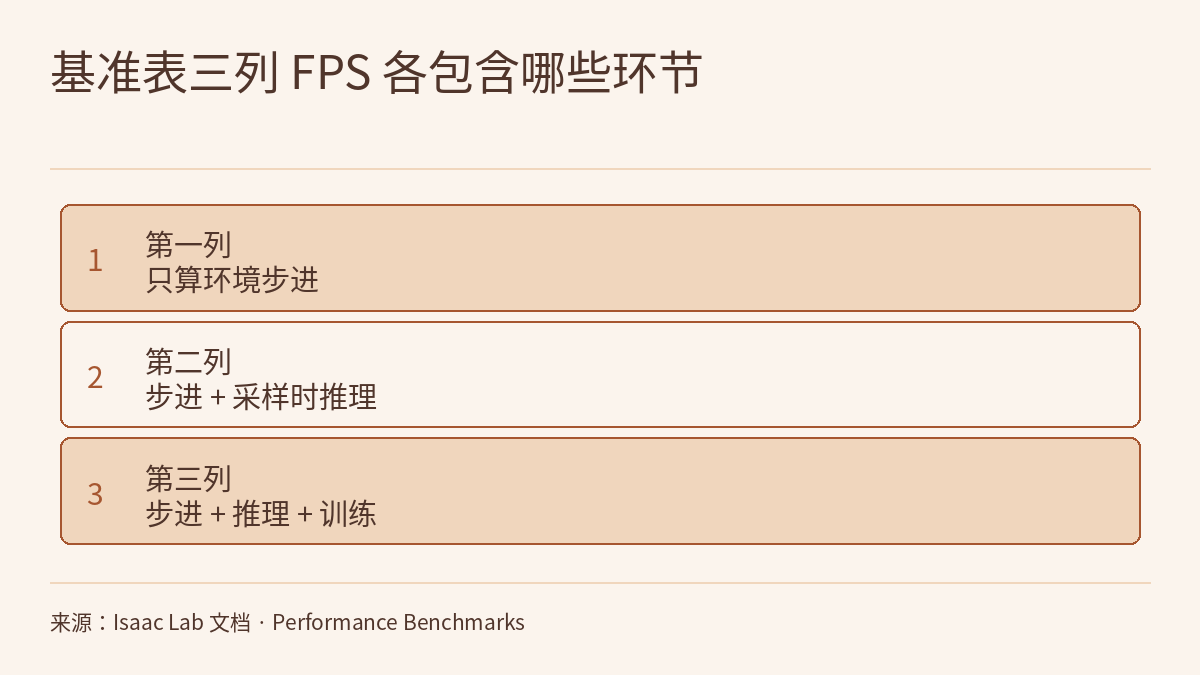
第 2.4 集的视频讲在 Isaac Lab 里用强化学习教一个人形机器人在各种地形上走路。视频讲了三件事:仿真里摔了不心疼,还能一大群一起练;强化学习靠奖励试错,不用示范;GPU 能同时并行数千个环境,但仿真不是真实,上真机还要跨 sim2real。片中两张数字卡出自 Isaac Lab 官方文档的两页:Performance Benchmarks 页说 Isaac Lab 用端到端 GPU 训练,可以在数千个环境上快速并行训练;入门教程 Training with an RL Agent 里,平衡杆(Cartpole)任务的训练命令写的是 –num_envs 64。本篇是这一集的图文课与练习,不重复文字稿,而是把这两页文档本身读清楚:基准表里三列 FPS 各包含哪些环节,不同显卡和节点的数字能怎样比、不能怎样比;教程那条命令的每个参数管什么,–num_envs 和 –max_iterations 怎样一起决定一次训练的总步数,日志、视频和检查点落在哪里。贯穿全文的规则:一个吞吐数字只属于它那一行的任务、环境数、硬件和 RL 库;一次训练的总步数要从它自己的参数算出来,不能从别处的表格搬。
本节视频、文字稿与出处在本页上方,全季安排见课程大纲。上一课物理AI实验室 2.3:微调 SmolVLA,为一句指令配好示范数据,核对每个数字的口径,再给异步动作队列算时间账结尾问:要教它走路,得在虚拟世界里练无数遍,又怎么练?本课接着回答。奖励、回报和奖励怎样被钻空子,以及 Learning to Walk in Minutes 的地形课程与超时重置,物理AI实验室 1.7:强化学习,手算一局回报看奖励怎样被钻空子,再读论文里的地形课程与超时重置已经讲过;同一篇论文“数千个机器人、不到四分钟”的实验条件,物理AI实验室 0.4:在虚拟世界练一万遍,给三个仿真数字补上实验条件已经逐条核对过;训练预算里步数、批量与样本数怎样分开记账,物理AI实验室 2.2:用 LeRobot 训练 ACT,把数据集元数据对到模型输入,再逐项核对训练与评测命令已经练过。本课不再重复这些,也不讲域随机化与系统辨识(下一集的内容),只讲视频新用到的两页 Isaac Lab 文档。
公开小测的 5 道题附完整解析;登录后可完成三项练习:按教程的训练脚本为一次虚构的平衡杆训练写出冒烟与正式命令,并从 –num_envs 和 –max_iterations 算出总步数与记录点;用基准表的真实数字复算三列 FPS 之间的差、多卡扩展和两种单卡配置之比,再判断四条说法;审一份拿基准表估算人形走路训练时间和显存的虚构计划,并改写成先测量、再放大的方案。每项都附分步解法、常见错误与 20 分评分标准。
一、两页文档,各自说了什么
两页都是 Isaac Lab 的官方文档(片中数字卡标为 NVIDIA 官方文档),按本课程的分级属 O 级。本课读的是不带版本号的 main 分支页面,抓取于 2026-10-19;页面没有写明对应的 Isaac Lab 或 Isaac Sim 版本,本课也没有绑定版本。文档里的数字都是官方自报,本站没有复现。
Performance Benchmarks 页的开头一句,就是片中“数千个”那张数字卡:
Isaac Lab leverages end-to-end GPU training for reinforcement learning workflows, allowing for fast parallel training across thousands of environments.
同一页写明了基准的条件,以下两句各自独立摘录:
All benchmarking results were performed with the RL Games library with –headless flag on Ubuntu 22.04.
Isaac-Velocity-Rough-G1-v0 environment benchmarks were performed with the RSL RL library.
Training with an RL Agent 教程里,片中“64 个”那张数字卡对应第一种训练方式(无头运行)的命令:
./isaaclab.sh -p scripts/reinforcement_learning/sb3/train.py --task Isaac-Cartpole-v0 --num_envs 64 --headless教程对无头运行的解释:
Typically, it speeds up the training process since only physics simulation step is performed.
下表把片中说法和两页文档对上,是本课的整理,不是原文句子:
| 片中说法 | 出处 | 文档写明的条件 | 文档没有说什么 |
|---|---|---|---|
| 可同时并行数千个环境 | Performance Benchmarks | 端到端 GPU 训练;基准表里的环境数是 1024、4096 或 8192 | “数千个”不是上限,也不是保证;表里没有其他环境数 |
| 加无头模式,跑得更快 | Training with an RL Agent | 无头时训练中不渲染,通常更快,因为只做物理仿真步 | 没有给出快多少 |
| 入门平衡杆开 64 个环境 | Training with an RL Agent | 用 Stable-Baselines3 的 PPO 训练 Isaac-Cartpole-v0,示例命令写 –num_envs 64 | 没有说 64 是推荐值 |
| 人形机器人走路,也是一大群一起练 | Performance Benchmarks | 表中人形任务 Isaac-Velocity-Rough-G1-v0 开 4096 个环境,用 RSL RL 测;内存 6.5 GB,显存 6.1 GB | 没有写这个任务的奖励、地形,也没有写训练多久能走稳 |
| 一块消费级显卡就能开出一大群 | Performance Benchmarks | 单卡配置之一是 RTX 4090,CPU 为 AMD Ryzen 9 7950X | 页面没有给显卡分类,也没有说更小的显卡能开多少 |
读这张表要注意三点:
- 两页的平衡杆不是同一个任务名。基准表里是 Isaac-Cartpole-Direct-v0(另有带相机观测的 Isaac-Cartpole-RGB-Camera-Direct-v0),教程和基准脚本的示例用的是 Isaac-Cartpole-v0。表里的显存和 FPS 不能直接套到教程那条命令上。
- RL 库不同。基准表除 G1 那一行外用 RL Games,G1 用 RSL RL,教程用 Stable-Baselines3。页面没有给出同一环境换 RL 库后的对比,所以“含训练”那一列的数字只属于表里那个库。
- “一大群”在代码里是一个维度。教程写道:
The input and outputs of the environment are not numpy arrays, but rather based on torch tensors with the first dimension being the number of environment instances.
也就是说,–num_envs 64 时,观测、动作和奖励都是第一维为 64 的张量。各个 RL 库期望的接口不同(例如 Stable-Baselines3 期望 VecEnv 接口,即一组 numpy 数组),所以 Isaac Lab 用 isaaclab_rl 模块里的包装器做转换。教程提醒,学习框架的包装器要最后套上,放在其他包装器之后,因为它改变了环境接口的含义,之后可能不再与 gymnasium.Env 兼容。
登录后继续阅读本课其余各节、自测题与答案。
局限 / 注意
- Performance Benchmarks 与 Training with an RL Agent 都是 Isaac Lab 官方文档,属 O 级;本课读的是不带版本号的 main 分支页面,抓取于 2026-10-19,没有绑定 Isaac Lab 或 Isaac Sim 版本。命令、参数和默认值可能随版本变化。基准表的数字是官方自报,本站没有复现。
- 页面没有定义 FPS 是否按所有环境的步数之和计,没有说明多卡时环境数是每块卡还是总数,也没有写内存表在哪块 GPU 上测。以下是本课的读法或推断,原文没有这样写:三个环节用时相加;FPS 按所有环境的步数之和计;env.step 调用次数等于总步数除以环境数;–log_interval 按帮助文本理解为每 n 个 timesteps 记录一次;传 -1 时实际种子写进 params/agent.yaml。
- train.py 在读取 n_timesteps 之前调用 agent_cfg = process_sb3_cfg(agent_cfg, env_cfg.scene.num_envs),页面没有展示该函数改了什么;把总步数公式的结果当作实际训练的步数,以及任务一的 20,480 与 4,915,200,都建立在这一读法之上。
- 页面文本在提取时,基准脚本示例里 –task 后的等号两侧有空格,本课去掉了;照抄前请对照原页面。
- n_steps = 32、16、24,团队 P 与 R,它们的机器、8 GB 显存、5000 万与 2000 万步的预算、计划里的四句话、实测 FPS 40,000 与 52,000 以及 90 s 启动时间,都是练习用的虚构;10,240、20,480、4,915,200、609.8 s 等只在这些假设下成立。任务二中的倍数与比例是本课对表上真实数字做的除法,页面本身没有给出。
- 本文没有运行片中 Notebook、训练、回放或基准命令。视频里的奖励设计、地形、扰动和“自己学会了走”的画面,本课读到的两页文档都没有对应的数字,本课不作核对。仿真里走得稳不等于真机上走得稳;纸面计算和仿真结果都不是硬件安全验证。