
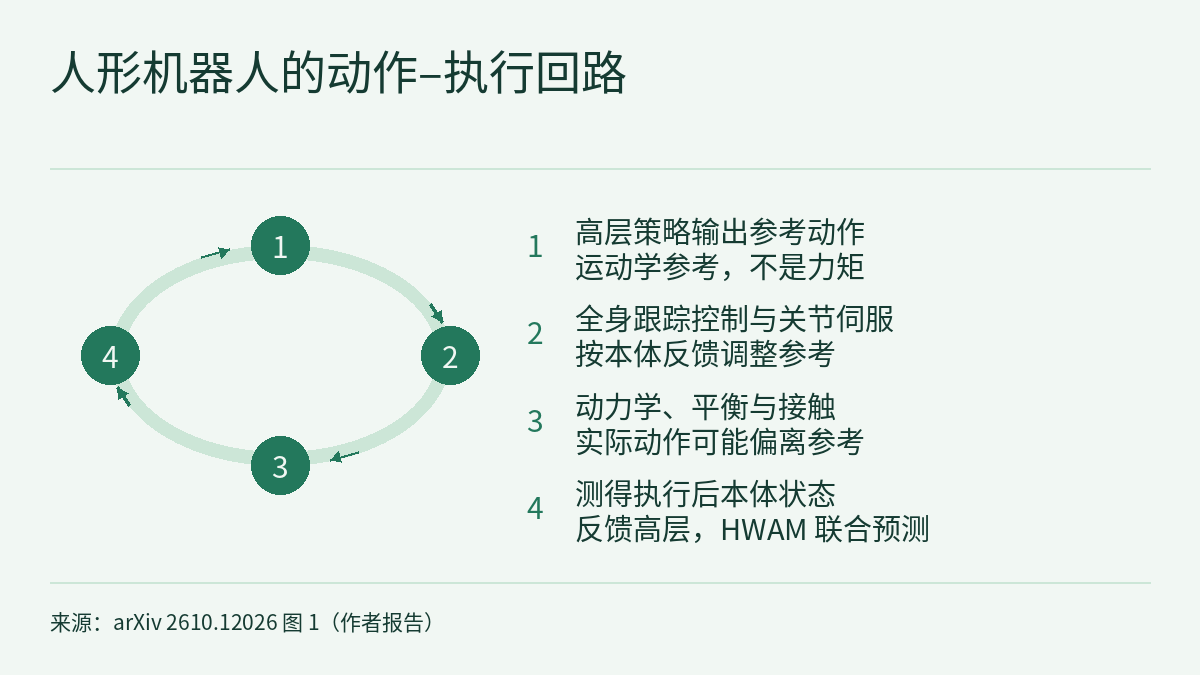
分层的人形机器人系统里,VLA 或世界动作模型(WAM)输出的是给底层全身控制器的参考动作,机器人实际做出的动作还要经过跟踪控制、动力学、平衡和接触,两者可能不一致。LimX Dynamics 团队的预印本 HWAM(arXiv 2610.12026,2026-10-08)把这个差距称为“动作–执行差距”,做法是让模型在生成参考动作的同时,生成执行后测得的本体状态,并用前向、逆向动力学两条视频路径把这条联合轨迹和画面变化接起来。作者报告,在 LimX OLI 人形机器人的三项真机任务上,HWAM 的成功率都是所比方法中最高的,其中 Candy Picking 为 70.6%,Fast-WAM 为 43.3%。以下数字均为作者报告 [R],本站未复现。
动作–执行差距:高层给的是参考,不是实际动作
论文采用的分层接口是:高层的视觉–语言–动作策略根据画面、语言指令和当前本体状态,在运动学空间里生成参考轨迹;底层的全身跟踪控制器用实时本体反馈,按执行时的动力学调整这些参考,再通过关节伺服驱动机器人。因此论文中的动作 a_t 是交给底层跟踪控制器的运动参考,不是直接施加在执行器上的力矩,也不假定能逐点实现。作者举的例子是:参考轨迹同时要求躯干移动和手臂伸出,底层控制器为了保持平衡调整躯干,手在接触时的轨迹也随之改变。
作者认为,如果不显式建模实际到达的身体状态,未来画面预测就得同时解释两件事:场景怎样变化,以及参考动作和实际动作之间差了多少,于是很难把一个动作和它的物理结果对应起来。为了说明差距确实存在,论文比较了记录数据中每个指令关节参考 a_t 与对齐的执行后本体状态 s_{t+1} 的平均绝对误差(MAE):
| 平台 | 直接 MAE(°) | 稳态 MAE(°) |
|---|---|---|
| LimX OLI(移动人形机器人) | 4.420 | 2.885 |
| ALOHA(固定双臂) | 0.648 | 0.402 |
“稳态”指关节参考近似恒定时的同一种配对。两个平台都有非零误差,移动人形机器人上的差距更大。作者把它作为建模执行后状态、而不是假设精确跟踪的动机。论文称完整的测量协议和逐关节统计在附录 A;本站所读的论文 HTML 版只给出上表的汇总值。
方法:把执行后状态放进生成目标,再用三条路径接上画面
联合状态–动作目标
对 H 步的预测时域,HWAM 把动作块 [a_t, …, a_{t+H-1}] 和状态块 [s_{t+1}, …, s_{t+H}] 沿特征维拼接,每个时间位置是 [s_{t+h+1}; a_{t+h}]。状态和动作通道在 token 投影之前拼接,由同一个状态–动作生成器、用同一个噪声水平一起去噪。作者的说法是:这样每一步去噪时,动作通道都能看到当前部分去噪的状态通道,状态监督也会影响用来生成动作的表示。论文同时说明,这种构造不显式学习底层动力学模型,也不施加单独的物理一致性约束;而且联合目标单独使用时不被假定有效,要靠下面的视觉路径接地。
两个专家、三条训练路径
模型由视频专家(WanVideoDiT)和状态–动作专家(ActionDiT)组成,两者参数分开,通过随路径变化的掩码交叉注意力交换信息,沿用 Fast-WAM 等此前 WAM 的混合专家接口。多视角画面由冻结的因果 Wan2.2 VAE 编码为当前和未来的视觉潜变量,语言用 UMT5-XXL 嵌入,与当前本体状态一起作为两个专家共享的条件。三条路径共享专家和参数,只是生成目标和可见条件不同:
| 路径 | 可见条件 | 生成目标 |
|---|---|---|
| Policy | 当前画面、语言、当前本体状态 | 状态–动作轨迹;不生成未来视频,与部署条件一致 |
| 前向动力学(FDM) | 当前画面、状态–动作轨迹、条件 | 未来视频 |
| 逆向动力学(IDM) | 当前与未来画面、条件 | 状态–动作轨迹 |
两种生成模态都用条件 flow matching 训练,状态和动作误差不加额外权重直接平均。每个 minibatch 均匀抽一条路径(各 1/3,权重均为 1)。FDM 让画面预测以实际到达的状态为条件,而不只以指令为条件;IDM 反过来,从画面变化推出动作和它造成的身体状态。部署时,预测的状态继续参与联合去噪,但只有动作被发给底层控制器。
真机结果:LimX OLI 上的三项任务
LimX OLI 是全尺寸人形机器人,全身动作空间 31 自由度(含两条 7 自由度手臂),配 BrainCo 灵巧手;策略输入头部和腕部相机的 RGB 画面、语言指令和当前本体状态。三项任务中,Candy Picking(按指令颜色取糖放进对应托盘区域)和 Object Collection(把桌上四件物体都放进篮子)是固定位置操作,Plush-Toy Picking 是需要全身协调的移动操作。各任务训练集分别为 1,783、4,220 和 404 个回合;Candy Picking 另有 422 个留出回合,只用于离线诊断。两个专家微调 6 个 epoch,AdamW,学习率 10⁻⁴,全局批量 128,用 16 块 A800 GPU,实现基于 FluxVLA Engine。
| 方法 | 额外机器人数据预训练 | Candy Picking | Object Collection | Plush-Toy Picking |
|---|---|---|---|---|
| Cosmos3-Edge | 是 | 15.8 | 0.0 | 56.7 |
| GR00T N1.5 | 是 | 40.5 | 42.5 | 60.0 |
| π0.5 | 是 | 62.5 | 45.0 | 60.7 |
| Fast-WAM | 否 | 43.3 | 0.0 | 60.0 |
| DiT4DiT | 否 | 52.5 | 15.0 | — |
| HWAM | 否 | 70.6 | 46.7 | 73.3 |
表中为真机成功率(%),“—”表示论文未报告或未核实。相对 π0.5,HWAM 的差距是 Candy Picking 8.1、Object Collection 1.7、Plush-Toy Picking 12.6 个百分点。在 Object Collection 上,Cosmos3-Edge 和 Fast-WAM 没能完成任务要求的抓篮子动作,所以全任务成功率为 0%。Fast-WAM 被作者视为最接近的 WAM 基线:它同样用视频共训练,部署时不合成未来视频。
只有 Candy Picking 给出了试验次数和 95% Wilson 置信区间:HWAM 84/119(区间 61.9–78.0%),π0.5 75/120(53.6–70.6%),Fast-WAM 52/120(34.8–52.3%),GR00T N1.5 49/121(32.2–49.4%)。作者说明这些区间假设各次试验是独立的伯努利试验,不衡量训练种子之间的差异。本站的读法是:HWAM 与 π0.5 的区间有重叠,π0.5 的上限正好是 HWAM 的点估计;区间重叠不是显著性检验,但说明仅凭这组试验,8.1 个百分点的差距仍有相当的不确定性。本站所读的论文 HTML 版没有给出另外两项任务的试验次数。
ALOHA 叠衣服
论文还在 ALOHA 双臂平台上评测了 Clothes Folding:任务专用训练集 640 条示范,按 0–100 分计分,完成部分折叠阶段也给分。HWAM 得 86.00 分,GR00T N1.5 为 78.75,π0.5 为 77.00,Fast-WAM 为 66.25,π0 为 65.00,GR00T N1.7 为 58.75,SmolVLA 为 51.25。作者明确说明这是在 ALOHA 上专门训练的结果,不是从 OLI 平台零样本迁移。
消融与离线诊断:联合目标要和三路径训练搭配
在移动操作任务 Plush-Toy Picking 上,作者做了 2 × 2 消融:预测目标是只有动作还是联合状态–动作,训练方式是 VGM/Policy(未来视频生成加 Policy 目标联合优化)还是 FDM/IDM/Policy,其余设置固定。
| 预测目标 / 训练方式 | VGM/Policy | FDM/IDM/Policy |
|---|---|---|
| 只有动作 | 60.0 | 55.0 |
| 联合状态–动作 | 45.5 | 73.3(HWAM) |
加入状态预测的效果取决于训练方式:在 VGM/Policy 下,成功率从 60.0% 降到 45.5%;在 FDM/IDM/Policy 下,从 55.0% 升到 73.3%。两种效果相差 32.8 个百分点。作者据此支持在所评测的设置中把联合目标和三路径训练组合使用,同时说明这个消融评估的是整体组合,不能区分单条路径或架构选择各自的贡献。本站所读的论文 HTML 版没有写出消融各配置的试验次数。
离线诊断在 Candy Picking 的留出回合上进行,用 4 步去噪,在前 31 个共享关节上按度计算 MAE。32 步动作块上平均,HWAM 的动作 MAE 为 3.816°,只预测动作的 FDM/IDM/Policy 为 4.024°;作者报告,加入状态监督在所有评测的训练方式下都降低了动作 MAE。注意,开环诊断和闭环消融用的是不同任务,开环 MAE 降低不能直接推出闭环成功率提高:VGM/Policy 加状态在闭环消融中反而变差。
未来视频预测在 12 个留出回合、抓取闭合前的时间窗上评估。用模型自己预测的轨迹作条件时,各配置的 PSNR 在 20.345 到 20.844 之间,HWAM 为 20.501,没有画质优势;作者也说明这些数字不能解释闭环成功率的差异。用真实轨迹作条件时,同时以动作和执行后状态为条件的 HWAM 为 23.336,只用动作的模型为 20.559,作者把它作为“以实际状态为条件有助于预测画面结果”的证据。
和站内已有内容的关系
课程物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统讲过,机器人的“想”和“动”分属不同层级、不同频率。HWAM 补上的是这两层之间的另一面:高层发出的参考,底层不一定按原样执行,而高层要学会这种偏差。物理AI实验室 1.6:模仿学习讲过动作分块;HWAM 的状态–动作块就是在动作块的每个位置上再并一个执行后状态。
前沿雷达此前介绍的ReCo处理的是四足移动操作中类似的接口问题,但路线不同:ReCo 训练行走策略作出可重复的响应,再辨识它的闭环响应模型交给 MPC;HWAM 不辨识底层动力学,而是把测得的执行后状态当作和动作一起生成的变量,预测的状态也不发给控制器。两篇论文的平台、任务和指标都不同,数字不能互相比较。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],作者均来自 LimX Dynamics(其中一位同时署名南方科技大学);论文称评测平台为 LimX OLI 人形机器人。本站没有复现任何结果。论文称代码、数据集和项目页已公开,本站没有核对。
- 只有 Candy Picking 给出了试验次数和置信区间;区间只反映试验抽样,不反映训练种子差异。Object Collection 上相对 π0.5 只高 1.7 个百分点,本站所读的论文 HTML 版没有给出它的试验次数。
- 消融只在一个任务上做,只比较整体组合,不能区分 FDM、IDM、Policy 各自的贡献。
- HWAM 不显式辨识底层动力学,预测的状态不发给控制器;它在画面预测质量上也没有优势。
- Candy Picking 按运动方向和工作区域的细分是任务内细分,不是留出空间划分的评测。ALOHA 结果是任务专用训练,不是跨平台零样本迁移。
- 论文的 AI 使用声明写明,生成式 AI 工具参与了代码实现、写作编辑和投稿前对方法与实验报告的反馈;作者表示对最终内容负责。


