この回の動画
ナレーションは AI 合成音声です。 動画の章・文字起こし・出典
文字起こし
文字起こし
知行の問い
ロボットにコップをつかませたいなら、まずお手本を何度も見せなきゃ。そのお手本、誰がやるの?今回は、ロボットの動作データの、三つの入手ルートを整理します。遠隔操作、人の映像、そして合成。それぞれに代償があります。
遠隔操作
いちばん直接的なのは、人が手本を示すやり方です。人がロボットの代わりに一度やってみせ、その動作をそのまま記録します。よくあるのは、操作する側と、まねする側、二本のアームを使う方法です。人が操作用のアームを動かすと、ロボットのアームがその通りについてきます。人の技は、こうして伝わります。例として、ある小型アームのデータセットを見てみましょう。物を持ち上げて置く作業です。お手本は五十本、それぞれカメラ二台。毎秒三十フレームで、関節六か所の角度も記録しています。カメラは二台。一台は真下を、もう一台は横から見ています。関節六か所の角度が、そのまま動作ラベルです。映像を見れば、何を学んでいるのかが分かります。ブロックをつかむ瞬間までめくると、グリッパーがゆっくり閉じ、六本の曲線がいっせいに動きます。これが、きれいにつかんだ一回分の姿です。このやり方はいちばん確実で、動作もきれいです。でも、遅くて高い。一本一本、すべて人が記録しなければなりません。どうするか?ある論文が、みんなのデータを一つにまとめました。二十一の機関、二十二種類のロボット、五百種類以上のスキルです。一つずつ集めてたら遅すぎる。みんなで持ち寄って、やっと足りるんだ!
人の映像
もっと安上がりな方法もあります。ロボットを使わず、人の作業を直接見るのです。人がカメラを身につけ、いちにんしょう視点の映像を撮ります。なぜ人に注目するのか?人は毎日働いているからです。こうした映像は、ほとんど無尽蔵にあります。どれくらいの量になるのか?二千二十六年のはじめ、ある論文が、こうした映像を二万時間以上使い、ロボットを事前学習しました。同じ論文は、もう一つ発見しました。人の映像を多く与えるほど、モデルはよく学ぶ。ほとんど法則のようです。ただ、生の映像だけでは足りません。まず動作のラベルを付けないと、モデルは学べません。この作業自体に、手間がかかります。もう一つ壁があります。人の手は、ロボットの手ではありません。映像には、正確な関節角も、力もありません。人の作業を見て学べるけど、まず人の手を、ロボットの手に翻訳しなきゃ!
合成
三つ目は、シミュレーションの中でデータをつくる道です。前回のシミュレーターを覚えていますか?自動で演じさせれば、たくさん演じてくれます。どうつくるのか?まず、人がお手本をいくつか示します。するとシステムが、それを新しい場面、新しい位置へ、自動で移し替えます。利点は、バリエーションの多さです。位置を変えても、物を変えても、自動で生成できます。人が一本ずつ撮っていては、とても追いつきません。では、どれだけ節約できるのか?研究者はあるシステムで、約二百本の人のお手本から、五万本以上を生成しました。十八のタスクにわたります。節約は本物です。でも、どれだけ合成しても、一つの問題からは逃れられません。それは本当に、本物らしいのか?三つの道は分かった。でも、データって多ければ多いほどいいの?答えは、そうとは限りません。データは多いだけでなく、多様で、いろいろな状況を網羅している必要があります。量を積むだけでは、効果は頭打ちになります。三つの道を並べてみましょう。遠隔操作はいちばん正確、人の映像はいちばん多い、合成はいちばん柔軟。一つだけで全部をまかなえる道はありません。三つの道は、実際にはよく組み合わせて使われます。どう配分するか、どう品質を保つか。これはまだ結論が出ていません。画面では、お手本を一コマずつめくっていきます。カメラ二台と、六つの関節の曲線が、いっしょに進みます。どこでずれたか、すぐに分かります。ふりかえりです。ポイントは三つ。一つ、遠隔操作はいちばん直接的で、動作もきれい。でも遅くて高い。二つ、人の映像は量が多い。でも人の手はロボットの手ではない。三つ、合成でデータを増やせる。でも、本物らしさが崩れないよう気をつけましょう。つまりデータは空から降ってこない。人が一本ずつ示して、機械が増やしてくれるんだ!データはそろった。じゃあロボットは、お手本からどうやって動作を覚えるの?また次回!
根拠と出典
22種類 · のロボットのデータを一つのデータセットに(21機関、527スキル) [R] · arXiv 2310.08864 · Open X-Embodiment
20,854時間 · 動作ラベル付きの一人称視点の人の映像で、ロボットを事前学習(論文によれば従来の20倍以上、休まず約2.4年分) [R] · arXiv 2602.16710 · EgoScale
5万本以上 · 約200本の人のお手本から自動生成したお手本の数(18タスク、シミュレーション内、論文) [R] · arXiv 2310.17596 · MimicGen(CoRL 2023)
練習とセルフチェック
小テストは公開で、回答するとすぐ解説が出ます。読み物の練習問題の答えはログイン会員向けです。
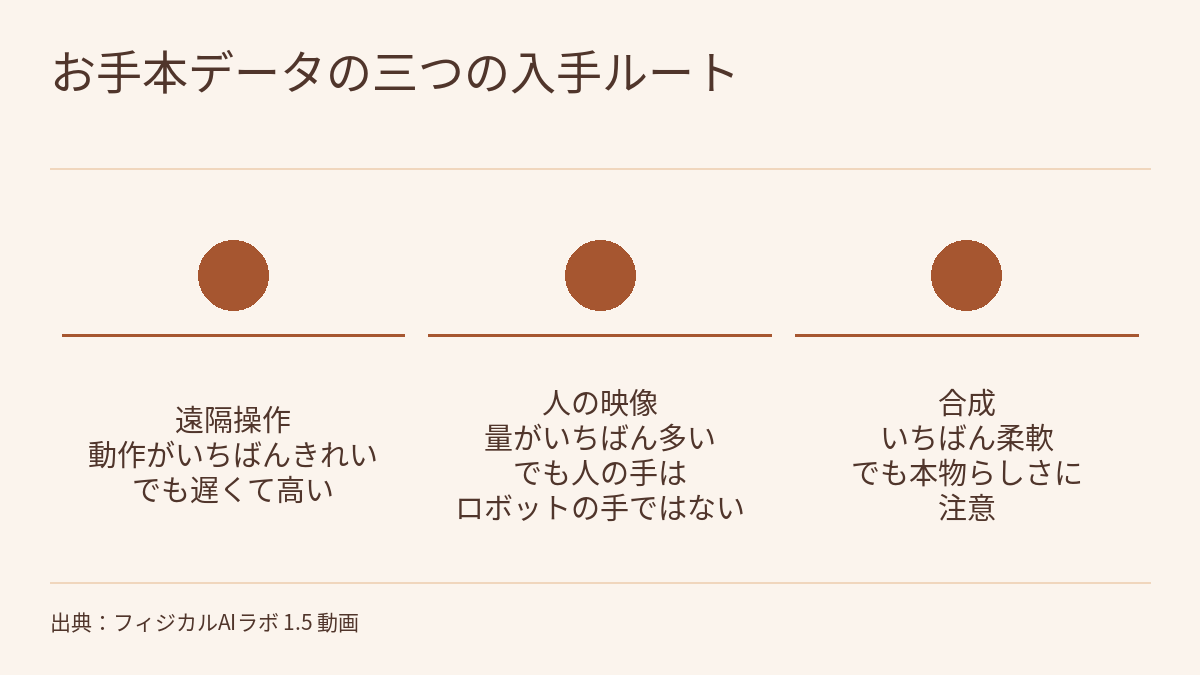
第 1.5 回の動画は、ロボットの動作データの三つの入手ルートを取り上げます。遠隔操作は動作がいちばんきれいですが、遅くて高くつきます。人の映像は量がはるかに多いものの、人の手はロボットの手ではなく、ラベル付けと対応付けが必要です。合成は少数の本物のお手本を大量に増やせますが、本物らしさが崩れないよう注意が要ります。動画が引く証拠は四つです。SO-101 のピック・アンド・プレースのデータセットはお手本 50 本で、それぞれカメラ 2 台、毎秒 30 フレーム。Open X-Embodiment は 22 種類のロボットのデータを一つのデータセットにまとめました。EgoScale は 20,854 時間以上の一人称視点の人の映像を使いました。MimicGen は約 200 本の人のお手本から 5 万本以上を生成しました。このページはこの回の解説と練習です。文字起こしを繰り返すのではなく、まず SO-101 データセットのメタデータファイルを開き、50 本の合計時間と、各フレームにどの数値が保存されているかを求めます。次に、三つのルートのデータをそのまま一つの学習セットに流し込めない理由を見ます。単位、動作空間、「お手本 1 本」の意味がそれぞれ違うからです。最後に架空の数値を使い、「何本生成したか」と「何通りの状況をカバーしたか」を区別します。全体を通じたルールは一つです。数字は、それ自身のデータセットだけを、それ自身の単位で表します。
この回の動画、文字起こし、出典はこのページの上部にあり、シーズン全体の構成は講座の概要にあります。前回のフィジカルAIラボ 1.4:シミュレータの地図――刻み幅のコストを数え、接触で軌道が分かれる点を読み、3 つの高速化の比較対象を確かめるは、練習に使う動作データはそもそもどこから来るのか、という問いで終わりました。今回はその続きです。Open X-Embodiment と EgoScale の規模の数字はフィジカルAIラボ 0.2:なぜ今なのか、データ・モデル・計算資源の 3 本の曲線で扱ったので、ここでは繰り返さず、この回に関わる 2 点だけを補います。複数ロボットのデータの動作空間をどう揃えるのか、そして EgoScale のスケーリング関係がどの量についてのものか、です。
公開小テストの 5 問には詳しい解説が付いています。ログインすると、三つの練習に取り組めます。架空のデータセットのメタデータを読んで時間を求め、エピソード単位で学習用とテスト用に分ける。4 種類のデータを混ぜる架空の計画を項目ごとに帳簿にまとめ、次元数が同じでも意味が違う動作空間を見つける。この回の四つの証拠を引用した架空のメモを審査し、一文ずつ書き直す。いずれも段階的な解答例、よくある誤り、20 点満点の採点基準付きです。
1. 四つの証拠は、それぞれ何を数えているか
動画の四つの数字は四つの資料から来ており、数える対象も単位も違います。
| 動画での言い方 | 出典 | 何を数えているか | 単位 | レベル |
|---|---|---|---|---|
| 50 本、カメラ 2 台、毎秒 30 フレーム | LeRobot の svla_so101_pickplace データセットのメタデータ(固定コミット f641879) | 一つのピック・アンド・プレース作業のお手本エピソード(動画では遠隔操作とされていますが、メタデータには収録方法の記録がありません) | 本(エピソード)、フレーム/秒 | O(データセットのメタデータ) |
| 22 種類のロボット、21 機関、527 スキル | Open X-Embodiment(arXiv 2310.08864) | 一つのデータセットにまとめたロボットの身体、協力機関、スキル | 種類、機関 | R(著者の報告) |
| 20,854 時間以上 | EgoScale(arXiv 2602.16710) | 動作ラベル付きの一人称視点の人の映像 | 時間 | R(著者の報告) |
| 約 200 本から 5 万本以上を生成 | MimicGen(arXiv 2310.17596) | 人のお手本と、自動生成したお手本 | 本、18 タスクにわたる | R(著者の報告) |
三本の論文の該当する原文は次のとおりです。それぞれ独立に抜粋しています。
We assemble a dataset from 22 different robots collected through a collaboration between 21 institutions, demonstrating 527 skills ( 160266 tasks).
We train a Vision Language Action (VLA) model on over 20,854 hours of action labeled egocentric human video, more than 20 times larger than prior efforts, and uncover a log linear scaling law between human data scale and validation loss.
We use MimicGen to generate over 50K demonstrations across 18 tasks with diverse scene configurations, object instances, and robot arms from just ~200 human demonstrations.
この表を読むときの注意点は三つです。
- 単位が違えば大小は比べられません。エピソード(本)、時間、種類、生成したお手本(本)は四つの別々の数え方です。50 本のロボットのお手本と 20,854 時間の人の映像を割り算しても「何倍か」は出ません。前者は各フレームに関節の値を保存していますが、後者には、動画の説明どおり、正確な関節角も力もありません。
- 「22 種類」はロボットの身体の種類で、お手本の本数ではありません。Open X-Embodiment の論文は第 III 節で別に、データセットには 100 万本以上(1M+)の実機ロボットの軌道が含まれ、世界の 34 のロボット研究室による既存の 60 データセットをまとめたものだと書いています。21 機関と 34 研究室も別の数え方なので、混同しないでください。
- 5 万本以上は生成されたもので、人のお手本は約 200 本です。動画の数字カードは、MimicGen の結果をシミュレーション内・論文の報告と表示しています。生成したお手本と人が記録したお手本は同じ種類の「本」ではありません。第 4 節でもう一度計算します。
ログインすると、このレッスンの続きと確認問題、解答を読めます。
制約と注意点
- Open X-Embodiment(arXiv 2310.08864、2023-10-13)、MimicGen(arXiv 2310.17596、2023-10-26、CoRL 2023)、EgoScale(arXiv 2602.16710、2026-02-18)の数字はいずれも著者の報告で、R レベルです。EgoScale はプレプリントです。本サイトはどれも独自に再現していません。本課が依拠したのは Open X-Embodiment の要旨と本文の冒頭の節(第 IV 節の抜粋は roll のあとで途切れています)、MimicGen と EgoScale の要旨で、補足資料は含みません。
- SO-101 の値は、svla_so101_pickplace データセットの固定コミット f641879 の
meta/info.jsonによるもので、O レベルです。本課が読んだのはこのメタデータファイルだけで、データファイルや動画はダウンロードも確認もしていません。メタデータが記すのはフィールドと数で、お手本の質、成功したかどうか、記録の方法、収集のコストは記していません。 - 238.78 フレーム、7.96 秒、397.97 秒、23,878 枚、307,200 画素、71,634 個、約 250 倍は、本課が示された数字をもとに行った計算で、出典に直接書かれた数ではありません。対数線形の関係の a と b は本課が説明のために置いた記号で、200、2,000、20,000 時間は例示であり、EgoScale のデータ点ではありません。
- 第 4 節のチーム T、コップ C1〜C4、案 G1・G2、第 5 節の cup_place_demo、チーム K、ロボットアーム K1、データ S1〜S4、メモ M1〜M4 は練習用の架空の設定で、どのデータセット、チーム、システムのデータでもありません。要因ごとの取り分け、エピソード単位の分割、「帳簿をつける」ことは教材としての提案で、どの出典の結論でもありません。紙の上の計算もシミュレーションの結果も、ハードウェアの安全性の検証ではありません。
- 本記事は、動画の実験ページ(SO-101 のお手本を一コマずつ見るページ)の実装を確認していません。
リンク
- フィジカルAIラボ:すべての数字を確認できるフィジカルAI講座(講座の概要)
- フィジカルAIラボ 1.4:シミュレータの地図――刻み幅のコストを数え、接触で軌道が分かれる点を読み、3 つの高速化の比較対象を確かめる
- フィジカルAIラボ 1.1:座標系と運動学――2 リンクのアームがコップに届く計算を手で追う
- フィジカルAIラボ 0.2:なぜ今なのか、データ・モデル・計算資源の 3 本の曲線
- Hugging Face:lerobot/svla_so101_pickplace データセット
- svla_so101_pickplace の meta/info.json(固定コミット f641879)
- Open X-Embodiment: Robotic Learning Datasets and RT-X Models(arXiv 2310.08864)
- EgoScale(arXiv 2602.16710)
- MimicGen(arXiv 2310.17596、CoRL 2023)