
人の手のお手本から器用なロボットハンドを学習させるには、手が実空間のどこにあるかを知る必要があります。単位はメートルで、頭の動きに左右されないワールド座標系での位置です。単眼動画では奥行きと絶対スケールが定まらず、光学モーションキャプチャやデータグローブは実験室か手に着ける機器を前提とします。arXiv 2611.21143(2026-11-16、香港城市大学と CyberOrigin)が提案する WinDEX は、頭部装着の魚眼ステレオカメラと IMU で日常の操作を記録し、幾何最適化でメートル単位の 3D 手部アノテーションを作り、それを使ってエンドツーエンドのネットワークを学習します。さらにオフライン用とリアルタイム用の 2 つのモデルに蒸留し、強化学習と遠隔操作にそれぞれ使います。著者報告では、ワールド座標の関節誤差 W-MPJPE は 37.29 mm で、微調整した HaWoR は 97.65 mm です。オフラインモデルは 43.61 FPS、ストリーミングモデルは 171 FPS です。WinDEX の軌道を参照にして学習した強化学習方策は、シミュレーションでのつかみ・持ち上げ・置きの平均成功率が 61% で、WiLoR と HaWoR の軌道を参照にした場合は 8% と 17% でした。以下の数値はすべて著者報告 [R] です。本サイトはコードを実行しておらず、独立した再現もしていません。本サイトが読んだ論文本文は第 VII-C 節の途中で終わっています。
メートル単位とワールド座標が必要な理由
論文は片手の状態を 2 つに分けて表します。MANO の姿勢パラメータ θ と、参照カメラ座標系でのメートル単位の手首並進 w です。1 本の録画の中では、各手が 1 つの形状ベクトル β を共有します。そのうえで、視覚慣性 SLAM が推定したカメラ姿勢を使い、カメラ座標系の手を重力方向にそろえたワールド座標系へ移します。頭部装着カメラはそれ自体が動くので、カメラ座標系のままの手の軌道には頭の動きが混ざります。座標系どうしの換算の考え方は フィジカルAIラボ 1.1 で扱っています。
記録装置 CyberCap は頭部装着の魚眼ステレオ RGB カメラです。基線長 60.7 mm、ハードウェア同期で、片目あたり 1920 × 1200 画素、30 fps で撮影します。剛に取り付けた IMU は同じクロックで 300 Hz で記録します。手には何も着けず、外部カメラやマーカーも不要です。基線長が既知なので、ステレオ三角測量で絶対的な奥行きを拘束できます。単眼手法に欠けているのはこの点です。論文は CyberCap を低コストとしていますが、本サイトが読んだ本文に価格は書かれていません。
フィジカルAIラボ 1.5 では、人の動画は量が多いものの、人の手はロボットの手ではないので、まずアノテーションと対応付けが必要だと説明しました。WinDEX が扱うのは、そのアノテーションの幾何的な精度です。論文の表 I は、いくつかの一人称視点データセットについてスケールの出どころと検証方法を比べています。「精度を検証したか」の列では、Ego4D、EgoDex、EgoScale(野外サブセット)がいずれも「報告なし」です。これは WinDEX の著者による整理です。1.5 では EgoScale のデータ規模を引用しましたが、本サイトはこの項目を EgoScale の原論文で確認していません。
アノテーション:人が確認した 2D キーポイント、幾何的な 3D フィッティング、15 画素での選別
- 魚眼の周辺部:手は魚眼画像の端に写ることがよくあります。著者は各フレームから 5 つの仮想ピンホール画像(画像中心と 4 つの象限中心)を描画し、YOLO11-pose と ViTPose でキーポイントを検出して関節ごとに統合します。信頼度が 0.3 未満の候補は捨てます。その後、人が確認して信頼できる 2D キーポイントを選びます。
- 初期化とフィッティング:WiLoR が姿勢と形状の初期値を、ステレオ三角測量が手首の奥行きを与えます。第 1 段階はフレームごとのフィッティングで、形状は信頼度が最も高い 64 フレームを個別にフィットした結果の平均です。第 2 段階は時間方向の最適化で、滑らかな動き、遮蔽、速い動きの 3 モードに応じて時間方向の拘束の強さを変えます。遮蔽中は最後の高信頼度の姿勢を保持します。著者はこれで不安定なフィッティングを避けられる一方、見えていない指の姿勢は復元できないと明記しています。
- 選別:フィットした 3D の手を画像に投影し直し、人が採用した 2D キーポイントと比べます。平均誤差が 15 画素以下のフレームだけを残します。
- ワールド座標:cuVSLAM がステレオと慣性データを組み合わせてカメラ軌道を推定します。光学モーションキャプチャと比べると、カメラ軌道の絶対軌道誤差の RMS は 0.150 m、向きの誤差の RMS は 11.69° です。
光学モーションキャプチャの真値と比べると、残ったアノテーションの両手での平均誤差は、手首位置 9.6 mm、MPJPE 10.1 mm、PA-MPJPE 6.1 mm です。野外のアノテーション(最適化のみで得たものと、モデルの初期値から最適化したものの両方)をまとめると、画像観測に対する平均再投影誤差は 7.9 画素です。
データとモデルのフライホイールは、最適化だけでアノテーションした 20 時間から始まります。WinDEX-Net が未ラベルの録画に初期値を出し、人が独立に検出された 2D キーポイントを確認し、上の手順で精緻化して同じ 15 画素のしきい値で選別し、通ったサンプルを次の学習ラウンドに加えます。著者は関連研究の節で、この種の方法には予測誤差がラウンドをまたいで伝わる危険があると書いています。対策は 3 つです。しきい値を全ラウンドで固定すること、姿勢事前分布をこのデータセットの外で学習すること、学習に一切使わない光学モーションキャプチャのセットで各ラウンドを監査し、監査誤差が改善しなくなったら止めることです。本サイトが読んだ本文には、反復回数は書かれていません。
こうして得た WinDEX-Hand の学習セットは、野外の疑似真値アノテーション 1,000 時間で、200 人以上の操作者、1,000 以上の場面、5,000 種類以上の近距離タスクから集めたものです。O*NET の職業・作業活動の情報を参考に、13 の場面カテゴリに整理しています。評価には学習に使わない 2 つのセットを用います。別途収集して人がアノテーションした 20 時間の野外セットは 2D ラベルのみで、3D の真値はありません。光学モーションキャプチャのセットは 10 人のボランティアが 38 種類のタスクを行った 20 時間分で、キャプチャ空間の中に 6 種類の日常の場面を再現して記録しました。学習セットでの手首の奥行きの中央値は 318 mm で、手のフレームの中央 80% が 215〜455 mm に入ります。手のフレームの半分は光軸から 25° 以上、10 分の 1 は 43° 以上ずれています。
1 つの教師と 2 つの生徒:精度と速度のトレードオフ
教師モデルの WinDEX-Net は、元の魚眼ステレオ画像を外部の手検出器なしで直接処理します。DINO の外観特徴と VGGT-Omega の深度ブランチの中間層特徴を組み合わせ、パッチごとの視線方向とステレオのキャリブレーションで条件付けます。局所クロップのブランチは、直前の推定から手の領域を切り出し直します。時間方向のエンコーダは SLAM のカメラ軌道で条件付けられ、頭の動きと手の動きを分けるのに使われます。論文はクロップの効果を 1 つの例で示しています。512 × 288 の全体画像では手が 12 個のパッチトークンにしかならず、224 × 224 のクロップに再サンプリングすると 196 個になります。
展開用には 2 つの生徒モデルを蒸留します。WinDEX-Window は 116M パラメータで、32 フレームを一度に処理し、前後のフレームを両方使うオフライン再構成用です。WinDEX-Stream は 8.92M パラメータで、MobileNetV3-Large のエンコーダと 2 層の因果的 GRU を使い、現在のステレオ画像対と保持した過去の状態だけから、手ごとに 21 個のメートル単位の 3D 関節を直接出力します。MANO パラメータは出力せず、リアルタイム制御用です。論文の表 III は、3 本のモーションキャプチャ録画で速度と精度を比べています(RTX 4090、FP16、バッチサイズ 1、オフラインモデルは 32 フレームの窓をストライド 16 で使用。誤差の単位は mm)。
| モデル、クロップ反復回数 | FPS | 手首誤差 | MPJPE | PA-MPJPE |
|---|---|---|---|---|
| WinDEX-Net、2 | 9.50 | 25.9 | 17.8 | 7.8 |
| WinDEX-Net、3 | 8.17 | 20.4 | 15.5 | 7.8 |
| WinDEX-Net、4 | 7.38 | 18.9 | 15.4 | 7.8 |
| WinDEX-Window、2 | 43.61 | 27.1 | 20.1 | 8.1 |
| WinDEX-Window、3 | 35.94 | 23.8 | 18.7 | 8.1 |
| WinDEX-Window、4 | 31.77 | 20.3 | 18.7 | 8.1 |
| WinDEX-Stream | 171.00 | 42.7 | 33.2 | 12.5 |
要旨にある 43.61 FPS は、クロップ反復 2 回の WinDEX-Window のオフラインのスループットです。171 FPS は WinDEX-Stream の因果的なフレームごとのスループットで、この表では 3 つの誤差がいずれも最も大きくなっています。反復回数を増やすと手首誤差は下がり、スループットも下がります。以降の再構成の比較では、著者は WinDEX-Window を反復 2 回に固定しています。
既存手法との比較:カメラ座標、ワールド座標、2D 検出
カメラ座標系(表 IV):9 つのベースラインについて、事前学習(P)と微調整(FT)の重みの結果を載せています。微調整には WinDEX-Hand の学習セットだけを使い、両方の設定で同じ入力アダプタとテスト録画を使います。単一画像の手法はキャリブレーション済みの左画像、多視点の手法はステレオを使います。UmeTrack は対応する 18 関節、ほかは 21 関節です。WinDEX-Window は P の行だけで、手首誤差 15.70 mm、MPJPE 16.68 mm、PA-MPJPE 7.82 mm、ジッター 3.15 m/s² です。各列で最も良い微調整ベースラインは、手首誤差が UmeTrack の 27.45 mm、MPJPE が HaWoR の 23.48 mm、PA-MPJPE が HaWoR の 9.45 mm、ジッターが HaWoR の 5.50 m/s² です。著者はこれをもとに、このベンチマークのカメラ座標の指標で最高性能だとしています。
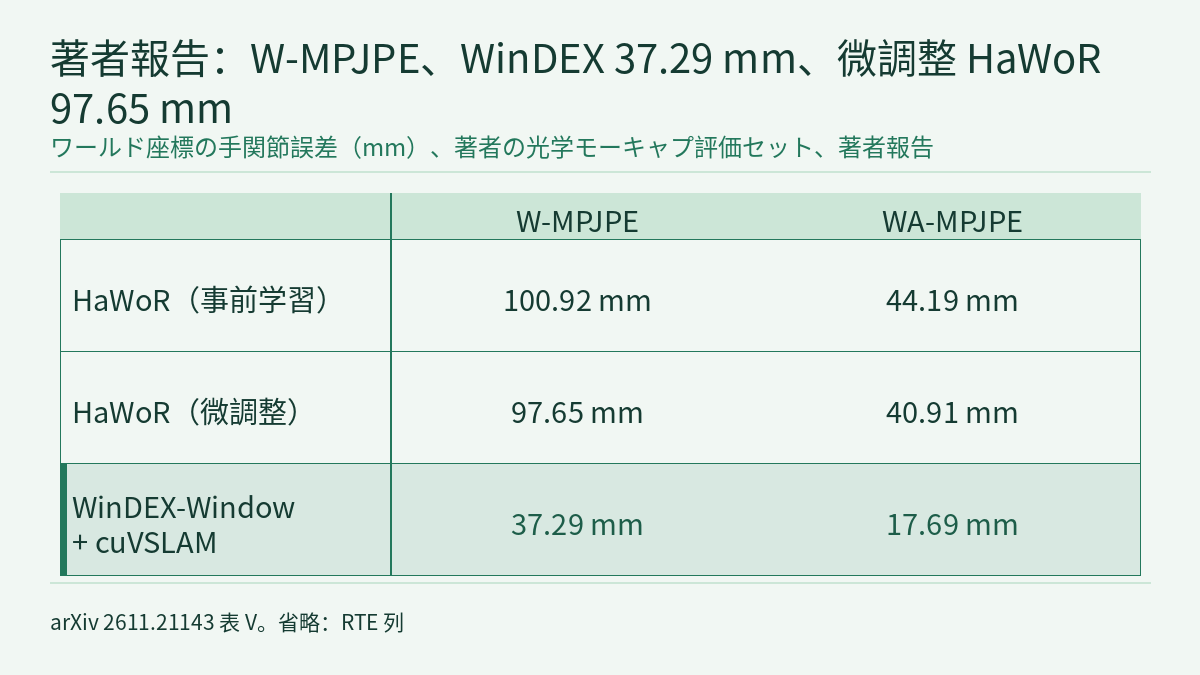
ワールド座標系(表 V):比べているのは、HaWoR の手の再構成とカメラ軌道を含む完全なパイプラインと、WinDEX-Window に cuVSLAM のカメラ姿勢を組み合わせたものです。位置誤差の単位は mm、RTE はパーセントです。
| 手法 | W-MPJPE | WA-MPJPE | RTE |
|---|---|---|---|
| HaWoR(P) | 100.92 | 44.19 | 3.10 |
| HaWoR(FT) | 97.65 | 40.91 | 2.83 |
| WinDEX-Window + cuVSLAM | 37.29 | 17.69 | 2.00 |
著者は、微調整した HaWoR に比べて 3 つの指標がそれぞれ 61.8%、56.8%、29.3% 下がったと報告しています。37.29 mm を読むには指標の定義を確認する必要があります。W-MPJPE は録画を 100 フレームずつの区間に分け、各区間の最初の 2 フレームに相似変換をフィットしてから誤差を測ります。WA-MPJPE は区間の全フレームでフィットします。RTE はスケールを含まない剛体位置合わせの後のルート軌道誤差を、真値の経路長の合計で割ったものです。CyberCap の 30 fps で数えると、1 区間は約 3.3 秒です(本サイトの換算)。したがって 37.29 mm は区間ごとに位置合わせした後の誤差で、録画全体で積み重なるドリフトではありません。カメラ軌道全体の誤差は、前の節の 0.150 m を見る必要があります。
2D:取り分けておいた人手アノテーションの野外セットで、WinDEX-Window の再投影誤差は 14.5 画素です。図 10 のベースラインの値は、本サイトが読んだ本文には含まれていません。表 VI は手のバウンディングボックス検出を比べています。WinDEX-Net の F1 は野外セットで 80.88%、モーションキャプチャのセットで 87.53% です。Sapiens2-1B はそれぞれ 79.69% と 81.39% で、野外セットの再現率は 77.43% と、WinDEX-Net の 77.09% をわずかに上回ります。
2 つの数値は表を明示して引用する必要があります。表 III では反復 2 回の WinDEX-Window の手首誤差は 27.1 mm、表 IV では同じモデルが 15.70 mm です。表 III は 3 本のモーションキャプチャ録画を使うと書いていますが、表 IV のテスト録画との関係は、本サイトが読んだ本文には書かれていません。また、表 II(WinDEX-Net が深度ブランチのどの層を取り出すかのアブレーション)の第 11 層(production)の行の 3 つの値 15.70、16.68、7.82 は、表 IV の WinDEX-Window の行と完全に一致します。読んだ本文にはその理由の説明がありません。15.70 mm を引用するときは、表 IV の値であることを明記してください。
下流の利用:Hand2Policy と Hand2Teleop
Hand2Policy は WinDEX-Window で録画済みのお手本の軌道を再構成し、クリップごとに一度だけリターゲットして、特定のロボット用の参照軌道を作ります。追従方策はこれをリプレイ、リセット、学習に使い回せます。報酬は姿勢の追従に基づきます。シミュレーションでは ManipTrans(論文の参考文献 [7])の軌道模倣器と、Inspire と Wuji の 2 種類の器用なハンドを使います。著者報告では、同じ学習設定と予算のもとで、シミュレーションでのつかみ・持ち上げ・置きの平均成功率は 61% で、WiLoR と HaWoR の動作参照で学習した場合は 8% と 17% です。要旨の 7.6 倍と 3.6 倍はこの 2 つの比です(61/8 ≈ 7.6、61/17 ≈ 3.6、本サイトの計算)。著者は方策が実機に移行できたとも書いていますが、タスク数、試行回数、実機の結果は第 VII-D 節にあり、本サイトは読んでいません。
Hand2Teleop はローカルサーバー上で WinDEX-Stream とリアルタイムの VIO を動かし、操作者の追跡には CyberCap のステレオカメラと IMU だけを使います。アームの目標は、セッションの基準点に対する手首の大域的な変位から、減衰最小二乗法の逆運動学で求めます。ハンドの目標は手首基準の指の姿勢から、dex-retargeting 系の解析的なリターゲティングで求め、実機の Wuji ハンドにはメーカーの実装を使います。フィルタリング、一時的な飛びの除去、最後に採用した目標の保持によって、信頼できない観測が指令に与える影響を抑えます。実機は 20 関節の Wuji 五指ハンドと 7 関節のロボットアームです。171 FPS はモデルのスループットで、遠隔操作のエンドツーエンドの遅延は第 VII-E 節にあり、本サイトは読んでいません。
制約と注意点
- arXiv のプレプリントで、数値はすべて著者報告 [R] です。独立した再現はありません。本サイトが読んだ論文本文は第 VII-C 節の途中で終わっています。図 10 のベースラインの値、第 VII-D 節(Hand2Policy)、第 VII-E 節(Hand2Teleop)、第 VIII 節(制約)は読んでいないため、強化学習のタスク数と試行回数、実機への移行結果、遠隔操作の遅延はわかりません。
- 評価データはすべて著者が CyberCap で収集したものです。3D の真値はモーションキャプチャ空間の中に再現した 6 種類の場面からしか得ておらず、野外の評価は 2D ラベルのみで 3D の真値はありません。ベースラインの微調整には WinDEX 自身の疑似真値の学習セットだけを使い、単一画像のベースラインには左画像だけを与えています。読んだ本文には、第三者の公開ベンチマークでの比較はありません。
- 読んだ表には、標準偏差、信頼区間、複数シードの結果がいずれもありません。
- W-MPJPE と WA-MPJPE は 100 フレームの区間ごとに位置合わせしてから計算するので、録画全体で積み重なるドリフトは測っていません。カメラ軌道そのものは、モーションキャプチャに対して RMS で 0.150 m と 11.69° の誤差があります。
- 遮蔽中、アノテーションの手順は最後の高信頼度の姿勢を保持するので、遮蔽されている間の指の姿勢は復元されません。
- 表 III と表 IV は同じ WinDEX-Window の構成について異なる手首誤差(27.1 mm と 15.70 mm)を示し、表 II の 1 行が表 IV の 1 行と完全に一致しています。読んだ本文にはどちらの説明もありません。
- 論文は CyberCap を低コストとしていますが、読んだ本文に価格はありません。著者の 1 人は CyberOrigin の所属で、CyberCap とこの会社の関係は読んだ本文には書かれていません。論文はプロジェクトサイトを挙げていますが、本サイトは開いておらず、コードやデータの公開の有無とライセンスは確認していません。


