同一个子任务 VLA,在 RoboCasa365 的原子任务上成功率 80%,把这些技能串成需要移动底座的长程任务后,智能体基线只有 19%。预印本 Cracking Mobile Manipulation(arXiv 2610.19600,2026-10-14)没有去训练更强的策略,而是先给 81 个失败回合逐一归因,找出“第一个没有被纠正、并导致任务失败的错误”,再在失败集中的三段各加一组针对性干预(共四项),底层 VLA 始终不变。作者报告,开发回合上成功率从 19.0% 升到 47.0%,固定设计后在留出种子上从 18.0% 升到 49.0%,BEHAVIOR-1K 五个任务从 14.0% 升到 37.0%,两个真机任务从 5/20 升到 13/20。这篇文章值得细读的是它的归因规则和逐项加入的实验设计:后者说明修好一段之后,失败会怎样移到下一段。以下数字均为作者报告 [R],本站未复现。
80% 与 19% 之间:怎样给一个失败回合归因
评测对象是 RoboCasa365 的 32 个组合任务中需要移动操作的 20 个,每个任务包含 2–15 个子任务,涉及在不同工作区之间搬运物体、抓放和与带关节的物体交互。基线按 Harness VLA 的分层设计改编:高层规划器选择子任务指令或工具,一个共享的子任务 VLA 同时负责导航和操作;这个 VLA 用 RoboCasa365 训练集里的原子任务示范和子任务片段训练。
每个任务跑 5 次,共 100 个回合,基线成功 19 个,剩下 81 个失败回合用于分析。归因规则有三条:
- 回看记录的动作、观测和仿真器状态,找出失败的子任务。
- 如果出错的子任务在随后三次重规划之内完成,就算作已恢复,不计入主要归因。
- 否则在剩余轨迹里找出最早一个始终没有解决、并导致任务无法完成的错误,记为时刻 t*。论文的例子是:机器人没抓起物体、此后也一直没拿起来,归因于抓取,而不是后面的放置;如果抓取后来恢复了、放置失败,才归因于放置。
离线诊断时看回放视频、规划器交互历史、机器人状态和仿真器里的物体状态。仿真器状态只用于诊断,在线运行的智能体拿不到。候选标签来自三次独立的 Codex 诊断,再由人工审核员按上面的规则核对。在随机抽取的 30 个失败回合上,三名审核员对 26 个意见完全一致,Fleiss’ κ = 0.86。
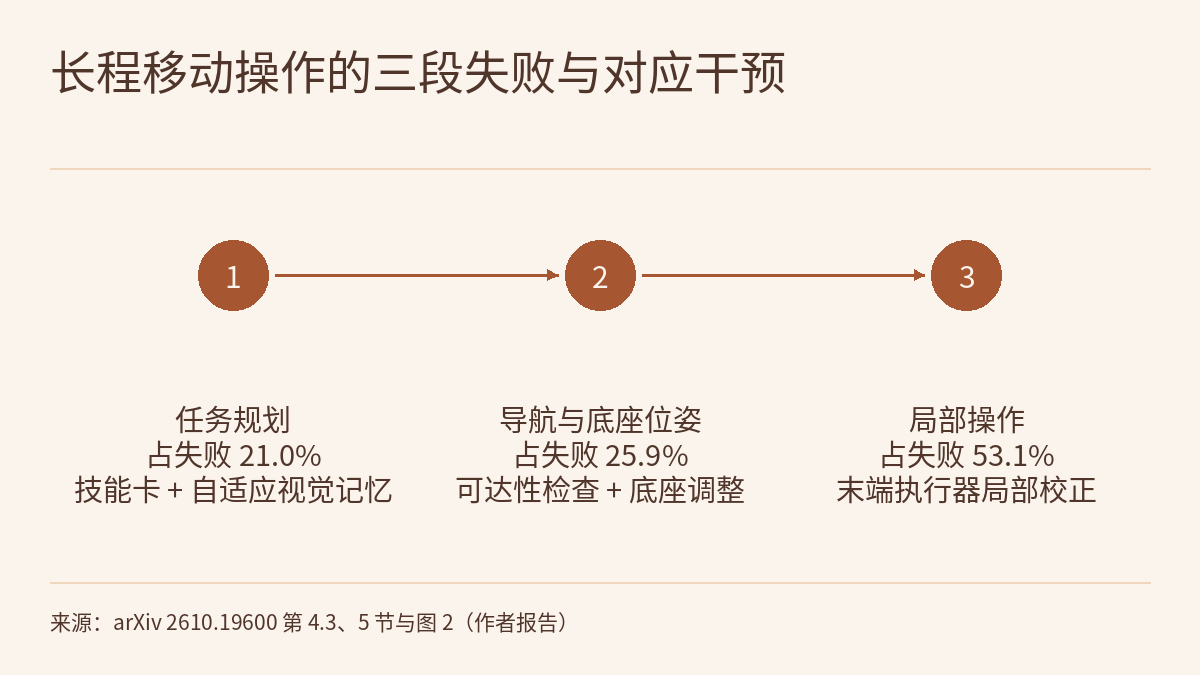
按论文图 2,81 个失败回合的主要失败分别归于任务规划 21.0%、导航与底座定位 25.9%、局部操作 53.1%。换算成回合数是 17、21、43 个,合计 81(本站换算)。作者对三类失败的描述是:
- 任务规划:所需的底层技能已经具备,但规划器对错误的目标、或在错误的阶段调用了它;早期动作改变场景后,后续决策可能已经失效,原因是任务进度没有被可靠地跟踪。
- 导航与底座定位:机器人到了正确的区域,却停在一个让下一步操作很难甚至不可行的底座位姿上。作者认为,导航是否成功不能只看有没有到达目标区域,还要看到达的位姿能否支撑接下来的交互。
- 局部操作:规划和导航都没问题,最后的交互仍因目标定位误差、抓取未对准或末端执行器定位不准而失败。
作者强调,这三类失败在执行过程中有先后:规划错误可能让机器人到不了正确的工作区,底座位姿不佳可能让正确的子任务无法执行,小的几何误差又可能毁掉最后一次交互。
四项干预,各对应一段失败
子任务 VLA 保持固定,高层智能体在所有智能体方法中都是 Kimi K3。四项干预如下:
| 失败段 | 干预 | 做法 | 论文写明的边界 |
|---|---|---|---|
| 任务规划 | 技能库(来自示范视频) | Gemini 3.5 Flash 把任务指令与对应基准训练数据里的标注匹配,检索一段示范,总结成“技能卡”:任务目标、子任务顺序、代表性关键帧和完成标准;规划器每一步同时参考技能卡和当前执行上下文(当前观测与动作历史) | 技能卡给出任务级指导,规划器仍按当前场景调整动作 |
| 任务规划 | 自适应视觉记忆 | 保存本回合的观测;规划器发出查询时,由 Qwen3.8-27B 按查询给已存观测排序,返回最相关的 16 帧和一段简短的轨迹摘要,例如“篮子最后一次出现在哪里?” | 只能取过去的观测,取不到未来帧或仿真器状态 |
| 导航与底座定位 | 可达性检查与底座调整 | 从导航切到操作前调用 check_stance:以目标名称为文本查询,用 Grounding DINO 检测、SAM 细化掩码,把掩码内有效深度像素按标定的相机参数反投影到机器人坐标系,按目标距离分为 reachable、marginal、out of reach。marginal 时调用 approach_xy,保持朝向做小幅局部平移;out of reach 时调用 goto_stance,在操作范围内选新的站位,在由当前深度观测构建的二维占据栅格上用 A* 规划路径,障碍物膨胀 0.1 m 作为安全余量,再用 PD 控制器跟随路径点 | 距离阈值从成功的训练轨迹中估计,评测前固定;检查只看目标距离,不验证关节限位、逆运动学或全身碰撞 |
| 局部操作 | 末端执行器调整 | 对每个抓取或放置子任务,用同一套 Grounding DINO 与 SAM 流程得到目标掩码,反投影为三维点,取中位数作为目标位置以减小深度离群值和缺失的影响,再从这些点估计局部表面法向,决定末端朝向;沿这个方向朝一个偏移位姿做有界校正 | 每次调用的平移量不超过 0.3 m;只改局部位姿,不改子任务 VLA |
逐项加入:失败怎样移到下一段
开发阶段,所有配置都在相同的回合种子和仿真初始状态上测试,因此每加入一项,都能与上一个配置逐回合配对比较。按论文图 4 的顺序,依次加入技能库、自适应视觉记忆、底座调整和末端执行器调整。正文给出的数字是:基线 19.0%,加入底座调整前 29.0%,加入后 40.0%,全部加入后 47.0%。也就是说,规划方面的两项合计增加 10 个百分点,底座调整 11 个,末端执行器调整 7 个(本站换算;正文没有给出只加技能库时的数字)。作者指出,底座调整是这一顺序里增幅最大的一步。
论文图 5 统计的是同一批 100 个配对回合中各类失败的数量。按作者的描述,前面针对规划的干预主要减少了目标选择和任务推进方面的失败,底座调整则明显减少了导航与底座定位失败;规划和导航的瓶颈缓解后,更多回合走到执行后段,操作成为剩下的主要失败类型。作者把这称为“移动的失败前沿”:改进一段,就会暴露流程中的下一个瓶颈。细分类别中,干预直接针对的几类明显减少:
- 放置目标或容器分配错误:9 → 0
- 接近方式无效或底座位置不佳:11 → 1
- 抓取未对准或空抓:10 → 3
剩下的失败集中在物体放错位置、搬运途中掉落,以及碰撞打乱场景。这些错误发生在执行后段,当前的几何校正还不能完全解决。
这里有一处值得留意:基线时局部操作占失败的 53.1%,比例最大,但单步增幅最大的却是底座调整。本站的读法是:每个失败回合只记一次“最早未恢复的错误”,这个比例说明的是失败最先在哪里发生,不能直接预测修好哪一段收益最大;修好前一段后,有些回合会走到后面一段再失败。论文的“失败前沿”描述与这一读法一致,但正文没有给出每一步配对的变好、变坏回合数。
留出种子、BEHAVIOR-1K 与真机
系统设计、提示词和工具参数固定之后,作者在每个任务 5 个留出种子上另做了一次评测:任务定义相同,场景布局和物体初始状态不同。表 1 中所有方法使用相同的回合种子;智能体方法额外对齐了规划器预算和重试预算,Pigey 和作者改编的 Harness VLA 使用与本文方法相同的子任务 VLA 检查点;端到端基线使用 RoboCasa365 官方仓库链接的已发布检查点和实现。
| 类型 | 方法 | 开发回合(%) | 留出种子(%) |
|---|---|---|---|
| VLA | π0 | 2.0 | 2.0 |
| VLA | π0.5 | 3.0 | 4.0 |
| VLA | GR00T N1.6 | 7.0 | 8.0 |
| VLA | GR00T N1.5 | 8.0 | 9.0 |
| VLA | RLDX-1 | 15.0 | 14.0 |
| VLA | Xiaomi Robotics 1 | 44.0 | 45.0 |
| 智能体 | CaP-X(Kimi K3) | 10.0 | 11.0 |
| 智能体 | Pigey(Kimi K3) | 13.0 | 12.0 |
| 智能体 | Harness VLA(Kimi K3) | 19.0 | 18.0 |
| 智能体 | 本文方法(Kimi K3) | 47.0 | 49.0 |
作者报告,留出种子上的提升在配对分析下统计显著(p < 0.001,见附录 E;参考文献显示附录 E 引用了 McNemar 检验和 bootstrap 方法),并据此认为提升不限于开发时用过的回合。作者对 Xiaomi Robotics 1 的表述是“性能相当”(comparable):47.0 对 44.0、49.0 对 45.0,本站所读正文没有给出两者之间的显著性检验。
迁移实验有两项。在 BEHAVIOR-1K 的五个任务上,底层策略改用 BEHAVIOR-1K 训练数据训练,干预设计不变,成功率从对应 Harness VLA 基线的 14.0% 升到 37.0%。在一台双臂移动操作机器人上的两个真机任务中,完整系统 20 次试验成功 13 次,智能体基线 5 次。任务定义和详细结果在附录 I、J,本站所读正文不含这两部分。
消融:哪些设计选择在起作用
每组消融只改一个设计,其余保持完整系统不变,全部在同样的 100 个配对回合上评测(%):
| 组件 | 变体 | 成功率 |
|---|---|---|
| 参照 | 完整系统 | 47.0 |
| 技能库 | 只用文本技能卡(VLA 训练数据) | 43.0 |
| 技能库 | 文本技能卡 + 关键帧(HIW-500) | 40.0 |
| 技能库 | 文本技能卡 + 关键帧(VLA 训练数据) | 47.0 |
| 视觉记忆 | 每轮附均匀采样历史 8 / 16 / 32 帧 | 37.0 / 40.0 / 35.0 |
| 视觉记忆 | 规划器按需查询 8 / 16 / 32 帧 | 42.0 / 47.0 / 45.0 |
| 底座调整 | 去掉可达性检查 check_stance | 36.0 |
| 底座调整 | 去掉局部底座校正 approach_xy | 42.0 |
| 底座调整 | 去掉站位重规划 goto_stance | 39.0 |
| 末端执行器调整 | 目标位置由智能体规划器给出 | 43.0 |
| 末端执行器调整 | 目标位置由几何技能给出 | 47.0 |
作者的解读:HIW-500 是用人形机器人遥操作采集的真实家庭示范,换成 RoboCasa365 训练集里的同领域示范后,成功率从 40.0% 升到 47.0%;同领域示范去掉关键帧只剩文本,降到 43.0%,说明领域对齐和视觉上下文都有贡献。按需查询在每种帧数下都高于每轮附上均匀历史,而帧数增加并不总能提升,作者认为视觉记忆的价值更多在于检索与任务相关的证据。去掉可达性检查下降最多,去掉站位重规划的影响大于去掉局部校正。末端执行器一组相差 4 个百分点,作者自己也称差距不大(modest)。
读这张表时要记住,每个百分点在这里对应 100 个回合中的 1 个,4 个百分点就是净差 4 个回合。各组消融的配对统计在附录 K.1,本站所读正文不含这部分,因此不知道这些差距里有多少回合变好、多少变坏,也不知道哪些差距在统计上可靠。
和站内已有内容的关系
物理AI实验室 1.8:评测讲过,一个“失败”标签会盖住不同的失败方式,一个净增数会把变好和变坏相互抵消。这篇论文给出了一套写明的失败标签规则:三次重规划的恢复窗口、只记最早未恢复的错误、模型给候选标签再由人核对,并报告了审核员之间的一致性。它的开发阶段评测也是 1.8 讲的配对设计:每个配置都在相同的种子和初始状态上运行。
物理AI实验室 1.1:坐标系与运动学用工作空间圆环判断手臂“够不够得着”,并说明只算位置、不加关节限位。check_stance 也是按目标距离把站位分成三档,论文明确写了它不验证关节限位、逆运动学和全身碰撞,所以这里的 reachable 是一个距离分类,不等于逆运动学一定有解。
前沿雷达|RoboAware同样在固定执行器外面做智能体层。两者的思路不同:RoboAware 用仿真里同一状态的反事实分支训练一个协调器,本文则根据人工核对的失败归因手工设计干预。两篇论文的基准、任务和协议不同,成功率不能互相比较。
局限 / 注意
- 这是 arXiv 预印本,全部数字为作者报告 [R],本站没有复现。作者在复现性声明中写明,代码、提示词、配置文件和评测回合列表将会发布;本站没有核实它们是否已经公开,文中也未链接代码仓库。
- 失败归因的候选标签来自 Codex,再由人工核对;一致性只在 30 个随机抽取的失败回合上报告(26 个完全一致,κ = 0.86)。论文声明生成式 AI 工具也参与了文献收集、部分写作和部分实验代码。
- 开发回合同时用于设计系统和报告 19.0% → 47.0% 的逐项结果;独立于设计过程的是留出种子上的 18.0% → 49.0%。两者都只覆盖 RoboCasa365 的 20 个移动操作任务,每个任务 5 个回合。
- BEHAVIOR-1K 只有五个任务,真机只有两个任务、共 20 次试验;任务定义、每个任务的试验分配和实验条件在附录 I、J,本站所读正文不含。仿真结果不是硬件安全验证。
check_stance只看目标距离,不验证关节限位、逆运动学或全身碰撞;站位重规划的 0.1 m 障碍物膨胀是论文设定的余量,不是安全保证。按作者的分析,搬运中掉落、碰撞打乱场景等后段失败仍未被当前的几何校正完全解决。- 系统依赖多个外部模型:Kimi K3 作为高层智能体,Gemini 3.5 Flash 生成技能卡,Qwen3.8-27B 给视觉记忆排序,Grounding DINO 与 SAM 做目标分割;本站所读正文没有给出这些调用的延迟或成本。各组消融和留出评测的配对统计在附录 E、K.1,本站所读正文不含。