pai-design-workbench 用一个小评测度量模型的物理估算:给出一个支架和一个已测的参考点,让模型说出电机轴处挠度随板厚、宽度、高度怎样按幂律变化,再拿这组指数去和留出的求解器结果比较。仓库在 commit 70330e2 保存了一次真实模型的评测记录:中位误差 0.114、最差 0.321、Spearman 0.95,三项都过了门槛,但高度指数的符号与实测相反。本文讲这个评测怎样把模型输出限制成数据而不是代码,怎样读这几个数字和基线,以及为什么“通过”之后求解器仍然是最终依据。
下文依据固定在 commit 70330e2 的三个文件:评测记录 docs/evidence/physics-eval.json、评测脚本 scripts/eval-physics-solver.ts 和需求表 docs/REQUIREMENTS.md([O],项目自述)。记录对应的是一次已保存的开发评测,本站没有运行脚本、调用模型,也没有复现其中任何数字。同一仓库把 CFD 算例搬上 AWS Batch 的做法,见本站的 把固定版本的 OpenFOAM 算例搬上 AWS Batch:哈希回传、两套网格与本地阻力对照;本文讨论的是另一件事:模型的估算与求解器结果之间的差距。
评测问的是什么:一个参考点加三个指数
脚本给模型的提示要求它以机械工程师的身份,预测这个支架在电机轴处的挠度怎样随参数缩放,并只返回一个 JSON 对象:
{"thicknessExponent": a, "widthExponent": b, "heightExponent": c, "rationale": "<= 600 chars"}三个指数的含义写在提示里:deflection = d_ref * (t/t_ref)^a * (W/W_ref)^b * (H/H_ref)^c,其中 d_ref 是已测的参考挠度,t、W、H 分别是板厚、宽度和板高。提示要求模型从板的弯曲、侧边的加强筋和载荷进入的位置去推理,并把指数限制在 [-6, 6]。模型能看到的材料是任务工作区里的 README.md(支架说明)和 reference.json(参考点),二者被原样夹在提示中。
记录里的任务名是 agentforge examples/pai-workbench/eval/tasks/estimate-bracket-deflection,注明在 9594430 合入。需求表 F17 把这项列为“用 eval/ 度量模型的物理估算”。
模型只给数字,不给代码
这个评测的关键设计是:模型的输出始终是数据。记录里的路径写作“scripts/eval-physics-solver.ts → NoteFlow bounded executor(shared ledger,1 attempt,no retry);模型以 JSON 返回指数,不执行任何代码”。脚本里对应的做法如下:
- 经受控执行器调用模型,只取第一个已启用的引擎配置(
enabledProfiles(config).slice(0, 1)),超时 60 秒。需求表 F3 写明真实模型调用有主、备用、二备三级;这里只用第一级,所以评测结果只对应这一个配置。 - 执行器没有返回
done或没有回答时,脚本直接抛错,不重试。 - 从回答的第一个
{截到最后一个},用 zod 校验:三个指数必须是 [-6, 6] 内的数字,rationale是字符串。提示要求理由不超过 600 字符,校验允许到 2000 字符。 - 脚本把三个数字填进一段固定模板,写出
estimate.mjs:读取reference.json,按上面的幂律公式返回估算值。模型写的任何文字都不会成为可执行代码。 - 另写一份记录到状态目录下的
eval/<id>.json,内容是引擎信息、三个指数和每次尝试的配置与状态。
脚本注释给出的运行方式是在任务工作区里由基础评测框架调用:
node examples/pai-workbench/eval/run.mjs --command "node --env-file=<wb>/.state/demo.env --import tsx <wb>/scripts/eval-physics-solver.ts"这里的 <wb> 是 workbench 检出的位置。run.mjs 不在本文依据的文件之内:它怎样读取留出数据、怎样算出三项指标,本文无从核对;脚本本身只产出 estimate.mjs 和上述记录。这条命令还需要 AgentForge 的任务目录和一个可用的模型配置,所给材料没有写明这些依赖的版本或安装步骤,因此固定 workbench 的提交并不能固定整个运行环境。
保存的结果:三项指标与三条基线
记录检查时间为 2026-10-03T17:35:00Z,引擎为 provider kiro、engineVersion 2.27.1、model claude-opus-5.5。modelEvidence 字段是 acp_advertised,即模型名来自引擎经 ACP 自报的身份,不是独立核实的模型来源。模型给出的指数是 t:-2.6、W:+1.2、H:+0.8。
| 指标 | 模型 | 阈值 |
|---|---|---|
| 中位误差(median) | 0.114 | 0.15 |
| 最差误差(worst) | 0.321 | 0.35 |
| 秩相关(Spearman) | 0.95 | 0.9 |
| 结论(passed) | true | — |
记录只列出阈值数值,没有写比较方向;需求表 F17 把同一结果写作“中位误差 11.4 %、最差 32.1 %、Spearman 0.95,通过”。按误差越小越好、秩相关越高越好来读,三项都在阈值内。Spearman 只看估算值与实测值的排序是否一致,不看数值差多少。
记录还列了三条基线,它们的性质各不相同:
| 基线 | t | W | H | 记录中的结果 | 怎么看 |
|---|---|---|---|---|---|
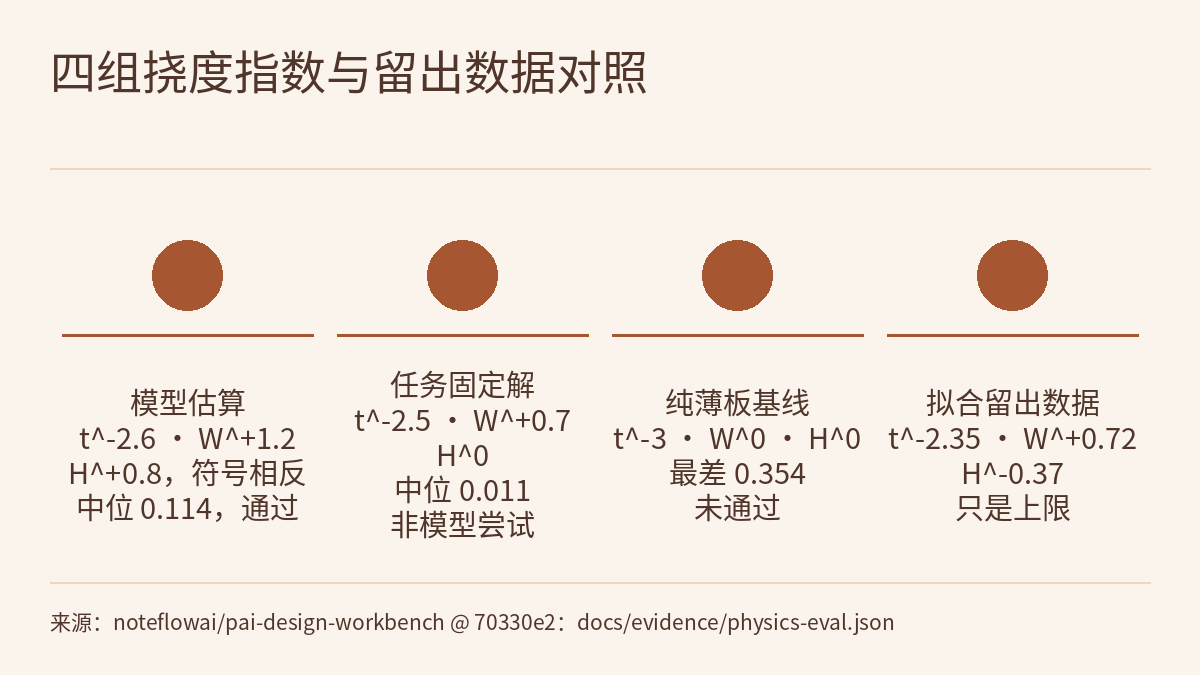
| fixtureSolution | -2.5 | 0.7 | 0 | 中位 0.011,最差 0.192,Spearman 1.0 | 任务自带的固定解,不是一次新的模型尝试 |
| pureThinPlate | -3 | 0 | 0 | 中位 0.145,最差 0.354,未通过 | 只按薄板刚度随 t³ 变化来估;中位在 0.15 以内,最差超过 0.35 |
| leastSquaresOnHeldOut | -2.35 | 0.72 | -0.37 | 未给出分数 | 直接拟合留出数据本身:是上限,不是公平的对手 |
纯薄板基线说明了门槛的作用:只凭“板刚度与 t³ 成正比”这一条教科书关系,中位误差已经接近阈值,但最差点超出,没有通过。最小二乘一行用的是评测要预测的答案,记录明确注明它只是上限;它的指数可以当作留出数据所呈现趋势的概括,但不能拿来和模型比分数。
通过门槛,不等于每个趋势都对
记录自己的解读是:模型把厚度和宽度的趋势方向判对了(t^-2.6;W^+1.2,比实测拟合的 +0.72 大),高度趋势的符号却判反了(+0.8,实测拟合为 -0.37)——在这里,更高的板配上更深的加强筋,轴处反而更刚。记录的结论是:“它过了门槛,求解器仍然说了算。”
模型的理由(rationale)提到 50 mm 杠杆把 60 N 变成面上约 3 N·m 的力矩、固定的 31 mm 螺栓孔距、板刚度 D 与 t³ 成正比等。这些是模型对支架的推理,本文没有核对其中的数字;记录也只评价了指数,没有评价理由是否正确。解释与可核对的结果要分开看,这一点与本站 对照原始机器人录像核对模型解释:Robot Reel 的 review-claims 能证明什么 中把解释标为 not_assessed 的做法相通。
下面用指数做一个手算,帮助看清高度符号的影响。这是本站按公式做的假设性计算,不是测量结果:每次只把一个参数放大到参考值的 1.2 倍,其余不变;记录没有给出留出点的参数范围,1.2 倍不一定落在其中。
| 只把这一项放大 1.2 倍 | 模型指数给出的挠度变化 | 留出数据拟合指数给出的变化 |
|---|---|---|
| 板厚 t | 1.2^-2.6 ≈ 0.62,约 -38 % | 1.2^-2.35 ≈ 0.65,约 -35 % |
| 宽度 W | 1.2^1.2 ≈ 1.24,约 +24 % | 1.2^0.72 ≈ 1.14,约 +14 % |
| 板高 H | 1.2^0.8 ≈ 1.16,约 +16 % | 1.2^-0.37 ≈ 0.93,约 -7 % |
厚度一行两者接近,宽度一行方向相同、幅度不同,高度一行方向相反。如果只看三项汇总指标,这个反向趋势不会显出来;记录没有给出逐点误差,本文也不推断汇总指标为什么没有被它拉过阈值。用这样的估算去挑设计方向时,例如想靠加高板来降低挠度,模型会给出错误的建议。这与需求表 F7 的流程一致:AI 只给出带估算的种子,最后由求解器实测与正式复核决定。
把答案留在智能体够不到的地方
评测的价值取决于被评测的一方拿不到答案。所给材料能说明的部分如下:
- 提示里只有支架说明和一个参考点,留出的求解器结果不在提示中。
- 脚本为这次调用在状态目录下新建一个权限为
0o700的eval/<id>目录并交给执行器,而不是传入任务工作区。所给材料没有说明引擎在执行期间能否读取其他文件。 - 模型的输出只是三个有界数字和一段理由;可执行的
estimate.mjs由脚本按模板生成。 - 脚本本身不计算分数;按注释,它由基础评测框架在任务工作区里调用。
据此,本站的建议是(这是编辑建议,不是项目文档的规定):把留出数据和打分代码放在智能体工作区与可读路径之外,由独立的框架读取;让智能体只交回有界、可校验的数据,由受信的模板生成要执行的东西;每次只给一次尝试,并保留每次尝试的状态,包括失败。最小二乘那一行提醒的也是同一件事:一旦估算方能看到留出数据,它的“分数”就只是拟合度,不再说明推理能力。
局限 / 注意
- 这是一次保存的开发评测,只有一次尝试;本站没有重跑,也没有独立复现。不同时间、不同引擎版本或同一模型的另一次回答,结果可能不同。
- 模型名来自引擎的自报(
acp_advertised),不是独立的模型来源证明。 - 评分代码
run.mjs、留出数据及其点数、各参数的取值范围和误差的确切定义都不在本文依据的文件中;本文对阈值方向的读法基于需求表的表述。 - fixtureSolution 是任务的固定解,不是新的模型尝试;leastSquaresOnHeldOut 拟合的是留出数据本身,只是上限。
- 通过这项评测,不说明模型具备一般的物理理解,不说明它能可靠外推,也不涉及实物安全。需求表把“把仿真当作物理验证”列为范围外。记录把留出数据称作“实测”(measured),但所给材料没有写明这些数据由哪个求解器、什么设置得出;本文没有把它当作实物测量的证据。
- 执行器的“shared ledger”在所给材料中只有这个名字,没有说明其内容,本文不作推测。