
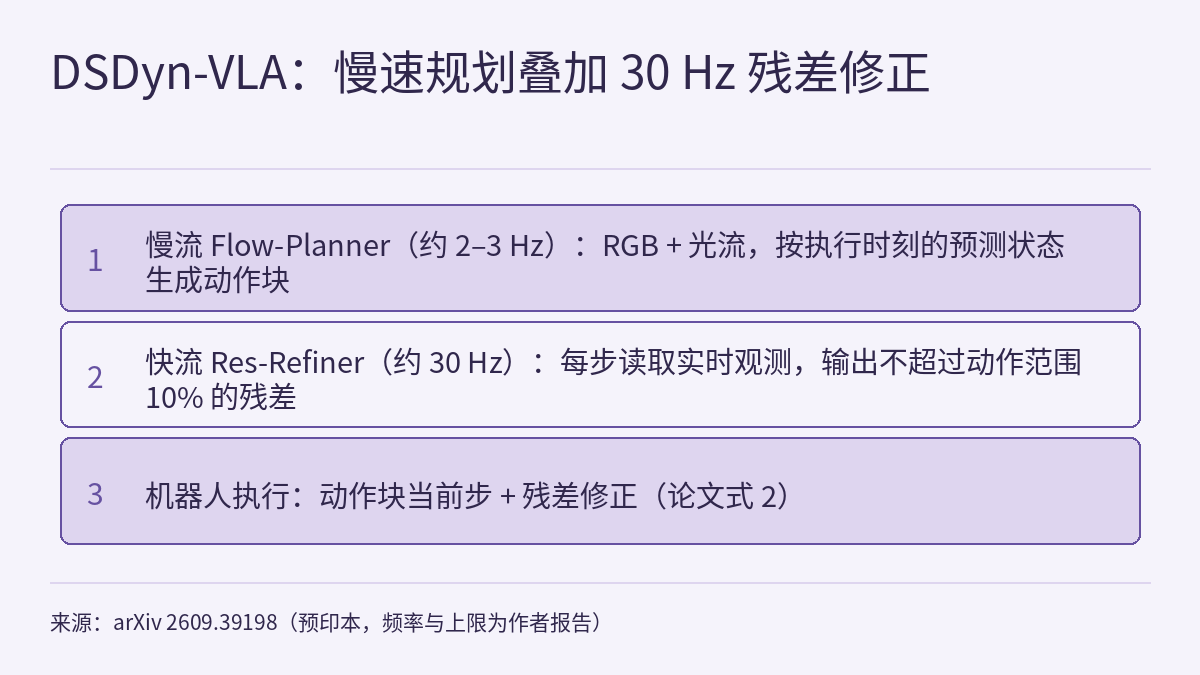
传送带上的方块、移动中的杯子:目标一动,擅长静态任务的 VLA 就容易扑空。悉尼大学、中南大学、UC San Diego 与 Ace Robotics 的预印本 DSDyn-VLA(arXiv 2609.39198,2026-09-30,证据等级 [R])把原因拆成感知、延迟、控制三个缺口,用一条约 2–3 Hz 的慢流做规划、一条约 30 Hz 的快流做残差修正。作者报告,真机四项动态任务的平均成功率从 π0.5 的 8.4% 提高到 49.0%,即摘要里的“约 6 倍”;但更该看的是与最强基线 DynamicVLA 的对比:38.1% 对 49.0%。
三个缺口:静态 VLA 在动态任务里卡在哪
论文把现有 VLA 处理动态操作的失败归为三类:
- 感知缺口:标准 VLA 输入的是静态 RGB 快照,保留了语义,却丢掉了运动线索;没有速度信息,就估计不出目标的轨迹和接触时刻。
- 延迟缺口:异步推理时,VLA 要在动作缓冲区还剩
T_lat步时就开始推理,因此动作是根据T_lat步之前的状态生成、却在之后执行的。静态场景里这无关紧要,目标在动时就会错位。 - 控制缺口:动作块(action chunk)一旦开始执行就是开环的,在下一次推理之前,机器人对环境变化“看不见”。
相关工作中,RTC、VLASH 和 DynamicVLA 主要处理延迟缺口;作者的论点是它们仍然依赖静态视觉输入和开环执行动作块,没有解决另外两个缺口。
慢流 Flow-Planner:光流输入,为执行时刻做规划
慢流建立在 π0.5 架构(一种条件 flow matching 策略)之上,做了两处改动:
- 运动感知:用 RAFT-Large 提取相邻两帧之间的稠密光流,再用极坐标映射把二维光流变成类似 RGB 的三通道图像,方向对应色相、速度对应饱和度,以便与 CLIP 的预训练语义空间对齐。RGB 图像和光流图像分别进入两个并行的 Vision Transformer 编码器,输出的 token 沿序列维拼接。
- 未来状态感知:推理期间,机器人仍在执行上一个动作块的缓冲动作,这部分是确定的。Flow-Planner 用正向运动学把缓冲动作推演一遍,算出执行时刻的本体状态,把它而不是观测时刻的状态作为条件输入。训练时配合随机时间偏移:把时刻 t 的图像与 t+Δ 时刻的本体状态和动作块配对。
训练分两阶段:第一阶段用动态示范数据、带时间偏移地对 Flow-Planner 做监督微调;第二阶段冻结 Flow-Planner,只训练快流。
快流 Res-Refiner:30 Hz 的有界残差
快流是一个轻量的残差策略:ResNet-10 视觉骨干加 8 个可学习空间块,得到 256 维表示;与本体状态、Flow-Planner 当前步的动作拼接后,送入两层各 256 单元的 MLP,输出经 Tanh 压缩的残差。最终执行的动作是动作块当前步与残差之和(论文式 2),残差每一维被限制在动作全范围的 10% 以内。
训练用 RLPD:稀疏二值奖励,回放缓冲区一半离线示范、一半在线经验,并用多个 critic 的集成抑制 Q 值高估。真机上,奖励由人工判定任务成功后给出,每个任务的 RL 阶段约 30–60 分钟。
作者报告的结果
真机平台为 6 自由度 Agilex Piper 机械臂、两台 Intel RealSense D435 相机;慢流基于 π0.5,动作块长度 10,快流以 30 Hz 运行。四项任务分别是传送带抓取、向移动容器投放、在移动方块上堆叠、向移动杯子倒水,每项 5 组 × 50 次试验:
| 真机任务(成功率) | π0.5 | RTC | VLASH | DynamicVLA | DSDyn-VLA |
|---|---|---|---|---|---|
| 传送带抓取 | 8.8% | 12.4% | 20.0% | 33.2% | 44.8% |
| 动态投放 | 14.8% | 43.6% | 50.0% | 56.0% | 62.8% |
| 动态堆叠 | 1.2% | 2.4% | 6.8% | 18.0% | 32.0% |
| 移动倒水 | 8.8% | 16.0% | 30.4% | 45.2% | 56.4% |
| 平均 | 8.4% | 18.6% | 26.8% | 38.1% | 49.0% |
相对最强基线 DynamicVLA,平均提高 10.9 个百分点,各任务提高 6.8 到 14.0 个百分点;“约 6 倍”是相对 π0.5 的倍数。
仿真上有两组评测。DynBench 是作者自建的 MuJoCo 基准,Franka Panda 机械臂,9 项任务(四项由真机任务移植),每项配 100 条规则生成的示范、评测 100 次:平均成功率 π0.5 为 9.7%、RTC 19.4%、VLASH 27.1%、DynamicVLA 34.3%、DSDyn-VLA 48.4%。Kinetix 是基于状态的基准,作者在 12 个任务上人为加入 0–4 步延迟,每个设置 2048 次试验;论文称在高延迟设置下把 SOTA 方法的失败率从 13% 降到 3%(摘要称降低 76% 以上),在最大延迟(δ=4)下成功率仍在 97% 以上。附录还报告了 LIBERO 四个静态套件上不低于 π0.5(例如 LIBERO-10 为 93.30% 对 92.60%),以及外部动态基准 DOMINO 上成功率 20.74%、高于 PUMA 的 17.18%。
消融与开销
真机设计消融(四项任务,50 次试验)中完整模型为 48.5%:去掉光流降到 30.5%,去掉极坐标映射(改用 ResNet-34 直接编码光流)33.0%,去掉未来状态感知 36.5%,去掉 Res-Refiner 25.0%,把 Res-Refiner 改用监督微调而非 RL 训练为 37.5%。DynBench 上去掉 Refiner 或 Future 都是 42.7%,去掉光流分支为 35.3%。
针对“增益只是来自更多时间上下文或额外 RL”的质疑,附录 D 给 RTC、VLASH、DynamicVLA 各加两帧历史画面和 1 小时端到端 PPO:三者分别从 18.0% 升到 24.0%、26.5% 到 32.5%、37.5% 到 39.0%,仍低于 DSDyn-VLA 的 48.5%;把光流换成简单的帧堆叠为 42.5%。
在 RTX 4090 上逐模块计时:VLA 主干合计 73 ms,系统延迟 13 ms,RAFT-Large 3 ms,光流编码器 14 ms,运动学推演不到 1 ms,Flow-Planner 合计 103 ms;Res-Refiner 合计 3 ms,在 30 Hz 的一个周期(约 33 ms)之内。在动态堆叠与移动倒水两项任务上,残差在 95.8% 的情况下各维都低于上限的 80%;作者称上限很少被顶满,这提示 10% 的预算是够用的。光流质量下降时成功率逐步下降:遮挡 70% 时为 42.0%,闪烁光照下为 40.5%(干净条件 48.5%)。
和本站已有内容的关系
《物理AI实验室 0.3:看-想-动,把三个频率放回各自的系统》用“大脑想得慢,小脑动得快”打比方,并强调那只是比方;DSDyn-VLA 的作者也说双流设计受大脑与小脑分工启发。按那一课的规则,这里的约 2–3 Hz 和约 30 Hz 只属于 DSDyn-VLA 这套系统,不能与其他模型或接口的频率拼在一起读。全季安排见课程大纲。
《VLaRL》同样冻结基础策略、再叠加残差 RL,但它只在仿真里训练残差、不做真机 RL;DSDyn-VLA 的残差在真机上用人工给出的二值奖励训练,目标是在一个动作块执行期间跟上运动的物体。103 ms 的分项延迟可以对照《前沿雷达专题|边缘与实时性》阅读;论文称快流可部署在边缘设备,但给出的计时都是在 RTX 4090 上测的。
局限 / 注意
- 这是 arXiv 预印本,所有数字都是作者报告,本站没有独立复现。摘要称将开源全部代码和权重;复现声明说代码在补充材料中,权重在论文正式发表后发布。本文依据的材料中没有公开仓库地址。
- Kinetix 实验中,Flow-Planner 被换成预测动作块(H=8)的 MLP 策略,光流模块也被省去,对照只有 RTC 和 VLASH;它检验的是未来状态感知和残差修正,不是带视觉的完整 VLA。
- DynBench 由作者构建,示范为规则生成;真机为单一平台、四项任务,奖励由人工判定,RL 按任务分别进行。
- 真机主表(49.0%,每项任务 5 组 × 50 次试验)、设计消融(48.5%,50 次试验)和附录 D 中的基线数字(未给出试验次数)彼此略有不同,论文没有解释这些差异,跨表比较时要注意。
- 作者在结论中写明,残差策略的泛化和更多任务、平台上的真机评测仍有待扩展,人机共处环境中的安全与失败风险也需要专门处理。
链接
- arXiv 2609.39198:DSDyn-VLA: A Dual-Stream Dynamic Manipulation Framework with Motion Perception, Future Awareness, and Realtime Correction(作者:Wenhao Li、Xiu Su、Yu Han、Yichao Cao、Shan You、Chang Xu)
- 论文 HTML 全文


