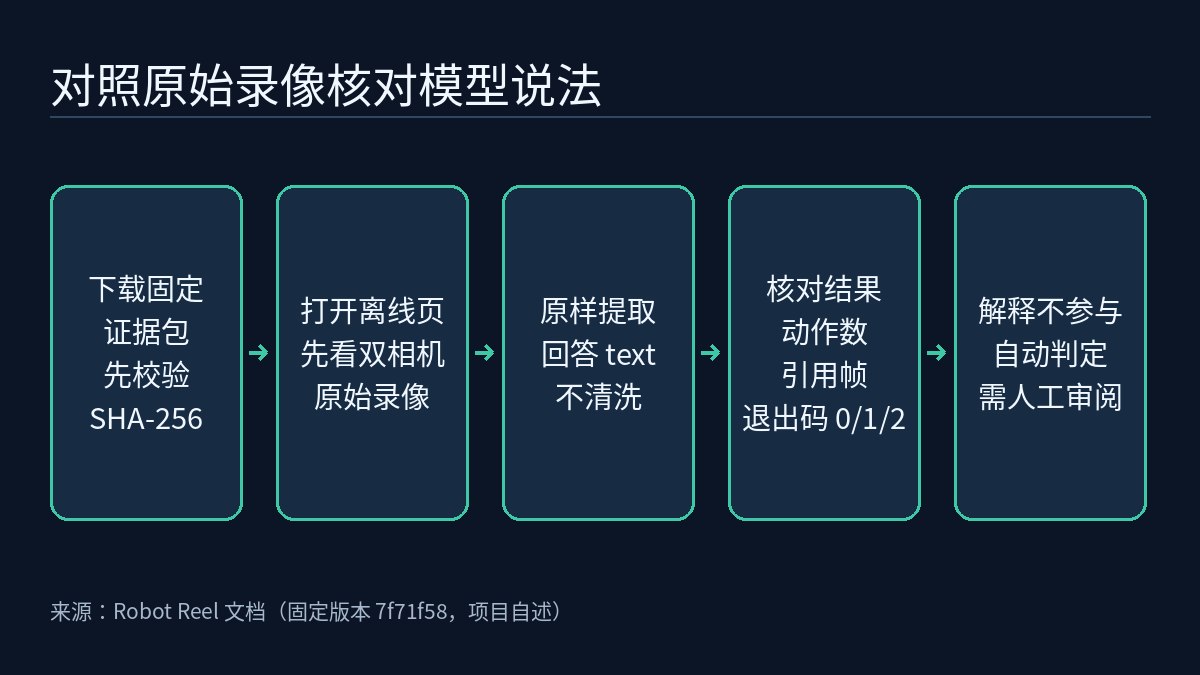
模型根据机器人录像的抽帧写出的解释,本身无法说明它是否与录像一致。Robot Reel 的文档 Your first model-claim review 给出了一套更克制的做法:先看原始双相机录像,再拿一份原样保存的模型回答,用 robot-reel review-claims 逐项核对其中能机械核对的事实,并且明确把解释本身标为 not_assessed(不参与自动判定)。本文按固定版本 7f71f58 的文档整理这套流程,重点是它能证明什么、不能证明什么。
说明:以下命令、预期退出码和实验设置都来自项目文档(O 级,项目自述),本站没有重新运行,也不代表独立复现。Robot Reel 项目本身的整体介绍见 Robot Reel:把机器人策略仿真变成可逐帧核对的回放与三维场景;本文只讲其中的模型说法核对这一环。
这份演示覆盖什么,不覆盖什么
根据 model-review.md,演示从已有的 seed-09 SmolVLA 压力实验中选了三个片段,分别对应 reference、dim 和 camera 三种条件。每个片段有主相机和腕部相机两路录像,各抽 5 帧交给模型 Qwen/Qwen3.8-27B-FP8,分两种输入模式:只给抽帧(Images only),以及抽帧加上机器可读的结果记录(Images + record)。每种模式每个片段生成一次,共 6 份回答。
文档同样写明了它不是什么:不是新的策略运行,不是模型排名,不是总体准确率估计,也不是物理失败机制的证据。三个片段是挑选出来的演示,6 份回答撑不起任何统计结论。
准备:固定版本的包和证据
整个流程不需要 GPU、模型账号、克隆仓库或重新仿真。文档要求 Python 3.12 及以上,在新目录里安装已发布的包(标准安装会一并装上 Robot Reel 的仿真依赖,但这里只用离线核对命令):
mkdir robot-claim-first-review && cd robot-claim-first-review
python3 -m venv .venv
.venv/bin/python -m pip install robot-reel==0.16.0
证据包是 v0.16.0 release 里的 ZIP,内含三个 SmolVLA 片段、两路原始相机录像、trace、实际抽取的图片、6 份模型回答和离线页面。文档给的脚本先比对 SHA-256,不一致就拒绝解压:
.venv/bin/python - <<'PY'
import hashlib
import io
from pathlib import Path
from urllib.request import urlopen
from zipfile import ZipFile

url = "https://github.com/noteflowai/robot-reel/releases/download/v0.16.0/robot-reel-model-review.zip"
expected = "7691e06219d840dab3a19f3e411ad513ed69f00e3c69437e046b1f032cc601b3"
with urlopen(url, timeout=60) as response:
    data = response.read()
if hashlib.sha256(data).hexdigest() != expected:
    raise SystemExit("Archive checksum differs; do not extract it.")
Path("recorded-review").mkdir()
with Path("review.zip").open("xb") as output:
    output.write(data)
with ZipFile(io.BytesIO(data)) as archive:
    archive.extractall("recorded-review")
PY
解压后打开 recorded-review/index.html,选 dim,播放双相机录像,再对比两种模式的回答。顺序很重要:先看原始录像,再读模型解释。在线版本见 Robot Reel 模型解释核对页。
核对一份原样保存的回答
review-claims 接受的说法文件只有四个字段:
{
  "outcome": "step_limit",
  "action_count": 160,
  "cited_frames": [0, 160],
  "explanation": "A visual interpretation to be reviewed separately."
}
这段 JSON 是文档作者写的格式示例,不是模型输出。真正的输入是从 recorded/ 目录里取出的 text 字段,不做任何编辑或清洗:
.venv/bin/python - <<'PY'
import json
from pathlib import Path

source = Path("recorded-review/recorded/episode-b-with-record-17.json")
record = json.loads(source.read_text())
with Path("claims.json").open("x") as output:
    output.write(record["text"])
PY
.venv/bin/robot-reel review-claims \
  recorded-review/media/episode-b/trace.json claims.json --output my-review.json
检查器把每项事实报告为 matched、contradicted 或 unassessed,用 SHA-256 绑定两个输入文件,并拒绝覆盖已有报告。退出码的含义:
| 退出码 | 含义 |
|---|---|
| 0 | 结果和动作数两项都匹配,且至少一个引用帧存在 |
| 1 | 有效 JSON,但存在矛盾或未评估(unassessed)的说法 |
| 2 | 输入无效,或输出出错 |
这份“图片加记录”回答的预期退出码是 0:结果 step_limit、动作数 160 和引用的帧标签都与 trace 一致,报告里的解释保持 "explanation_status": "not_assessed"。unknown 和 null 用来保留不确定性,不会被当成通过。
文档特别提醒:这份回答的输入里本来就有结果记录,复述它只是“读记录”,不是模型独立发现了失败。帧编号真实存在,也不说明那张图支持模型的解释,更不证明物理原因。
让格式失败保持可见
在同一个目录中,原样提取 Images only 回答,再运行同一个检查器:
.venv/bin/python - <<'PY'
import json
from pathlib import Path

source = Path("recorded-review/recorded/episode-b-images-only-17.json")
record = json.loads(source.read_text())
with Path("images-only.json").open("x") as output:
    output.write(record["text"])
PY
.venv/bin/robot-reel review-claims \
  recorded-review/media/episode-b/trace.json images-only.json
同一片段的“只看图片”回答,没有按要求输出纯 JSON,而是把 JSON 包在 Markdown 代码围栏里。把它的原文交给同一个检查器,预期退出码是 2,因为它不是严格的 JSON 文档。
文档的要求是:不要去掉围栏、把清洗后的内容当作模型的原始结果上报。离线页面为了可读性会提取围栏内的内容显示,但同时保留格式失败的标记。对评测来说,“模型没按格式回答”本身就是一条应当记录的结果。
模型收到了什么
协议在生成前提交。examples/model-review/sources.json 固定了源提交、片段和 trace 的哈希、抽帧索引以及拼接缩略图(contact sheet)的精确哈希。这些缩略图拼版是从已发布的有损 MP4 衍生文件解码出来的,不是策略运行时的原始 RGB 输入缓冲。两种模式的提示词只差一处:是否附上机器可读的结果事实。
生成参数:模型版本 017b9c7af6b5689d5dd426a76e0bc077eb5ca20a,seed 17,temperature 0.6,top-p 0.9,top-k 20,关闭 thinking,512 token 预算。所有完成的输出,包括无效 JSON 和错误说法,都被保留。记录时使用一块 L40S;文档提醒,重新生成在不同硬件或库版本上可能得到不同结果,日常核对直接用已发布的输出即可。
文档还记录了一个加载问题:Transformers 5.17.0 把该检查点里并不存在的 dense 模型 mlp.gate 排除项当作正则前缀,误把 gate_proj 也排除在外,丢失了它的 FP8 scale。记录脚本的 --fix-dense-fp8-skip 只在内存里移除这些路由排除项,不改动源权重,并拒绝任何缺失、多余或不匹配的检查点键;初始化失败的记录与完成的输出分开保存。
局限 / 注意
- 自动核对只覆盖结果标签、动作数和引用帧是否存在。解释和因果判断始终是
not_assessed,需要人对照录像另行审阅。 - trace 是给定的证据,不是经过独立认证的物理事实;与 trace 一致不等于与真实世界一致。
- 三个挑选片段、每种条件一次生成,不能用来比较模型或估计准确率。
- 模型看到的是有损 MP4 解码出的缩略图拼版,与策略实际输入的图像不同。
- 再分发机器人媒体时须保留证据包中的
NOTICE.txt;Robot Reel 的代码许可证不会给上游机器人素材重新授权。 - 本站只阅读了固定版本的文档,没有运行上述命令。
“能核对”不等于“已证实”,这与 物理AI实验室课程 对证据的要求一致:能找到原始出处,不代表出处里的结论一定成立。