EvalArc 是一个评审智能体(agent)评测结果的 Python 命令行工具。它不看总分,而是逐个 case、逐项检查比较两次运行,按事先写明的验收规则判定,并输出别人能从原始记录重新算出来的报告。它针对的情况是:平均分上升了,某个原本通过的检查却开始失败。只看总分,这类回归就会被放过去。
一个具体的例子
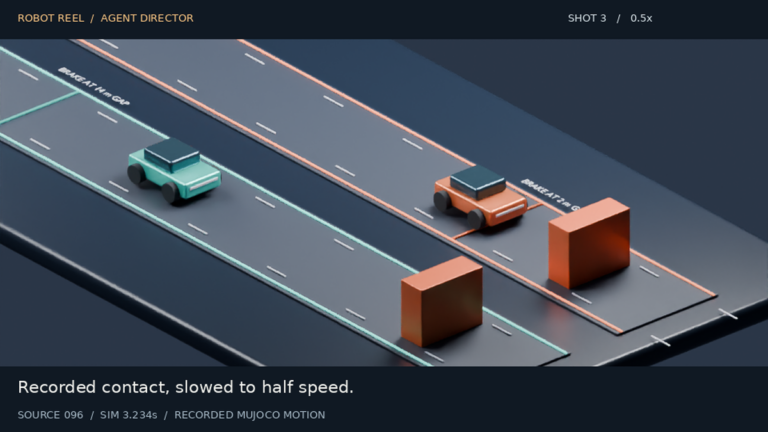
仓库自带的演示是一个模拟客服工单任务(support-routing)。新版本的得分从 90% 升到 93.75%:两项检查变好,一项原本通过的检查变成失败。原因藏在工具调用记录里:某次工具调用其实已经写入了备注,却返回了错误;智能体换了一个新的幂等键重试,同一条备注被写了两次。这个 case 的得分是 0.9375,但严格的备注规则判定它不通过验收。EvalArc 的轨迹视图会把这次报错、这次重试和随之产生的状态变化逐一列出来。
评分只依据宿主机上最终的工单状态,候选程序自称“成功”不作数。只有全部检查都通过,一个 case 才算解决。
用在你已有的评测结果上
evalarc diff 读取两份 Inspect AI 日志、promptfoo --output 文件或 JUnit XML,把每个 case 的每项检查配对比较。只要基线上通过的检查变成失败、通过率下降、被跳过或消失,命令就以退出码 1 结束,并输出一份离线报告,附两份输入的副本。仓库里录制的 Inspect 示例中,accuracy 从 0.625 升到 0.8125,同时有 3 项检查失去通过。它也提供 GitHub Action,可以在 PR 上直接卡住:
- uses: noteflowai/evalarc@v0.16.0 # 或完整 commit SHA
  with:
    baseline: evals/baseline.json
current: results/current.json仓库还公开了一次真实模型配置变更的记录:Qwen/Qwen3-8B(BF16)对比 Qwen/Qwen3.8-27B-FP8,8 个公开的客服规划 case,每种配置、每个 case 各生成 3 次,48 份原始回答全部保留,用 pytest 原生检查打分(录制硬件为 NVIDIA L40S)。完整计划的匹配数从 15/24 升到 19/24,但 5 项检查退化、5 项变得不稳定,升级门禁判定失败。README 同时说明,这 10 项阻断性检查共享两类格式问题:already-closed 的回答漏了 actions 字段,resolved-bug 有两次把 JSON 包进了 Markdown 代码块。所以它们不是 10 个独立的失败原因。作者也写明这只是一个小型开发示例,不是模型排行榜:两者的架构、参数量和量化方式都不同,也没有做去污染处理。
审计评分器本身
EvalArc 的另一半工作是检验评分器能不能抓到已知缺陷:先准备一个参考实现和若干故意植入的错误版本,看每个错误是否在预期的维度被检出。内置三个任务包:
| 任务 | 内容 | 声明的缺陷 | 只被一个 case 检出 |
|---|---|---|---|
durable-kv | 编码产物:响应、事务、重启后持久化 | 8 | 3 |
support-routing | 模拟工单工具:路由、备注、关闭、无关状态 | 7 | 2 |
robot-evidence-review | 带来源的录制:坐标、时钟、缺失观测 | 6 | 1 |
已保存的审计检出了全部 21/21 个声明的缺陷,其中 6 个只靠一个 case 检出,删掉那个 case 就会漏掉。编码任务每个种子 15 个 case,分六个加权维度(基本行为 25%、校验 15%、事务 20%、CAS 15%、持久化 15%、崩溃恢复 10%)。“布尔值与数字判等”这个缺陷能拿到 0.925 的部分分,但过不了完全解决:部分得分和验收是分开计算的。期望值在候选容器之外计算,评分器从不采信候选程序报告的 reward。
怎么试
在线演示回放的是已保存的 Docker 运行,不需要安装、账号或模型 key:noteflowai.github.io/evalarc。本地安装(Python 3.11+):
python3 -m venv .venv
. .venv/bin/activate
python -m pip install evalarc==0.16.0
evalarc --version
离线复核不需要 Docker、Node、GPU 或模型 API,步骤见 docs/first-review.md:校验一致性的命令退出码为 0,比较命令因存在回归而退出码为 1。要实际执行参考实现和 8 个编码缺陷,需要 Docker:
docker pull python:3.12-slim
evalarc audit --seeds 17 41 97 --output runs/audit
退出码 0 表示参考实现通过且全部缺陷在预期维度被检出,1 表示审计或候选失败,2 表示输入无效或环境故障。评测你自己的编码智能体时,先用 evalarc init workspace/durable-kv 生成工作区,把 TASK.md 交给智能体,改完后运行 evalarc evaluate。
局限 / 注意
- 状态是 Research preview,当前版本 0.16.0(2026-09-28),MIT 许可;本地工作流仅支持 Linux,Python 核心没有第三方运行时依赖。
- 检出结果只对声明过的缺陷、选定的 case 和记录下来的执行条件成立,不能说明对未知缺陷的覆盖率,也不能说明抗 reward hacking 的能力。只换随机种子不等于独立的 held-out 评测。
- EvalArc 自己不调用 LLM,也不配置模型凭据。轨迹导入只接受限定的导出格式,不接受任意云端导出;README 明确说明没有做过线上 AgentCore 评测。
--backend local --trust-local以当前用户权限执行候选程序,隔离不可信候选请用 Docker。- 公开的小规模 GPU 实验多为阴性或不确定结果。例如三个公开 SWE 任务上的 36 次尝试,没有一次获得原生验收,其中 5 次因上游基础设施标记被记为不确定。作者把它们当作开发实验保留,并不主张任何效果。
链接
- 源码:github.com/noteflowai/evalarc(中文 README)
- 在线演示:noteflowai.github.io/evalarc · 模型升级对照
- PyPI:pypi.org/project/evalarc
- Hugging Face Space:glayguo/evalarc
- 方法论:docs/methodology.md · CI 门禁:docs/ci-gate.md · 模型升级协议:examples/model-upgrade