
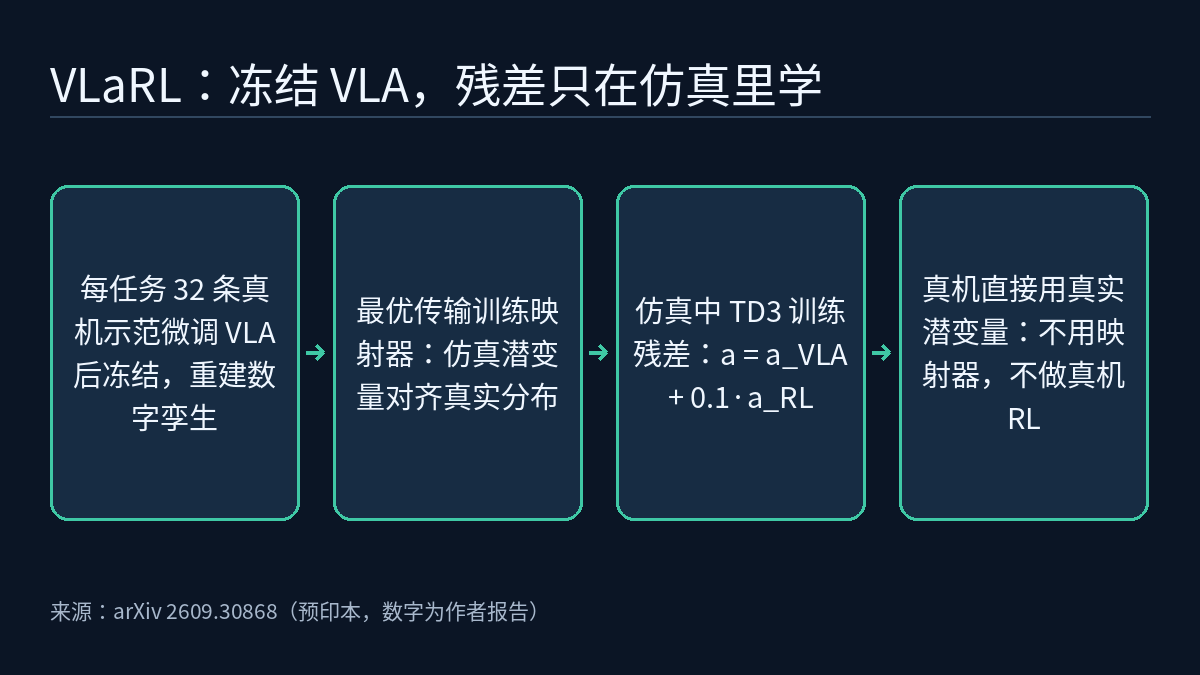
VLA 模型能按语言指令给出大体正确的操作,但到了按按钮、推物块、叠杯子这类接触密集的环节,接触位置或对齐稍有偏差,任务就会失败。微软亚洲研究院(东京)的预印本 VLaRL(arXiv 2609.30868,2026-09-25,证据等级 [R])的做法是:把 VLA 冻结,只学一个叠加在它输出上的修正量(残差策略),强化学习全部在仿真里完成,部署到真机时不做真机 RL,也不做在线适应。这篇论文值得关注的是它为跨越仿真与现实视觉差距选的接口:既不是图像,也不是物体位姿,而是 VLA 内部已经算好的视觉-语言潜变量,再加上一个把仿真潜变量推向真实分布的轻量映射器。
为什么是“冻结 VLA + 仿真残差 RL”
作者的出发点是:VLA 常常给出合理的名义动作,却在物理执行时失败。用更多模仿学习来修,需要采集体现修正的示范并更新基础策略;残差 RL 保留 VLA 的名义行为,只学修正量,可以直接用任务奖励来优化。但在真机上反复试错成本高,也有安全风险,所以作者把残差策略的训练完全放进仿真。
实际执行的动作是名义动作加上缩放后的修正:
a_t = a_t^VLA + α · a_t^RL    # α = 0.10,所有任务共用
a_t^RL = π_RL(z_t, a_t^VLA, s_t, f_t)
残差策略的输入有四项:VLM 潜变量 z_t、VLA 的名义动作、本体状态 s_t(末端位置与 roll–pitch–yaw 姿态、夹爪状态)和腕部测得的三维笛卡尔力 f_t。两种骨干的动作都是 7 维归一化笛卡尔动作(三维平移、三维旋转、一个夹爪指令),残差 actor 输出同样维度的 tanh 动作,初始化为接近零的修正。
接口选择:图像、位姿,还是 VLM 潜变量
论文把已有的 sim-to-real 接口分成两类:以图像为输入的策略保留了丰富的场景信息,但直接暴露在视觉差距之下;物体位姿这类几何状态紧凑,却需要单独的感知流程和针对任务定义的状态。作者团队此前的 object-centric residual RL 就是用估计的 6-DoF 物体位姿作接口。
VLaRL 改用冻结 VLA 自己的视觉-语言模块输出的 token 矩阵(S 个 token,每个 D 维),对 token 做均值池化后得到 D 维向量交给残差策略。Flower 取其基于 Florence-2 的视觉-语言模块中带语言条件的 token,池化后为 1024 维;GR00T N1.7 取带语言条件的图像 token,为 2048 维。作者的理由是,这个表示已经抽象掉了部分像素细节,又保留了与任务相关的视觉和指令上下文;同一场景下,指令指定的目标或物体角色不同,需要的修正也不同,而这些信息只看名义动作是看不到的。
但作者也指出,这个表示对视觉差距并不完全不变:相近的任务状态,仿真图像和真实图像仍会产生不同的潜变量分布。映射器就是为此加的。
四步流程与映射器
- 微调并冻结 VLA,重建数字孪生:每个任务用 3D 鼠标遥操作采集 32 条真机示范(Franka Research 3),微调 VLA 后冻结;用同一批示范和 FoundationPose 重建物体位置与环境,在 MuJoCo 中得到近似对应的任务配置。
- 训练映射器:一个 4 层、16 头的 Transformer 编码器,作用于池化前的仿真 token 序列,带可学习的残差连接,缩放系数初始化为 0,因此一开始等同于恒等变换。由于仿真与真实轨迹只是近似对应,没有逐帧配对,作者用熵正则最优传输(Sinkhorn divergence)做分布对齐:代价是映射后仿真 token 与真实 token 之差的平方 Frobenius 范数(除以 S·D),加上归一化轨迹进度差的平方乘以 λτ。超参数为 λτ = 0.5、ε = 0.05、50 次 Sinkhorn 迭代。
- 仿真中训练残差:映射器冻结后,用 TD3 训练 60,000 个环境步。映射后的 token 同时有两个用途:送进冻结的 VLA 动作头,减小用真实数据微调的 VLA 在仿真图像上遇到的表示偏移;池化后送进残差 actor。critic 额外获得仿真中的特权任务状态,actor 只用部署时能拿到的观测(非对称 actor–critic)。此外用示范构造残差目标 (a_demo − a_VLA) / α,作为辅助正则项。
- 真机部署:真实图像的 token 直接池化后交给残差策略,不再经过映射器;所有模型保持冻结。
作者报告的结果
四个任务分别考察不同的局部控制难点:按按钮(精确接触)、推物块(持续接触)、叠杯子(抓取加空间对齐)、关抽屉(铰接物体接触)。物体初始位置随机偏移 ±3 cm、朝向 ±15°,抽屉开度随机 ±3 cm。仿真结果取 3 个随机种子,真机每个条件 40 次试验。论文称,VLaRL 在全部 8 个任务–骨干组合上都提高了真机成功率。正文中写出数字的组合如下(其余组合只在柱状图中给出,本文不转述):
| 条件(真机,每项 40 次) | 冻结的基础 VLA | VLaRL |
|---|---|---|
| Flower,按按钮 | 67.5% | 100.0% |
| Flower,推物块 | 22.5% | 50.0% |
| GR00T N1.7,叠杯子 | 17.5% | 45.0% |
| 未见过的物体,推物块(星形、三角形) | 40.0%(16/40) | 57.5%(23/40) |
| 未见过的物体,叠杯子(天蓝色、绿色杯) | 55.0%(22/40) | 62.5%(25/40) |
未见过物体的实验没有做额外的残差 RL 或真机适应。仿真中的例子是 Flower 推物块:基础 VLA 32.5%,加映射器后 42.5%,完整 VLaRL 67.5%。映射器本身就能提高仿真中的名义成功率,这与“减小表示偏移”的设计意图一致。
作者也报告了仿真和真机走势不一致的情况:Flower 叠杯子的基础成功率在真机上明显高于仿真,而残差在真机上只带来很小的额外提升。作者的解释是,潜变量对齐消除不了接触动力学、VLA 动作分布等其他方面的 sim-to-real 差异。
消融:映射器和潜变量各起什么作用
两组受控消融都只在 Flower 上做:
- 去掉映射器(用未对齐的仿真潜变量训练残差):推物块和叠杯子在全部 40 次真机试验中都失败,完整 VLaRL 分别为 50.0% 和 70.0%。也就是说,直接在原始仿真潜变量上训练的残差迁移不到真实潜变量上。
- 去掉 VLM 潜变量(保留名义动作、本体状态和力):四个任务的真机成功率都下降,例如按按钮从 100.0% 降到 70.0%,推物块从 50.0% 降到 20.0%。
作者还用积分梯度(integrated gradients)分析残差动作范数来自哪些输入:在所有任务和两个骨干上,VLM 潜变量的归因占比都最大,Flower 为 72.1%–89.7%,GR00T N1.7 为 84.0%–90.9%。物理输入的份额随任务变化:推物块需要持续接触,力的份额上升;叠杯子需要精确调整位置,本体状态的份额更高。归因反映的是网络对各输入的依赖程度,本身不构成因果证明;作者是把它和消融结果放在一起作为证据的。
和本站课程与已有文章的关系
《前沿雷达专题|训练与自我改进:VLA 后训练的三个阶段与在线 RL 的 task collapse》梳理了从 SFT 到仿真和真机 RL 后训练的流程。VLaRL 提供了另一种分工:VLA 只做一次监督微调,之后权重不再改动,RL 只优化一个小的残差网络,而且完全不在真机上跑。
课程大纲中 L2 规划了一集讲 sim2real 中的域随机化与系统辨识。VLaRL 针对的是视觉差距,用潜变量分布对齐代替像素层面的对应;作者明确说明映射器不处理接触动力学、摩擦和柔顺性,这部分差距仍需另行处理。实验用到的 GR00T N1.7 在《物理AI实验室 0.2:为什么是现在,数据、模型、算力三条曲线》中介绍过;这篇论文把它和结构差异很大的 Flower 放在同一套流程里比较。
局限 / 注意
- 这是 arXiv 预印本,以上数字都是作者报告的结果;本文依据的材料中没有独立复现,也没有代码仓库链接。
- 训练映射器需要近似对应的仿真–真实轨迹,要为每个任务单独重建数字孪生。这只在训练阶段需要,但作者也承认它限制了方法的扩展。
- 映射器针对的是视觉差距在 VLM 表示中造成的偏移,不显式处理接触动力学、摩擦、柔顺性等物理差异,作者认为这可能是仿真与真机结果不一致的原因。
- 映射器与 VLA 骨干绑定,残差策略目前每个任务类别单独训练。
- 未见过物体的评测只覆盖少量物体变化,作者明确说明不能据此推出开放世界泛化。
- 两组消融只在 Flower 上做。真机每个条件 40 次,正文没有给出置信区间或显著性检验;例如未见过的杯子一项,差异是 22/40 对 25/40,只差 3 次成功。
链接
- arXiv 2609.30868:VLaRL: Augmenting Vision-Language-Action Models with Simulation-Trained Latent-Conditioned Residual RL(作者:Namiko Saito、Kinam Kim、Heecheol Kim、Katsushi Ikeuchi、Yasuyuki Matsushita)
- 论文 HTML 全文


