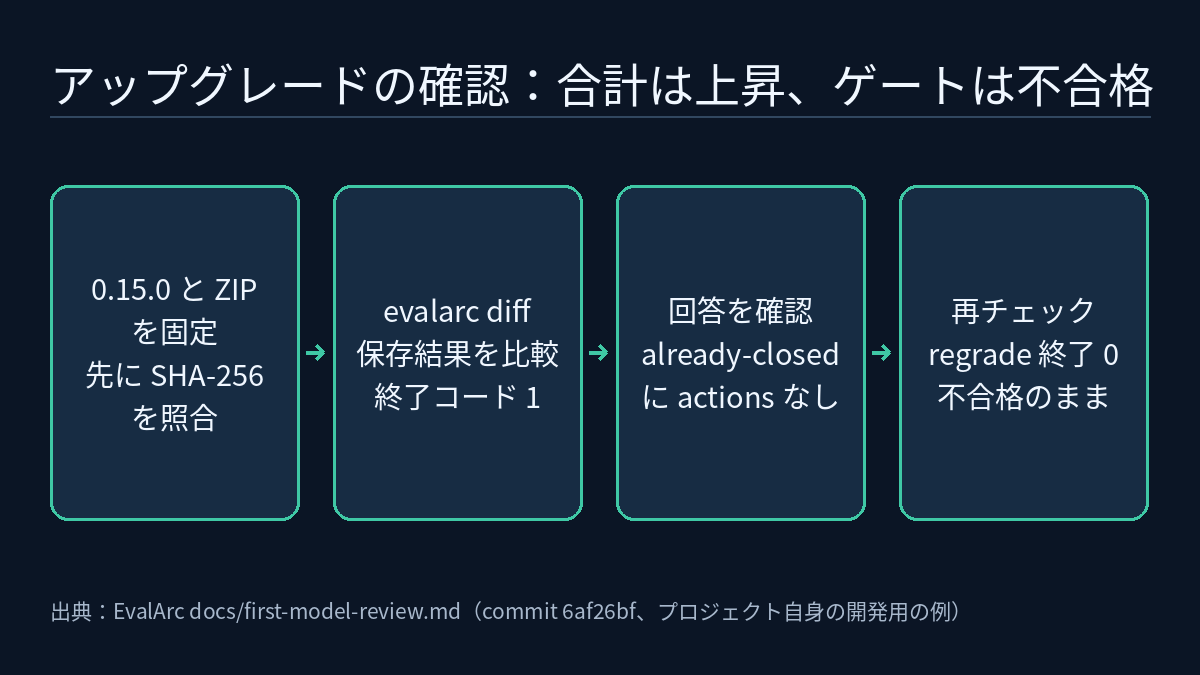
あるモデル構成のアップグレードで、計画全体の一致数は 15/24 から 19/24 に上がりました。それでもアップグレードゲートは不合格と判定しました。5 つのチェックが退行し、5 つのチェックで信頼性が下がったためです。EvalArc リポジトリのガイド「Your first model-upgrade review」は、この判定を誰でも再現できるレビュー手順にまとめています。バージョンを固定したツールを入れ、バージョンを固定した記録をダウンロードし、判定を自分で計算し直します。リポジトリのクローン、GPU、モデル API はいずれも不要です。本記事では、commit 6af26bf に固定したこのガイドに沿って、レビューの進め方、終了コードとレポートの各フィールドの読み方、結論がどこまで言えるかを説明します。
本サイトの EvalArc:スコアが上がったとき、エージェントはどこで退行したのか で、このツールとこの比較の結論はすでに紹介しました。本記事ではツールの紹介は繰り返さず、レビューの操作手順と結果の読み方に絞ります。以下の数値はすべてプロジェクト自身のドキュメントと保存された記録によるもので([O]、作者が報告した開発用の例)、第三者による独立した評価ではありません。
このアップグレードで何を比べたか
ベースラインは Qwen/Qwen3-8B(BF16)、現行構成は Qwen/Qwen3.8-27B-FP8 です。公開されたサポート計画のケース 8 件について、ケースごと・構成ごとに新たに 3 回ずつ生成し、48 件の回答をすべて保存しています。計画は照合するだけで、実行はしていません。各回答には pytest のチェックを 5 つ適用します。JSON の形式、ルーティング呼び出し、メモの内容とリトライキー、クローズ条件、順序を含む計画全体です。したがって各構成で 5 × 24 = 120 件のチェック結果があります。
ケースとチェックの組で数えると 40 項目になり、10 項目が改善、20 項目が変化なし、5 項目が退行、5 項目で信頼性が低下しました。退行と信頼性低下の計 10 項目がアップグレードを阻んでいます。これらは 2 つのケースの形式・スキーマの問題に行き着き、10 個の独立した原因ではありません。
already-closed:5 つのチェックすべてが 3/3 から 0/3 に下がりました。たとえば seed 17 では、ベースラインは{"actions":[]}を返し、現行モデルは{}を返して必須のactionsキーが抜けています。resolved-bug:5 つのチェックすべてが 3/3 から 1/3 に下がりました。2 件の回答が JSON を Markdown のコードフェンスで囲んでいたためです。
チェックは互いに独立していません。JSON が不正になると、その回答のチェックはすべて失敗します。そのため、ブロックしているチェックの数をそのまま深刻度とみなすことはできません。元の回答に戻って、実際に何が起きたかを確認する必要があります。
GPU なしで判定を再現する
Python 3.11 以上と新しいディレクトリを用意します。ガイドのコマンドは Linux/macOS の Bash を前提にしています。まずリリース版をインストールします。
mkdir evalarc-model-first-review && cd evalarc-model-first-review
python3 -m venv .venv
.venv/bin/python -m pip install evalarc==0.15.0次に、v0.15.0 のリリースアセット evalarc-model-upgrade.zip をダウンロードします。ガイドのダウンロードスクリプトは先に SHA-256 を照合し、一致した場合だけ展開して、元のファイルも残します。一致しなければ展開せずに終了します。期待値は 6b1b9212d5b25da281c54f192489298af7a0b0f4524f807ea6e2821bfa6f515c で、リリースの SHA256SUMS にも同じ値があります。展開後に recorded-review/index.html を開くと、48 件の元の回答をすべてオフラインで閲覧できます。
.venv/bin/python - <<'PY'
import hashlib
import io
from pathlib import Path
from urllib.request import urlopen
from zipfile import ZipFile

url = "https://github.com/noteflowai/evalarc/releases/download/v0.15.0/evalarc-model-upgrade.zip"
expected = "6b1b9212d5b25da281c54f192489298af7a0b0f4524f807ea6e2821bfa6f515c"
with urlopen(url, timeout=60) as response:
    data = response.read()
if hashlib.sha256(data).hexdigest() != expected:
    raise SystemExit("Archive checksum differs; do not extract it.")
Path("recorded-review").mkdir()
with Path("review.zip").open("xb") as output:
    output.write(data)
with ZipFile(io.BytesIO(data)) as archive:
    archive.extractall("recorded-review")
PY
続いて、アップグレード判定を計算し直します。
.venv/bin/evalarc diff recorded-review/reports/baseline.xml \
  recorded-review/reports/current.xml --output my-review
結果は my-review/index.html または my-review/diff.json で確認します。記録済みのブラウザ画面で already-closed、seed 17 を選ぶと、上で挙げた回答の組を見られます。このステップは保存済みのネイティブなテスト結果(JUnit XML)を比べるだけで、回答の再生成もチェックの再実行もしません。
終了コードと gate_passed が示すもの
このガイドには、読み違えやすい終了コードが 2 つあります。
| コマンド | 処理内容 | 想定される終了コード | 意味 |
|---|---|---|---|
evalarc diff | 保存済みの JUnit 結果を比較する | 1 | 比較は正常に完了し、ゲートがアップグレードを不合格とした |
regrade.py | 保存されたすべての回答に 5 つのチェックを再実行し、新しい JUnit を書き出して比較を再計算する | 0 | スクリプトの処理は完了した。regraded/comparison.json は引き続き "gate_passed": false |
つまり、diff の終了コード 1 は判定結果であって、実行エラーではありません。regrade.py の終了コード 0 はスクリプトが最後まで動いたことを示すだけで、アップグレードの合格を意味しません。この入門ガイドが示しているのは、想定される終了コード 1 と 0 だけです。ゲートのルールと入力形式は examples/results-diff/README.md にあります。再採点の後は gate_passed フィールドを読んでください。プロセスがエラーを出したかどうかだけでは判断できません。
任意の再採点には、記録時と同じ pytest のバージョンを入れ、毎回新しい出力ディレクトリを指定します。
.venv/bin/python -m pip install pytest==8.4.2
.venv/bin/python recorded-review/regrade.py --output regraded
このステップでもモデルは一切呼び出しません。採点器が秘匿化するメタデータは 2 種類だけです。JUnit のホスト名と、stdout に含まれるレポートディレクトリの絶対パスです。秘匿化前後のハッシュが記録され、モデルの回答とチェック結果は変更されません。
自分のアップグレードレビューに当てはめる
自分の変更で使う場合について、ガイドの要求はわずかです。2 回の実行でケース ID、チェック名、評価対象の契約を揃えること。すべての試行を残すこと。ネイティブな結果を evalarc diff に渡すこと。入力形式とゲートのルールはリポジトリの examples/results-diff/README.md にあります。この例の実験ガイドには、ほかにもそのまま取り入れられる進め方が書かれています。
- 結果より先にプロトコルを決める。
protocol.jsonは回答が 1 件も完成する前にコミットされ、期待される計画は生成された回答とは別に保存されています。 - 両側の条件を揃える。2 つのモデルには同じポリシー、ケース文、サンプリング設定、seed を与えます。seed は 17・29・43、temperature 0.6、top-p 0.9、top-k 20、thinking は無効、出力上限は 512 トークンです。記録に使ったハードウェアは NVIDIA L40S です。
- ロード時の修正も記録に残す。Transformers 5.17.0 の正規表現による接頭辞マッチは、チェックポイントに存在しない dense な
mlp.gateのルーター除外指定をgate_projの除外指定と取り違え、そのスケールテンソルを捨ててしまいます。FP8 の記録スクリプトはメモリ上でこれらのルーター項目を取り除き、チェックポイントのすべてのキーの扱いが説明できることを要求します。具体的な調整内容とロードのレポートは identity ファイルに、回答を 1 件も生成できなかった初期化失敗はruntime-failures.jsonに記録されています。 - 失敗した回答も残す。10 項目のブロックにつながった回答も、手を加えずにすべて記録に残っています。
制約と注意点
- これは小規模な開発用の例で、モデルのリーダーボードではありません。2 つの構成はアーキテクチャ、パラメータ数、量子化がいずれも異なるため、差を単一の要因に帰すことも、モデル全体の能力を推定することもできません。
- ケースは選ばれた公開の開発用ケースで、学習データに含まれていた可能性があります。デコンタミネーションは行っておらず、母集団での正答率も主張していません。
- 計画全体の一致は狭い範囲の契約チェックです。実際のサポート業務が完了したことの証明にはならず、計画も実行していません。
- ケースごとの 3 回の生成は別々のサンプリング呼び出しで、1 つの回答を 3 回採点したものではありません。作者は一般的な Pass^k の推定値としても提示していません。
- 既定のレビュー手順で示せるのは、保存済みの結果からこの判定が計算できることだけです。
regrade.pyも保存済みの回答にチェックを再実行するだけです。どちらも回答を生成し直す独立した再現ではありません。ハードウェア、カーネル、ライブラリのバージョンが変わると、サンプリング結果も変わる可能性があります。記録された所要時間は診断用の観測値で、スループットの比較ではありません。 - 本記事は commit
6af26bfのドキュメントとevalarc==0.15.0に基づいています。新しいバージョンではコマンドや出力が異なる場合があります。