
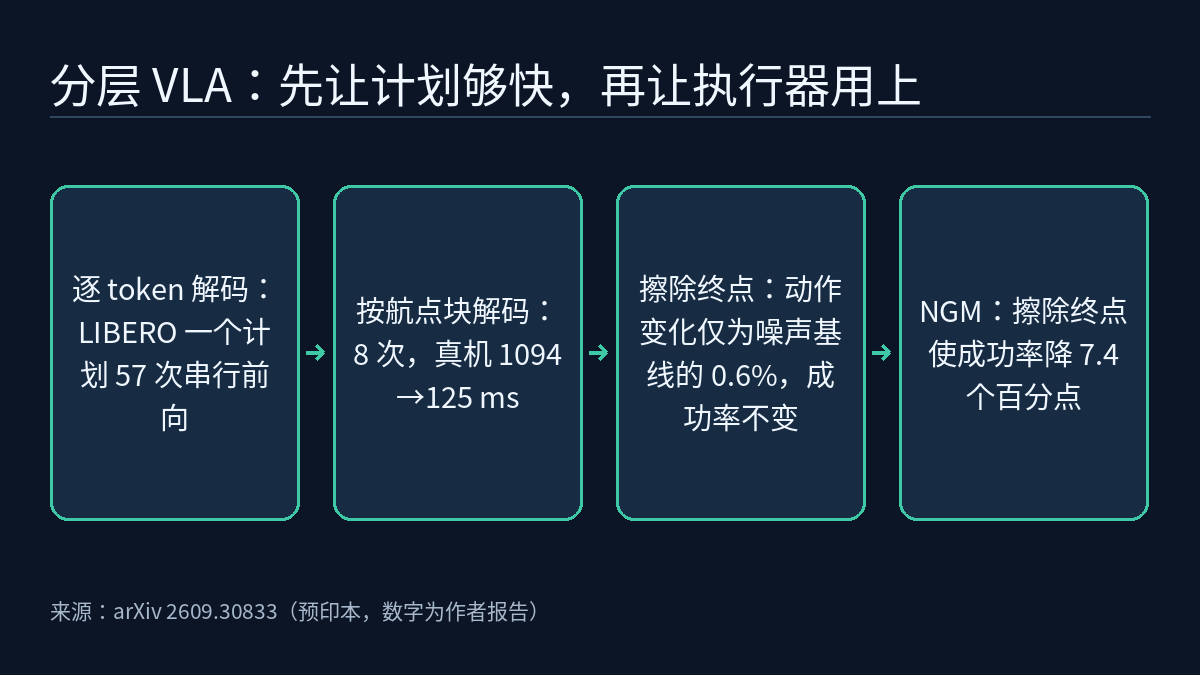
分层视觉-语言-动作(VLA)模型让一个大的视觉-语言规划器先写出中间计划,再由低层动作专家把计划变成连续动作。南洋理工大学 MARS Lab 的预印本 Fast Plans, Faithful Actions(arXiv 2609.30833,2026-09-25,证据等级 [R])指出,这种分工要有意义,需要两个条件:计划生成得够快,执行器也真的按计划行动。作者在自己搭建的基线上发现两条都不满足,并给出了测量方法和两处修改。对做分层 VLA 的团队,这篇论文最有参考价值的是它的干预测试:端到端成功率高,并不能说明规划器与执行器之间的接口在起作用。
研究对象:从 π0.5 改出的航点分层
作者把 π0.5 改成分层结构,称为 Waypoint Token-AR:PaliGemma 骨干(SigLIP 编码器加 Gemma-2B 语言模型)作为规划器,在机器人构型空间里预测航点,每个航点包含目标构型、夹爪状态和执行时长(动作步数)。继承自 π0.5 的 300M 参数动作专家用 flow matching 训练,通过后缀 token 接收当前状态和航点,同时还能经交叉注意力看到图像与语言前缀。论文特别说明,这个基线是作者为受控实验专门搭建的,不是 π0.5 的原始架构。航点用 AWE 算法离线从示范中提取,每段长度限制在动作专家的预测窗口 D = 32 步之内。
快:按航点而不是按 token 解码
基线用逐 token 自回归(Token-AR)生成计划。LIBERO 中一个 7 航点的计划需要 57 次串行骨干前向(1 次前缀 prefill 加 56 个取值 token);双臂机器人有 16 个自由度,每个航点 19 个 token,最多需要 120 次。论文称,在真机上生成一个计划的时间比执行它所规定的动作段还长,双臂有 71% 的运行时间处于等待状态。
作者把原因归结为粒度不匹配:执行器按航点消费计划,规划器却按 token 生成。Block-AR 把每个航点当作一个块,块内双向注意力、块间因果注意力,输入整体右移一个块,一次前向经三次 LM head 调用读出构型、夹爪和时长。这样,最长的计划只需 8 次前向(1 次 prefill 加 7 个航点),与每个航点有多少个槽位无关。作者报告的规划成本如下:计划延迟、请求往返和运动占空比来自 Rokae 双臂机器人上的 35 个遥测 episode;结束标记指标来自 2,172 个留出的真机规划窗口(其中 270 个真实结束点);最多串行前向次数由解码结构决定,不是测量值。
| 指标 | Token-AR | Block-AR |
|---|---|---|
| 每个计划最多串行前向次数(LIBERO / 机器人) | 57 / 120 | 8 / 8 |
| 计划延迟 | 1094 ms | 125 ms |
| 请求往返(含动作专家) | 1266 ms | 293 ms |
| 运动占空比 | 28.7% | 65.6% |
| 计划结束标记召回率 / 精确率 | 0.00 / – | 0.61 / 0.85 |
计划延迟降到原来的 1/8.7 之后,剩下的延迟主要来自动作专家(每段约 160 ms)。在这些留出窗口上,Token-AR 从不输出结束码 d = 0;Block-AR 预测第一个航点的关节角误差从 0.156 rad 降到 0.112 rad,降低 28%。代价在 LIBERO 上:换成 Block-AR 后,四个套件的平均成功率比 Token-AR 低 0.85 个百分点,单个套件的差异在 +0.6 到 −1.4 个百分点之间。
忠实:怎么测执行器有没有在看计划
论文定义了两个互补的量,都在固定图像、语言、状态和 flow 噪声的条件下只改动航点:
- 敏感度 S:改动航点引起的动作变化,除以重新采样一次动作专家噪声引起的动作变化(按 RMS 计算,再对各段取中位数)。
- 效用 U:测试时擦除空间终点(把目标构型设为该段的起点状态)后,任务成功率下降多少个百分点;U > 0 表示擦除有害。
在 LIBERO-Long 的 64 个固定动作段上,用后缀 token 条件的 Block-AR,擦除终点引起的动作变化只有噪声基线的 0.6%;闭环中擦除全部终点后,成功率没有下降(U = 0.0)。这并不是因为动作专家对什么都不敏感:换主相机图像,动作变化为噪声基线的 281%;换语言指令为 158%;把时长加 4 步也有 19%。作者的解释是,动作专家同时能看到图像和语言的 K/V 表示,经验风险最小化并不强迫它通过航点来决定动作。
修:归一化目标调制(NGM)与“位移积分捷径”
最直接的修法是给目标一条通往动作专家每一层的深路径。作者发现,不加约束地注入(naive goal injection)会走向另一个极端。需要注意,论文中这个变体基于 Token-AR,而不是 Block-AR,因此它不是在上面的 Block-AR + 后缀条件系统上做的受控消融。原因在于:在示范数据里,相对目标 q − s 约等于动作专家要学的那段动作的积分,把它送进每一层等于把标签泄漏进条件,模型只要积分位移、不看图像,也能拟合训练损失。作者称之为“位移积分捷径”。此时终点敏感度升到 348%,对图像变化的响应只剩后缀基线的 27%,LIBERO-Long 成功率跌到 15%,失败全部是超时。所以敏感度高不等于计划被正确使用,两个量必须和完整计划下的成功率、对其他输入的响应一起读。
NGM 保留深路径,做法如下(第一项是深路径本身的构造,后两项是约束):
- 输入与注入:位移 q − s 按维度用鲁棒尺度归一化,拼接可学习的夹爪嵌入,经输出投影零初始化的 MLP 得到残差,加到每一层的 AdaRMS 条件上;初始化时模型行为与原来相同。
- 相位门控:只在去噪的粗阶段打开(t ≥ 0.5 全开,t ≤ 0.2 关闭),最后的精修留给动作专家看到的画面。
- 反捷径训练:训练时给终点加高斯噪声(归一化域中 σc = 0.7),并以 0.15 的概率替换为可学习的空嵌入;两种扰动同时作用于后缀 token 和深路径,否则未扰动的后缀会把标签原样带进来。推理时关掉噪声和 dropout,保留门控,不使用 classifier-free guidance。
| 系统(LIBERO-Long) | S 终点 | S 时长 | 图像响应保留 | 完整计划成功率 | U(百分点) |
|---|---|---|---|---|---|
| Block-AR + 后缀条件 | 0.6% | 19% | 100% | 91.0% | 0.0 |
| Token-AR + naive 注入 | 348% | 106% | 27% | 15% | +14 |
| Block-AR + NGM | 42.6% | 26.4% | 82% | 96.2% | +7.4 |
用 NGM 后,擦除终点使成功率下降 7.4 个百分点,说明执行器开始依赖计划,同时保留了大部分视觉响应。四个 LIBERO 套件的平均成功率从 95.85% 升到 98.45%,每个套件都有提升。作为参照,论文引用 OpenPI LIBERO 评测 README 中 π0.5 的平均成功率 96.85%;这一行是引用值,不是作者在同一训练设置下复跑的结果。
真机结果,以及和本站已有内容的关系
真机实验有三个双臂任务:在干扰物中把辣椒和香蕉放进两个盒子、交换两个盘子里的红绿辣椒、按颜色把物块放上货架。每个方法每个任务跑 20 次,由操作员判定成败:Token-AR 48/60,Block-AR 46/60,Block-AR + NGM 51/60。作者自己的表述是各方法成功率“相当”,这个样本量不足以支持几次成功之差的结论。真机上可以确认的收益在时间上:成功率相当,手臂处于运动状态的时间占比提高到原来的两倍以上。
本站的《前沿雷达专题|边缘与实时性:VLA 与世界动作模型的延迟预算花在哪里》按毫秒数梳理了多项材料的延迟预算;这篇论文补上的是分层系统中规划器解码这一环,并用运动占空比这个在真机上直接可见的指标来衡量。《前沿雷达专题|仿真与评测:VLA 评测在初始状态成功率之外缺了什么》讨论的是成功率之外的评测维度;本文的干预测试给出另一个维度:在输入固定的条件下只改计划,才能检验计划有没有被用上。VLA 的基本思路见课程《物理AI实验室 0.2:为什么是现在,数据、模型、算力三条曲线》。
局限 / 注意
- 这是 arXiv 预印本,以上数字都是作者报告的结果,本文依据的材料中没有独立复现,也没有代码仓库链接。
- Block-AR 和 NGM 只在一个从 π0.5 派生的分层结构上设计和验证:Block-AR 假设航点 token 组的格式固定,NGM 依赖 π0.5 动作专家的 AdaRMS 条件。作者明确说明,能否迁移到其他 VLA 骨干尚未测试。
- 每个模型变体只训练了一次,无法估计不同训练之间的波动;在 LIBERO 中,每个套件 1 个百分点对应 500 个 episode 中的 5 个。
- 真机只有 3 个任务、每个方法每个任务 20 次,作者也指出这限制了成功率估计的精度和对小差异的判断。
- 仿真中是整个计划执行完才重新规划,真机上执行完第一段就重新请求;占空比数字与这一设置有关。
- “时长不超过预测窗口”只保证请求的动作段能放进动作专家的输出长度(真机 30 Hz 下最多 1.07 s,LIBERO 20 Hz 下最多 1.6 s),不代表动作无碰撞或动力学可行。
链接
- arXiv 2609.30833:Fast Plans, Faithful Actions: Closing the Planning–Execution Gap in Hierarchical Vision-Language-Action Models(作者:Chuanliang Xie、Boyu Ma、Gen Li、Yizhou Liu、Houwang Chen、Xinyu Zhou、Jianfei Yang)
- 论文 HTML 全文


