モデルにプロンプトやルールファイルを書き直させ、変更のたびに評価を回し直すやり方は一種の山登り法ですが、方向を誤りやすいものです。失敗ケースの答えをそのまま貼り込んでも、チューニング用ケースの 1 件だけを直しても、スコアは上がります。EvalArc の evalarc hillclimb-run は、このループを代わりに回します。用意するのは 2 つのコマンドです。1 つはワークスペースを評価して Inspect AI、promptfoo、JUnit のいずれかの結果を書き出し、もう 1 つは変更を提案します。提案は通常、自分のキーでモデルを呼び出して行います。EvalArc 自体はモデルを呼び出しません。各コマンドが何を見て何を変更してよいか、そして各変更を残すかどうかを決めます。本記事では commit c3ed02f に固定したドキュメントとスクリプト化されたサンプルに基づき、サンプルの 5 回の反復を追いながら、各ステップの検査、出力物、終了コード、そして allow ガードが防げないことを説明します。
本サイトの EvalArc:スコアが上がったとき、エージェントはどこで退行したのか では 2 回の評価をチェック単位で比べる方法を、EvalArc のレポートフォルダーを引き渡す:入力の複製、記録されたオプション、evalarc verify で確認できる範囲 では hillclimb-review などのレポートをオフラインで再確認する方法を紹介しました。ドキュメントの言い方では、hillclimb-review は山登りのループを事後に監査し、hillclimb-run はそのループを実行時に回します。本記事が扱うのは後者です。以下の動作の説明はすべてプロジェクトのドキュメント([O]、プロジェクト自身の説明)に基づきます。本サイトではこれらのコマンドを実行しておらず、示したサンプル出力はドキュメントに保存されている結果です。
2 つのコマンドと 1 つの設定ファイル
サンプルの設定ファイル hillclimb.toml は次のとおりです。
workspace = "workspace"            # relative to this file
allow = ["rules.md"]               # globs the propose command may edit
held_out = "split.json"            # evalarc.case-split.v1
evaluate = ["{python}", "evaluate.py", "{output}"]
propose = ["{python}", "propose.py", "{iteration}", "{failures}"]
objective = "quality"              # or "cost"
max_iterations = 5
stall_after = 2
timeout_seconds = 60
どちらのコマンドも引数の配列として書き、シェルを介さずにワークスペース内で実行され、利用者の環境変数を引き継ぎます。プレースホルダーは {python} と {workspace}、evaluate 用の {output}(書き出す結果のパス)、propose 用の {failures}、{allowed}、{iteration} です。allow は propose コマンドが編集してよいファイルのグロブ、held_out はスキーマ evalarc.case-split.v1 のケース分割ファイルを指します。ドキュメントには cost_metric、max_cost_ratio、min_effect、result_suffix(.json、.xml、.eval)、format、threshold、leak_min_chars(12 と併記)、paste_check(true と併記)といったキーも挙げられていますが、個別の説明はないため、本記事では立ち入りません。
反復ごとに通る 5 つの関門
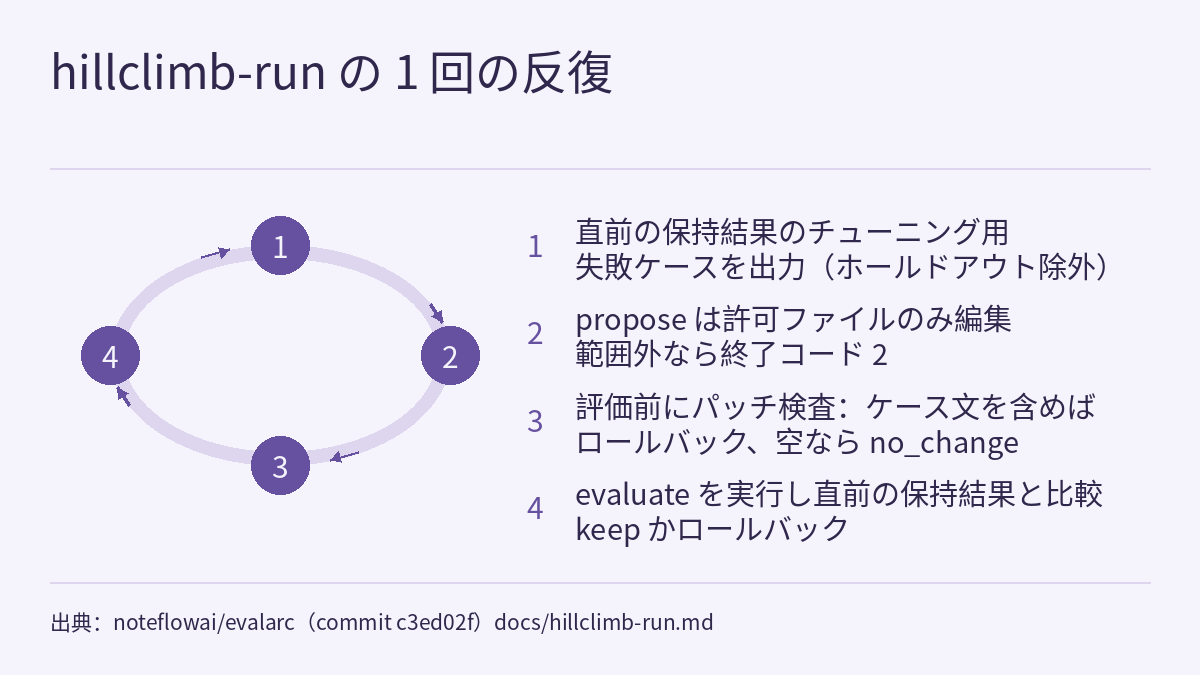
- 渡すのはチューニング用ケースの失敗だけ。 EvalArc は
steps/NN/tuning-failures.jsonを書き出します。中身は直前に保持した結果のうち失敗したチューニング用ケースで、入力、期待される答え、出力、採点器の根拠、トリアージ分類を含みます。ホールドアウトのケースは決して含まれません。 - propose が変更できるのは allow 内のファイルだけ。
allowの外にあるワークスペースのファイルを 1 つでも変更すると(.gitも含みます。無視されるのは__pycache__とツールのキャッシュだけです)、ループは許可ファイルを元に戻し、コマンドが作成したファイルを削除し、終了コード 2 で停止します。その際、変更された既存ファイルの名前を示すので、利用者が自分で元に戻せます。propose コマンド自体が失敗した場合、そのステップはpropose_failedになります。シンボリックリンクに置き換えられた許可パスは、保持している内容に戻されます。 - 評価の前にパッチを検査。 許可ファイルへの変更は
patch.diffとして保存されます。追加行にホールドアウトのケースの文が含まれていればrollback_leakage、チューニング用ケースの文が含まれていればrollback_pasted_caseとしてロールバックします。後者は、原因を直さずに失敗ケースを貼り込んだという意味です。検査対象はleak_min_chars文字以上の記録済み文字列だけなので、billingのような短い答えは検出されません。空のパッチはno_changeになります。 - 評価して直前の保持結果と比較。 最初の 3 つの関門を通ったときだけ evaluate が実行されます。結果は
hillclimb-reviewの規則に従ってkeep、rollback_regression、rollback_overfit、rollback_no_gainのいずれかに判定されます。ロールバックしたファイルは元に戻されます。 - 停滞時のトリアージ。 keep のない反復が
stall_after回続くと、残っているチューニング用ケースの失敗をトリアージします。チューニング用ケースで改善できる余地が識別可能な変化より小さければ、ループはstopped_below_noiseとして停止します。
関門 1 と関門 3 は対になっています。propose コマンドはチューニング用ケースの期待される答えを見られるので、いちばん安上がりな「修正」は答えをルールファイルに書き写すことです。関門 3 はそうしたパッチを、評価のコストをかける前にロールバックします。ホールドアウトのケースは失敗リストに入らず、パッチに現れることも許されません。だからこそ、その変化を見れば、変更がチューニング用ケースに合わせただけかどうかを判断できます。
サンプル:5 回の反復はそれぞれどの関門で決まったか
リポジトリのサンプルはチケット振り分けのワークスペースです。「エージェント」の workspace/evaluate.py は、rules.md に対応するルールがあるときだけチケットを正しく振り分けます。workspace/propose.py はモデルの代わりに、反復ごとに workspace/proposals.json から用意済みの編集を 1 つ追加します。モデルは呼び出されません。次の 3 行は本サイトが補った版固定の手順で、2 つのファイルには含まれていません。
git clone https://github.com/noteflowai/evalarc.git
cd evalarc
git checkout c3ed02f7fb2645c1b8651f16c11a47176c230736
ドキュメント自身のコマンドは cp -r examples/hillclimb-run /tmp/climb-example から始まります。ループはワークスペースを編集するため、先に複製します。
cp -r examples/hillclimb-run /tmp/climb-example
evalarc hillclimb-run /tmp/climb-example/hillclimb.toml --output runs/climb --trust-local
2 つのファイルにはインストール手順が書かれていません。固定コミットをチェックアウトしても固定されるのはサンプルとソースコードで、PATH 上の evalarc は固定されません。使う版が同じコミットのものかどうかは各自で確認してください。ドキュメントに保存されている出力は次のとおりです。
  1. keep (tuning +25.0 pp, held out +33.3 pp)
  2. rollback_pasted_case
  3. rollback_overfit (tuning +12.5 pp, held out +0.0 pp) — stalled
  4. no_change
  5. keep (tuning +25.0 pp, held out +50.0 pp)
Stopped: max_iterations | Kept: 05.json | Recommendation: merge| 反復 | 提案された編集 | 結果 | 決まった関門 |
|---|---|---|---|
| 1 | route refund -> billing | keep:チューニング用とホールドアウトの両方が改善 | 関門 4 |
| 2 | 失敗したチューニング用チケットを答えごと貼り込む | rollback_pasted_case、評価なし | 関門 3 |
| 3 | case t06 -> accounts、チューニング用ケース 1 件だけに合わせたもの | rollback_overfit、続いて停滞時のトリアージ | 関門 4、続いて関門 5 |
| 4 | 編集なし | no_change | 関門 3 |
| 5 | route outage -> oncall | keep | 関門 4 |
注目すべきは 3 回目の反復です。チューニング用は 12.5 ポイント上がり、ホールドアウトは 0 で、この変更はロールバックされました。2 回目と 3 回目は keep のない反復が 2 回続いたため stall_after = 2 に達し、出力には stalled と記されています。その後もループは 5 回目まで続き、停止理由は stopped_below_noise ではなく max_iterations でした。最終的に保持されたのは 05.json で、マージが推奨されています。
サンプルの README には続きの手順もあります。ベースラインと最終結果をペア比較のパケットにまとめ、スクリプト化された判定器で採点するものです。judge.py は出力と期待されるキューを比べるだけです。README は、実際の判定コマンドでは評価対象とは別のモデルを呼び出すことになると説明しています。
evalarc judge-packet pairwise runs/climb/results/00-baseline.json runs/climb/results/05.json \
  --output runs/ab
evalarc judge-run runs/ab --config /tmp/climb-example/judge.toml --output runs/ab-verdicts.json --trust-local
evalarc judge-score runs/ab runs/ab-verdicts.json --require-current-preferred
実行が終わったら何を見るか
- ワークスペースには最後に保持した版、
original/には開始時のファイル、final.diffには差し引きの変更が入ります。 hillclimb.json、summary.md、index.htmlは、評価したすべての結果を対象にしたhillclimb-reviewのレポートです。loop.jsonは失敗時も含めてすべてのステップを記録します。- 終了コード:0 はマージ推奨、1 は非推奨、2 は設定・コマンド・安全検査の失敗です。
終了コード 0 は、あくまでループが出したマージの推奨です。ドキュメントはマージ前に final.diff を確認するよう勧めています。ロールバックされたステップも loop.json に記録されているので、本サイトとしては保持されたステップと合わせて確認することを勧めます。
allow ガードはサンドボックスではない
2 つのコマンドはどちらも利用者の権限と環境でホスト上で実行されるため、--trust-local の指定が必須です。allow ガードは propose コマンドの実行前後でワークスペースを比較するだけで、コマンドを隔離しません。そのため、ワークスペース外の変更は見えず、既存ファイルへの編集を元に戻すこともできません。ドキュメントは、複製か、クリーンな git チェックアウトの上でループを実行すること、ホールドアウトのデータをワークスペースに置かないこと、マージ前に final.diff を確認することを勧めています。
本サイトから 2 点補足します。これはドキュメントの記述ではなく本サイトの提案です。第一に、2 つのコマンドは利用者の環境変数を引き継ぐため、環境にあるクラウドの認証情報は evaluate スクリプトからも見えます。モデルの呼び出しには、必要なモデル呼び出しだけに権限を絞った短期の認証情報を使い、権限エラーを権限の拡大で解決しないでください。第二に、ワークスペース内のファイルは propose コマンドに読まれ、リクエストとともにモデルへ送られる可能性があります。キーなどの機密ファイルはワークスペースの外に置いてください。
制約と注意点
- サンプルはスクリプト化されています。
propose.pyは宣言済みの 5 つの編集を再生するだけで、出力のポイント数はモデルの改善を測定した結果ではありません。本サイトはサンプルを実行しておらず、実際のモデルでこのループを試してもいません。 - ドキュメントは、出力のポイント数が直前の保持結果に対するものかベースラインに対するものかを説明しておらず、
rollback_overfitやrollback_no_gainなどの判定のしきい値もこのページには書かれていません。hillclimb-reviewの規則に従うとあるだけです。本記事ではどちらについても推測しません。 - 漏洩と貼り込みの検査は、追加行が記録済みのケースの文を含むかどうかを見るもので、対象は
leak_min_chars文字以上の文字列だけです。言い換えたケースを識別できるとはドキュメントに書かれていないため、完全な漏洩検出とみなすべきではありません。 - 本記事は commit
c3ed02fに基づきます。以降の版では、設定キー、判定名、終了コードが異なる可能性があります。